Base64 是加密吗?为什么不用密钥就能解开、中文变长、末尾还有等号
Base64 常被当成「加密」,但它的解码不需要任何密码:一段文字编码之后,直接粘回解码框就能还原。下面这些数值,都来自同一台机器(浏览器时区 Asia/Shanghai)在 宝塔拨测的 Base64 编码/解码工具 上的一次运行。
Base64 不是加密:同一串粘回解码框就还原
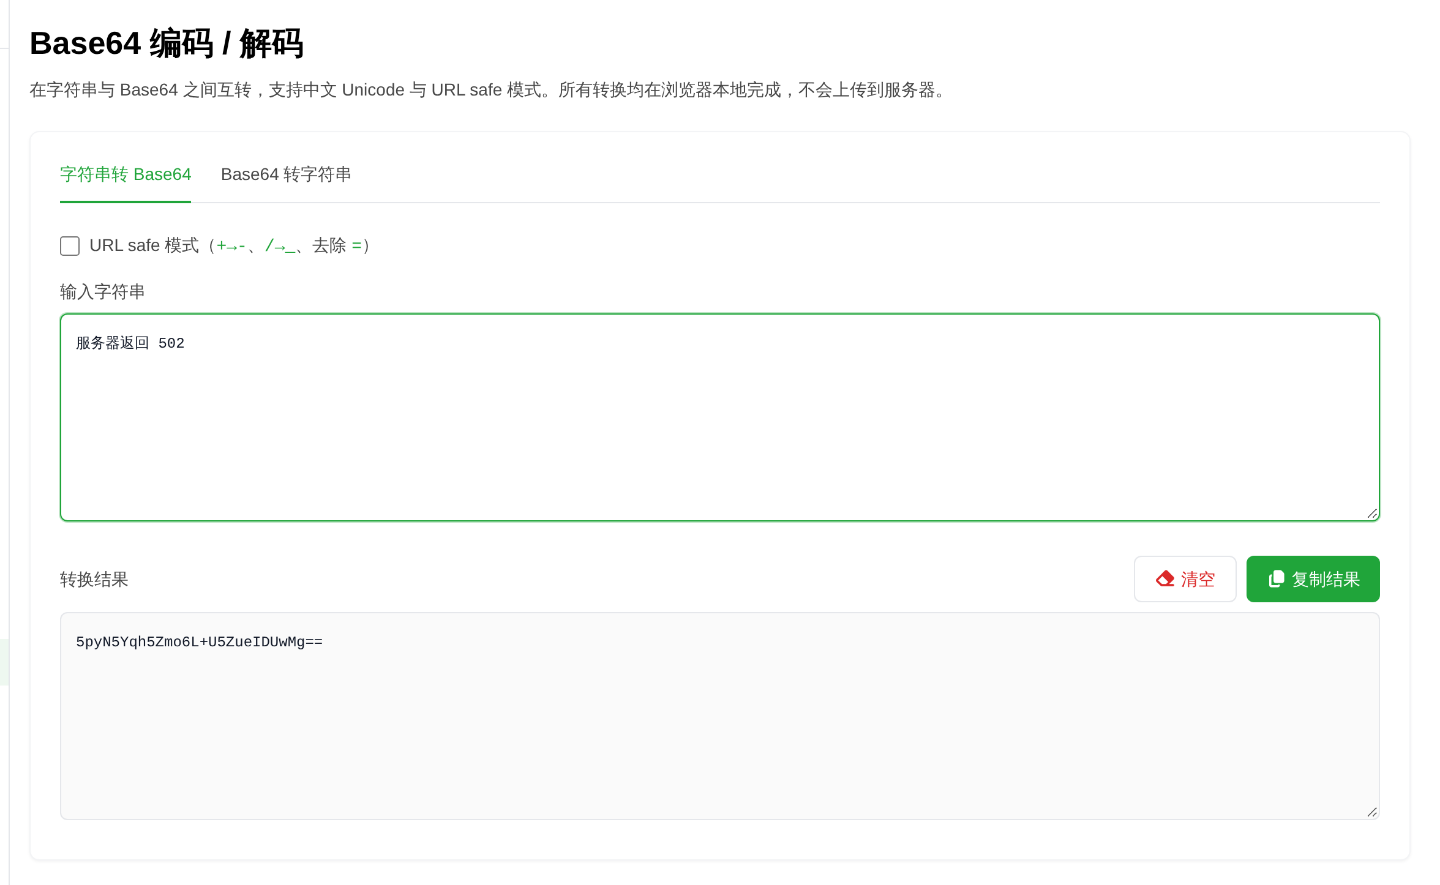
在「字符串转 Base64」页输入 服务器返回 502,转换结果立刻出来:
5pyN5Yqh5Zmo6L+U5ZueIDUwMg==
切到「Base64 转字符串」,把这一串原样粘进去,输出就是「服务器返回 502」:
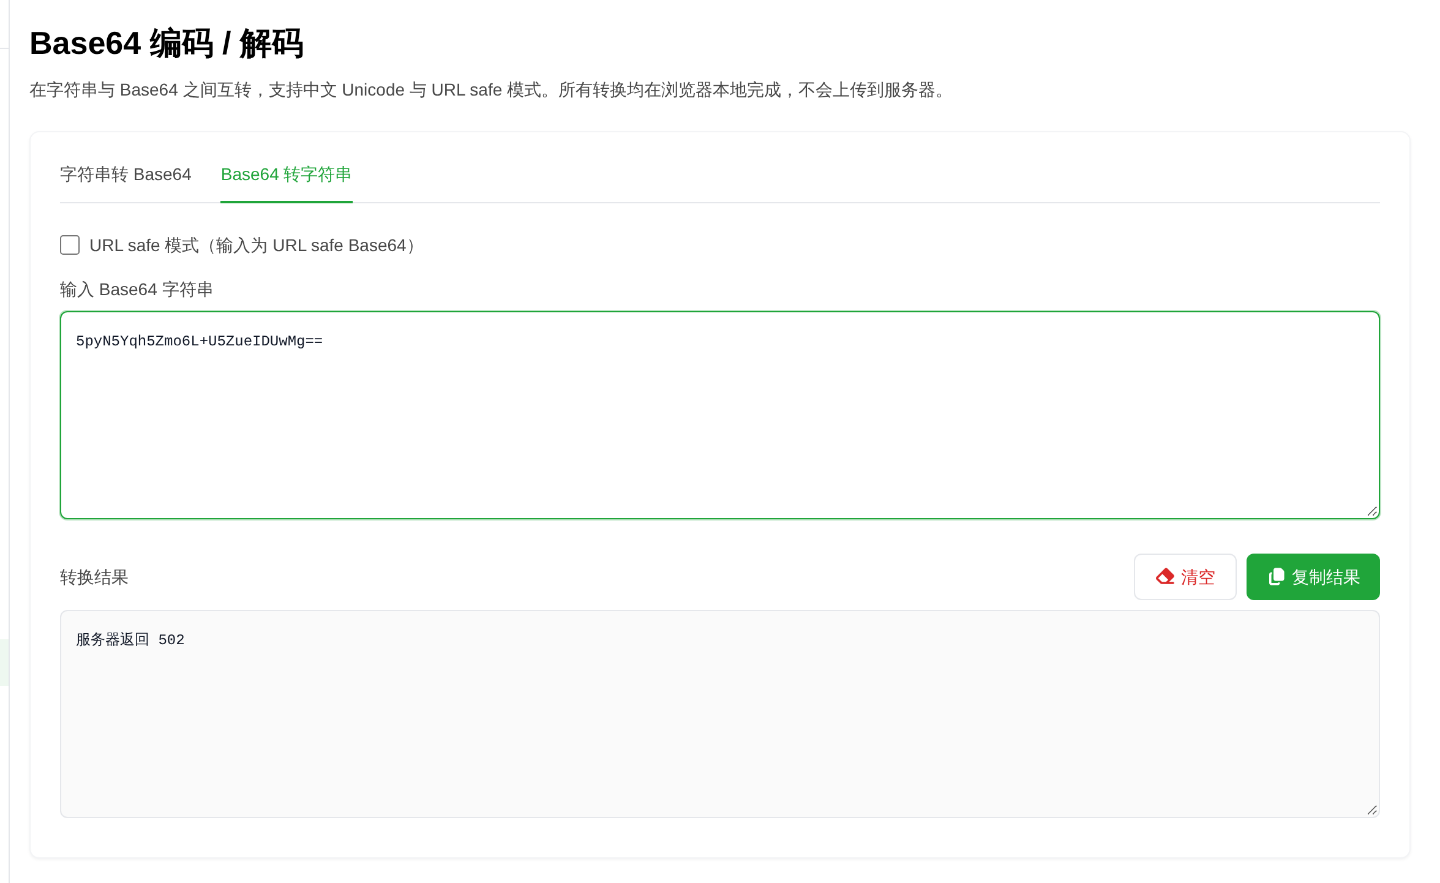
整个过程没有输入密码,也没有任何确认步骤。这就是编码与加密的差别:加密要靠密钥才能还原,Base64 只要求双方知道同一张字母表(A–Z、a–z、0–9、+、/)。
所以 Base64 不能用来存密码,也不能当成「加密后的密钥」发出去。HTTP Basic 认证就是典型例子——请求头把账号密码做一次 Base64 就发出,任何拿到请求的人都能解出来,真正保护它的是 HTTPS。
页面顶部注明转换在浏览器本地完成、不会上传服务器,这说的是这个工具不上传你粘贴的内容;它不代表 Base64 本身有保密性,拿到这串字符的人在别的工具里同样能解。
中文为什么变长:一个汉字 3 字节,编码后还要按 4/3 展开
实测两组:
宝塔拨测:4 个汉字,UTF-8 下 12 字节,编码结果5a6d5aGU5ouo5rWL,16 个字符测速✅:9 字节,编码结果5rWL6YCf4pyF,12 个字符
规则是每 3 个字节编成 4 个字符,所以长度约变成原来的 4/3(增加约三分之一)。汉字在 UTF-8 里通常是 3 字节,于是 4 个汉字正好 12 字节、编出 16 个字符。
这也解释了两个常见困惑:按「一个汉字算一个字符」估算会少算;接口里把中文塞进 Base64 字段,传输体积会比原文大,长文本尤其明显。
末尾的 = 是补齐用的,不是加密标记
服务器返回 502 是 19 字节,19 = 3×6 + 1:前 6 组各编 4 个字符,最后一组只剩 1 字节,于是补两个 =,结果 5pyN5Yqh5Zmo6L+U5ZueIDUwMg== 长 28 个字符。
反过来,12 字节和 9 字节都能被 3 整除,编码结果里一个等号都没有。所以「有等号 = 加密过」不成立,等号只跟原文长度能不能被 3 整除有关。
URL safe 模式:+ 变 -、/ 变 _、去掉 =
同一句「服务器返回 502」,标准输出里有一个 + 和两个 =。勾上「URL safe 模式」后变成:
5pyN5Yqh5Zmo6L-U5ZueIDUwMg
+ 换成了 -,末尾的 = 去掉了(这一步同时覆盖 / 换 _,因为标准字母表里的 62、63 号字符是 + 和 /)。
这么做的原因是 URL 和表单会吃掉这两个符号:+ 在 application/x-www-form-urlencoded 里会被解释成空格,/ 会和路径分隔符混在一起。RFC 4648 第 5 节给出 base64url 字母表,用途就是把结果安全地放进 URL、文件名或 JWT 这类场景。
解码时要对应勾上「URL safe 模式(输入为 URL safe Base64)」。不勾的话,这条 URL safe 串会被直接判为不合法:
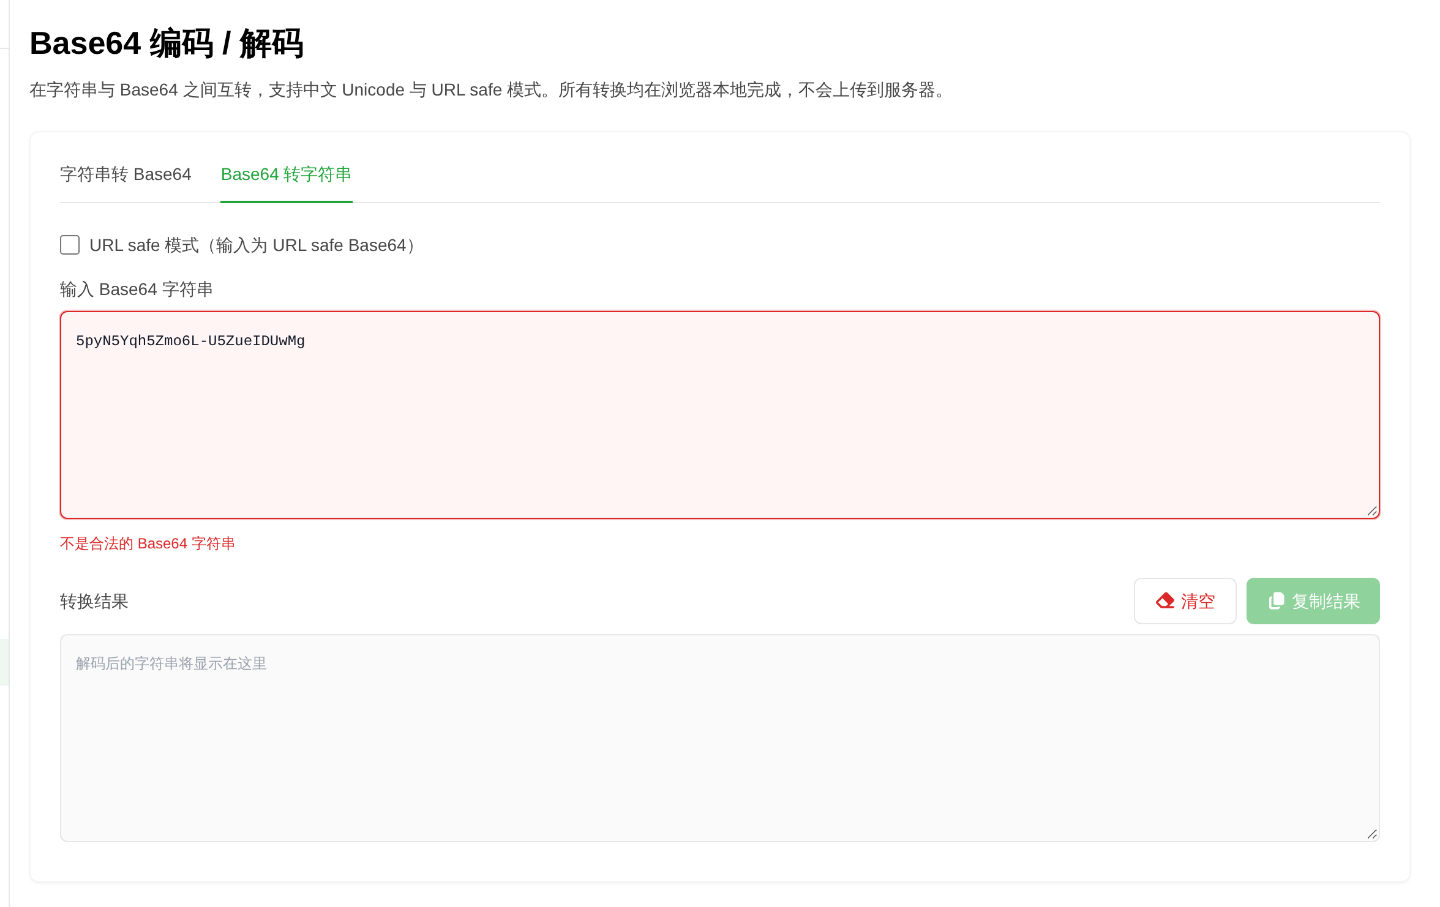
勾上之后,同一串就能还原出「服务器返回 502」。
解码报「不是合法的 Base64 字符串」的四种情况
实测这个工具对输入的校验比较严,以下四种都会直接报错、输出框留空:
- URL safe 串没勾选:
5pyN5Yqh5Zmo6L-U5ZueIDUwMg里带-,被判不合法 - 长度不合法:
5Lit5pa少一截,不是 4 的倍数 - 多补了等号:
5Lit5paH572R=正常应为5Lit5paH572R,多一个=就报错 - 中间混入换行:
5a6d5aGU换行5ouo5rWL,被当成含非法字符
部分解码器会自动忽略空白,但这个工具不做事先清洗,粘贴前先把换行、空格去掉;从邮件或日志里复制长 Base64 时尤其容易踩到。
解出来是 � 或乱码:字节不是 UTF-8,不是解码失败
输入 /w==,解码结果是一个替换字符 �。
/w== 还原出的字节是 0xFF,它不是合法的 UTF-8 序列。工具仍然按 UTF-8 去解释这些字节,遇到无法解码的位置就显示 U+FFFD(也就是 �)。这说明 Base64 只负责还原字节,不负责还原「文本」——字节原本是什么编码,解出来还得按那个编码读。
图片、压缩包、证书这类二进制内容,Base64 解出来本来就是乱码,属于正常现象;要还原成文件,应使用面向文件的转换方式,而不是文本解码框。
哪些地方真的在用 Base64
- HTTP Basic 认证:
Authorization: Basic dXNlcjpwYXNz就是把user:pass做 Base64(RFC 7617),可逆,必须靠 HTTPS 保护 - data URI:小图标内联进 HTML/CSS,形如
data:image/png;base64,... - JWT:header、payload、signature 三段都用 base64url,所以解析不用密钥;但签名段不验签就无法确认内容有没有被改过,解析出来不等于可信
三个场景的共同点是「换个能安全传输的写法」,不是「把内容藏起来」。搞清楚这一条,Base64 的等号、变长和乱码就都能解释了。
常见问题
Base64 能当加密用吗?
不能。实测把「服务器返回 502」编码成 5pyN5Yqh5Zmo6L+U5ZueIDUwMg==,切到解码页粘回去就原样还原,不需要密码、密钥或任何额外信息。加密需要密钥才能还原,Base64 只要知道字母表(A–Z、a–z、0–9、+、/)就能解,所以它只能改写法,不能保护内容。
Base64 末尾的等号是什么意思?
补齐 4 的倍数用的填充符,不是加密标记。「服务器返回 502」是 19 字节,19 = 3×6+1,最后一组只剩 1 字节,所以补两个 =,输出结尾是 ==。实测「宝塔拨测」12 字节、「测速✅」9 字节都能被 3 整除,输出里就没有等号。
URL safe 的 Base64 和普通 Base64 差在哪?
只差三个符号:+ 换成 -、/ 换成 _、去掉末尾的 =。同一句「服务器返回 502」标准输出是 5pyN5Yqh5Zmo6L+U5ZueIDUwMg==,勾上 URL safe 后变成 5pyN5Yqh5Zmo6L-U5ZueIDUwMg。解码时也要勾「URL safe 模式」,否则这一串会被判为不合法。
解码提示「不是合法的 Base64 字符串」是什么原因?
实测四种:URL safe 串没勾选对应选项、长度不合法(如 5Lit5pa 少一截)、多补了等号(如 5Lit5paH572R=)、中间混入换行(5a6d5aGU 换行 5ouo5rWL)。这个工具对长度和字符集都严格校验,粘贴前先去掉换行和空格。
为什么中文 Base64 编码后会变长?
因为先按 UTF-8 转成字节,再做 3 字节一组到 4 个字符的展开。一个汉字通常 3 字节,4 个汉字就是 12 字节,编码后是 16 个字符(5a6d5aGU5ouo5rWL);整体长度约变成原来的 4/3。
Base64 解码出来是乱码或 �,是解错了吗?
不是解码失败,是字节本身不是合法 UTF-8。实测输入 /w== 得到的是一个替换字符 �:0xFF 不是合法 UTF-8 序列,工具仍按 UTF-8 解释字节,就显示成 U+FFFD。Base64 只负责还原字节,图片、压缩包这类二进制内容解出来本来就是乱码。