URL 里的 %E4%B8%AD 是什么?中文变百分号、空格变 %20 的原因与还原方法
%E4%B8%AD 是「中」。把这三组百分号粘进宝塔拨测的 URL 编码/解码工具的解码框,输出就是这一个字。下面每个数值都来自 2026-11-08 在这个工具页上的一次运行,截图与文字同一次。
%E4%B8%AD 是「中」:一个汉字 3 字节,编码后 9 个字符
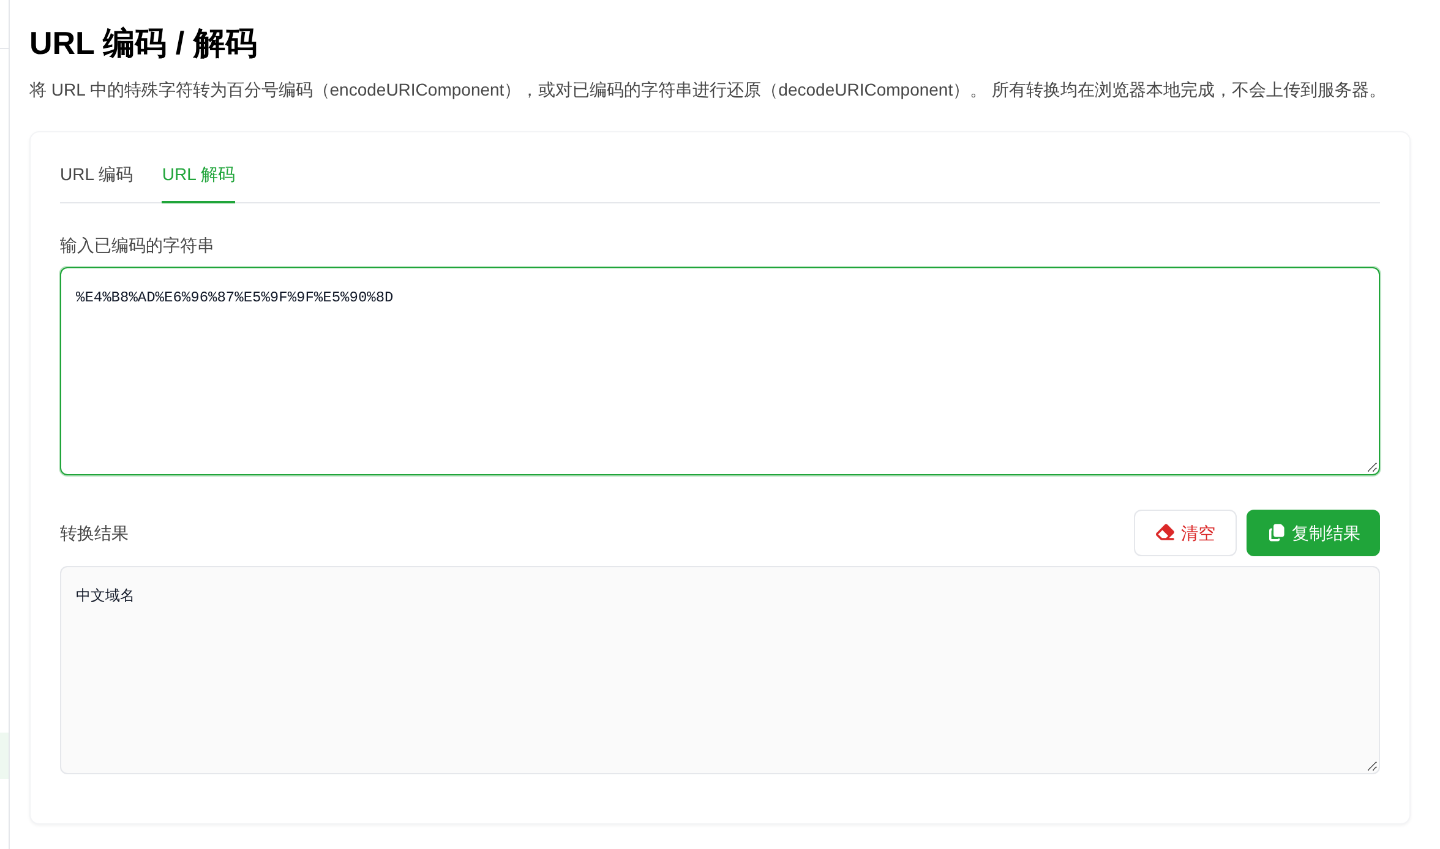
「中」的码位是 U+4E2D,UTF-8 编码成三个字节 E4 B8 AD。百分号编码的规则(RFC 3986 第 2.1 节)就是把每个字节写成 % 加两位十六进制,于是得到 %E4%B8%AD,长度从 1 个字变成 9 个字符。
四个字的情况一样:实测「中文域名」是 12 字节,编码结果 %E4%B8%AD%E6%96%87%E5%9F%9F%E5%90%8D 长 36 个字符,正好三倍。
带符号的字符串按字节累加:宝塔拨测 ✅ 是 4 个汉字 12 字节、1 个空格 1 字节、一个 ✅ 3 字节,共 16 字节,编出来 %E5%AE%9D%E5%A1%94%E6%8B%A8%E6%B5%8B%20%E2%9C%85,48 个字符。想把控长度,先算字节数而不是字数。
编码只该用在参数值上:整条 URL 编码,问号和等号也会被吃掉
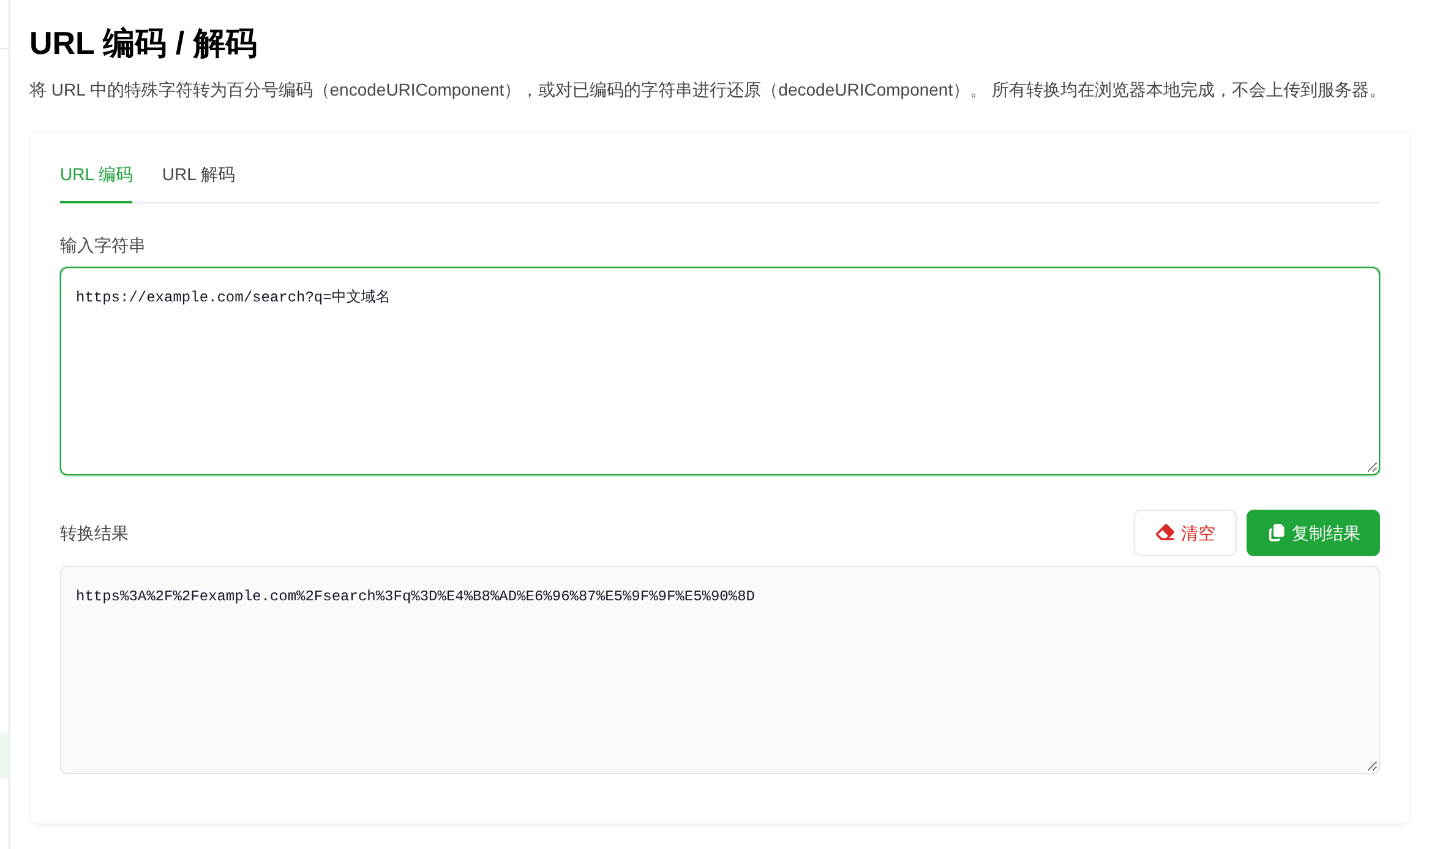
实测把 https://example.com/search?q=中文域名 整条丢进编码框,得到:
https%3A%2F%2Fexample.com%2Fsearch%3Fq%3D%E4%B8%AD%E6%96%87%E5%9F%9F%E5%90%8D
原文 41 字节,编完 77 个字符。: 变 %3A、/ 变 %2F、? 变 %3F、= 变 %3D——这些都是分隔符,被编码之后服务器只会把它当成一个长路径,不会再按 q 取参数。
同理 q=1&b=2 编成 q%3D1%26b%3D2,a#b 编成 a%23b——锚点也一起没了。所以正确做法是只编码参数的值,拼 URL 时自己把 ?、&、= 留在外面。
空格是 %20,不是 +:+ 只属于表单编码
同一个空格,两套规则给出两种写法,这是最容易搞混的一处。
- 实测输入
a b,输出a%20b - 实测输入
a+b,输出a%2Bb
也就是说这个工具走的是 encodeURIComponent 那套规则(工具页说明里直接注明了),空格一律 %20,加号本身还要被再编码成 %2B。
+ 代表空格来自表单提交:application/x-www-form-urlencoded 这种格式为了省事,把空格写成 +。所以从表单提交的日志里看到 q=hello+world,那是表单编码,不是这个工具的输出。
要还原这种值,粘进解码框只会得到 hello+world——实测加号原样保留,工具不会把它当空格。想拿回空格,得按表单规则自己把 + 换成空格,或者换用能解析表单格式的工具。
哪些字符不编码:字母、数字和 - _ . ! ~ * ’ ( )
实测输入 A-Z_a-z.0-9-!~*'(),输出与输入完全相同,18 个字节一个没变。
理由是这些字符在 URL 里不会引起歧义。RFC 3986 第 2.3 节定义的非保留字符是字母、数字和 - . _ ~;! * ' ( ) 这五个属于 JavaScript encodeURIComponent 历史上就没有编码的一批,规范上不算非保留字符,但同样不需要转义。
反过来说,中文、空格、引号、%、#、&、=、?、/ 这些都会被编。判断标准很简单:这个字符在 URL 里有没有结构含义,有就必须编。
编码两次:% 会变成 %25
% 自己也是要编码的字符,编出来是 %25。所以对已经编码过的字符串再编一次,就会套两层:
中文域名→%E4%B8%AD%E6%96%87%E5%9F%9F%E5%90%8D- 再编码一次 →
%25E4%25B8%25AD%25E6%2596%2587%25E5%259F%259F%25E5%2590%258D - 简单例子:
100%→100%25
实测把 %25E4%25B8%25AD 解码,得到 %E4%B8%AD;再解一次才得到「中」。
线上出现 %25E4%25B8%25AD 这种形态,说明这条值被编了两遍。常见来源是前端对已经带编码的参数又调了一次编码函数,或者后端把收到的值解码之后又重新编码回传。修法是让编码只发生在一处——拼参数的那一处,其余环节传原始值。
解码报「不是合法的 URL 编码」:% 后面少了两位十六进制
% 是转义引导符,后面必须紧跟两位十六进制,否则整串无法解析。实测以下三种都报同一句「无法解析此字符串:不是合法的 URL 编码」,输出框留空、输入框标红:
100%—— 末尾的%后面没有字符%E4%B8—— 只有两个字节,截断在多字节字符中间%ZZ——ZZ不是十六进制
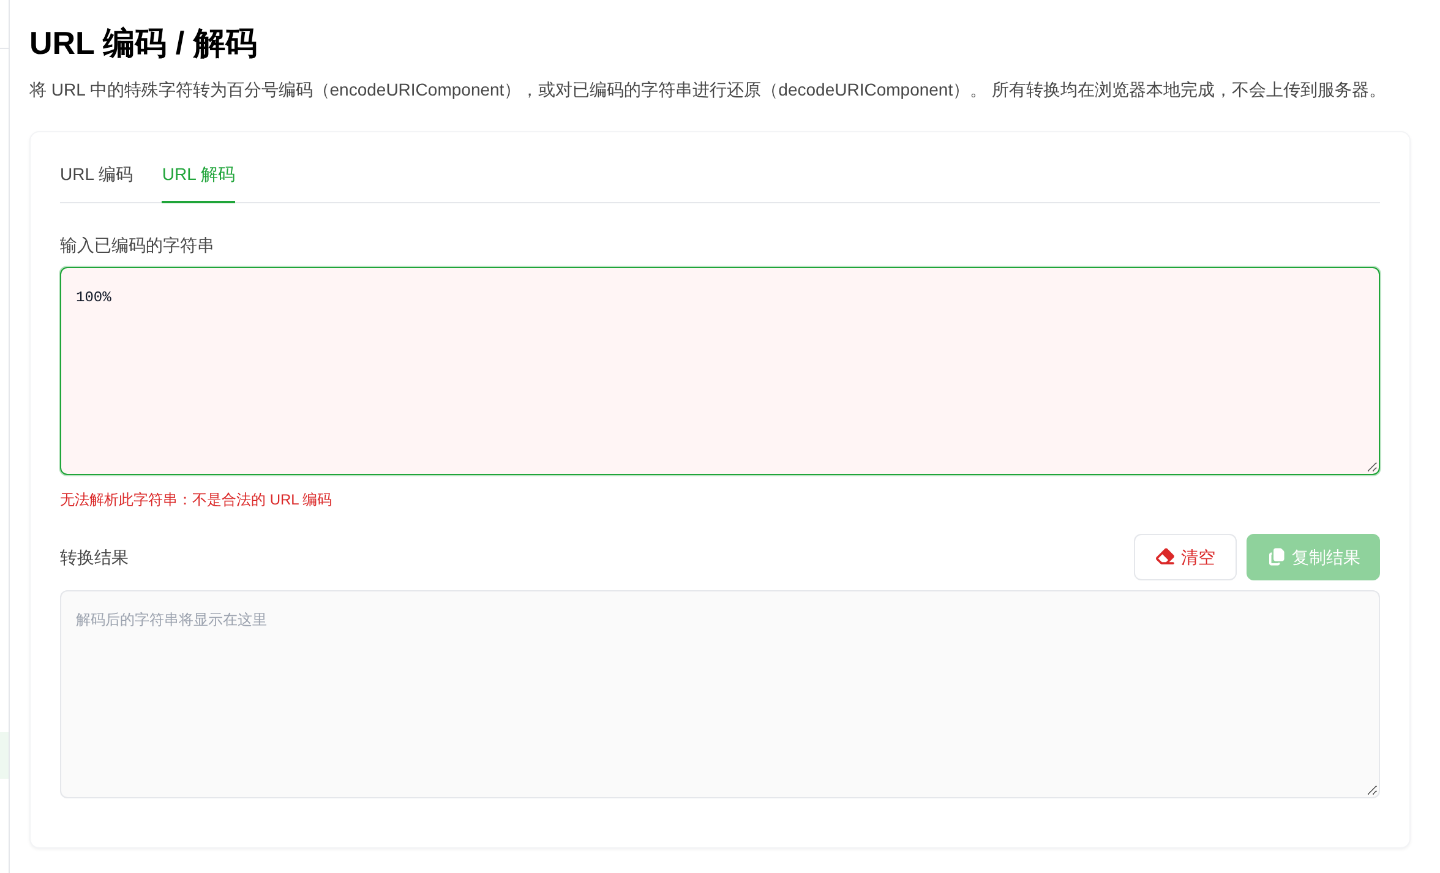
对应到现场,就是三类问题:从日志或聊天窗口里拷值时被截断(%E4%B8 这种半截)、手工拼 URL 时没编码(地址栏里出现 100%)、复制过程中中间的 % 丢了。修的时候先找那个孤立的 %。
大写小写都能解,输出统一是大写
百分号后面的十六进制大小写不敏感:实测 %e4%b8%ad 解码同样得到「中」。
但编码方向是确定的:实测这些编码用例的输出统一是大写 %E4%B8%AD,没有一例输出 %e4%b8%ad。两串在协议上等价,逐字节比较却会判成不同——做签名校验、缓存键、字符串去重时要注意先统一大小写,别把等价的值当成两个。
编码改的是写法,不是内容:解出来的还是原来那几个字。真正决定怎么解的,是这串值当初被谁编的——表单编的带 +,JS 编的空格是 %20,编过两遍的会出现 %25。
常见问题
%E4%B8%AD 是什么?
是汉字「中」。它在 UTF-8 里是 3 个字节 E4 B8 AD,按 RFC 3986 的百分号编码写成 %E4%B8%AD,共 9 个字符。把这三组粘进解码框,实测输出就是「中」;反过来输入「中」,编码结果也是 %E4%B8%AD。
URL 里的空格是 %20 还是 +?
这个工具编码空格输出 %20。实测输入 a b 得到 a%20b,输入 a+b 得到 a%2Bb。+ 代表空格只是表单提交(application/x-www-form-urlencoded)的约定,不适用于这里:把 hello+world 粘进解码框,实测输出仍是 hello+world,加号没有被还原成空格。
中文 URL 编码后为什么长度变成三倍?
编码先把文字按 UTF-8 转成字节,再把每个字节写成 % 加两位十六进制。一个汉字通常 3 字节,编完就是 9 个字符。「中文域名」4 个字是 12 字节,实测编码结果 %E4%B8%AD%E6%96%87%E5%9F%9F%E5%90%8D 长 36 个字符,正好三倍。
解码提示「无法解析此字符串:不是合法的 URL 编码」是什么原因?
百分号后面必须紧跟两位十六进制。实测三种都会报这句、输出框留空:100%(% 后面没有字符)、%E4%B8(只有两个字节,截断在多字节字符中间)、%ZZ(不是十六进制)。从日志里拷值时被截断、手工拼 URL 时漏编码,都会出现这个提示。
%25E4%25B8%25AD 又是什么?
是编码了两次的结果。% 本身会被编码成 %25,所以 %E4%B8%AD 再编一次就是 %25E4%25B8%25AD。实测解码一次得到 %E4%B8%AD,再解一次才得到「中」。看到 %25 就说明这条值被编码了两遍。
整条 URL 可以直接丢进去编码吗?
不建议。实测 https://example.com/search?q=中文域名 整条编码后变成 https%3A%2F%2Fexample.com%2Fsearch%3Fq%3D%E4%B8%AD%E6%96%87%E5%9F%9F%E5%90%8D,冒号、斜杠、问号、等号全被吃掉,服务器拿到的只是一个长路径而不是带参数的地址。应该只编码参数的值。