XML 报 not well-formed 怎么查?格式化定位错误标签、压缩与命名空间
浏览器里打开一个 XML 文件,看到「XML 解析错误」或者 not well-formed,第一种反应通常是「文件坏了」。实际上绝大多数情况不是数据丢了,而是格式上有一处不合规:标签没闭合、有两个根节点、属性值忘了加引号、正文里有个没转义的 &。这类错误的共同点是——解析器读到出错位置就停下,不给你「大概哪里有问题」的提示。
宝塔的 XML 格式化工具做的就是两件事:先用浏览器自带的 XML 解析器检查格式,再把合法内容展开成带缩进的树形。下面用本机真实运行的结果,讲清报错该怎么读、压缩和格式化分别改了什么。
not well-formed 是什么错:格式没过,还没轮到内容
XML 解析分两道关:格式合规(well-formed)和结构合法(valid)。第一道关只看语法,合规则任何人拿到都能读;第二道关要拿 DTD 或 XSD 去比对字段,属于业务层面。
not well-formed 卡在第一道关,报错信息里一般会带上出错的行号和列号。工具页用的是浏览器原生解析器,页面上也写明了「所有操作均在本地完成,不会上传到服务器」,所以报错措辞就是浏览器自己的那套,读的时候认准 line 和 column 两个词即可。
格式化:一行展开成缩进树形,报错指到具体行列
把一段挤成一行的 XML 粘进去,点「校验 / 格式化」,工具会先解析、再把结构按 2 个空格缩进展开。实测输入 147 字节的一行内容:
<config><site domain="www.example.com" port="80"><root>/www/wwwroot/example</root><ssl enabled="true"></ssl></site><cache driver="redis"/></config>输出变成 8 行、共 203 字节,每一层嵌套一眼能看出从属关系:
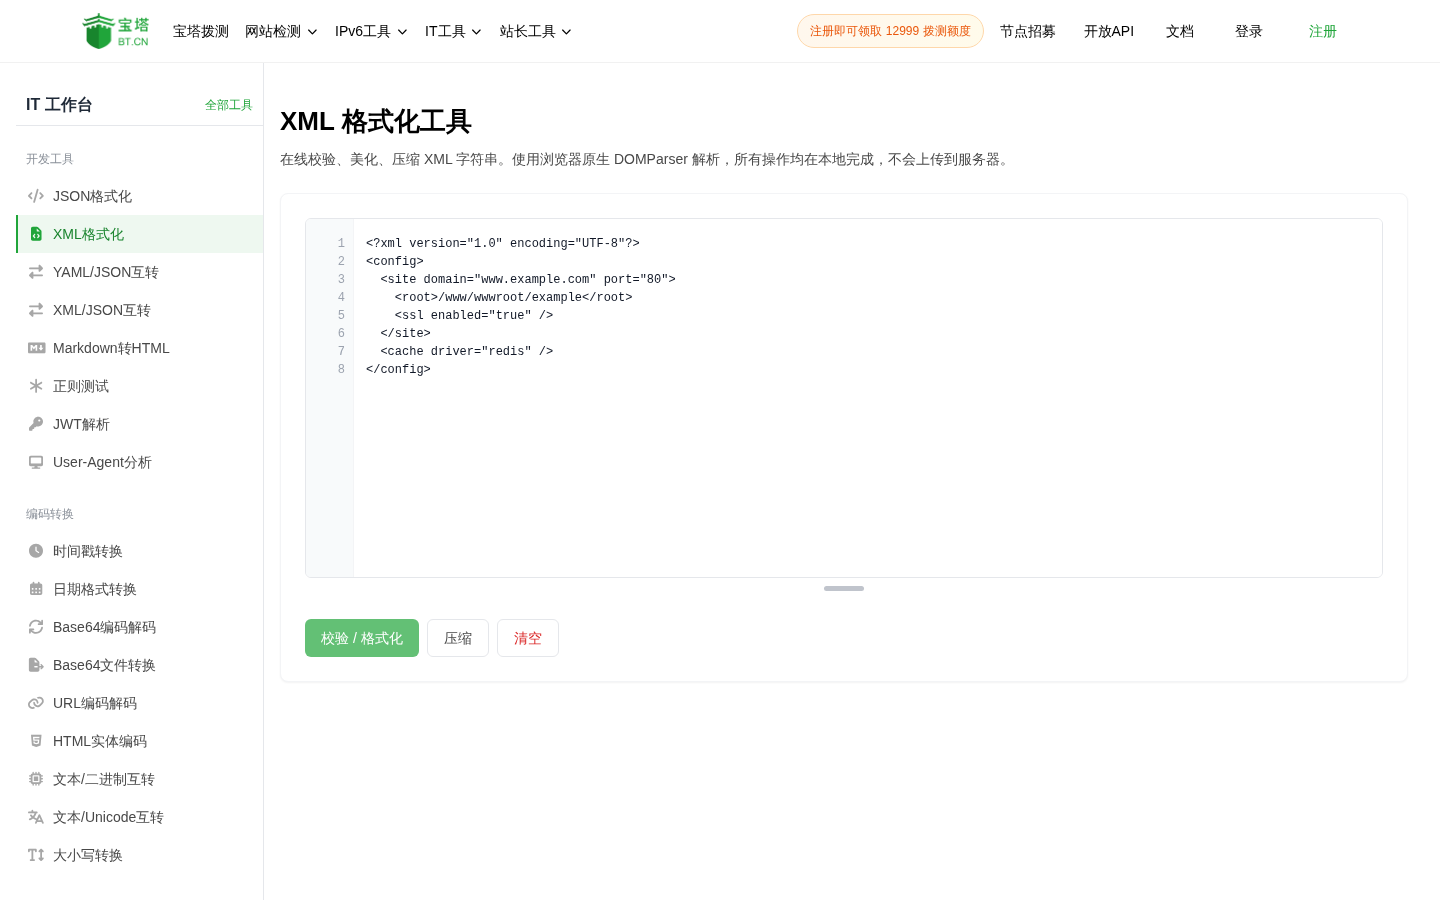
从这次结果里能看到三个固定行为:
- 缺声明就补一行。原文没有
<?xml ... ?>,输出自动补上了<?xml version="1.0" encoding="UTF-8"?>;已经有声明的不会重复加。 - 空元素收成自闭合。
<ssl enabled="true"></ssl>输出成<ssl enabled="true" />,<cache driver="redis"/>输出成<cache driver="redis" />(斜杠前多了一个空格)。两者在 XML 里完全等价。 - 换行和缩进是重排出来的。所以格式化后体积会变大,但解析出的结构一模一样。
四类最常见的格式错误,报错长什么样
同样是「标签有问题」,解析器给的措辞不一样。下表四行的输入和报错都是本机实测结果(报错只取浏览器原文的关键句),列号随输入长度变化,指的都是出错的那个字符位置:
| 你写的输入 | 报错(节选) | 问题所在 |
|---|---|---|
少一个结束标签 </site>,直接写成 ...</root></config> |
error on line 1 at column 81: Unexpected closing tag: config != site |
!= 两边就是「期望 vs 实际」,直接告诉你 config 和 site 没配上 |
<a>1</a><b>2</b> 两个根节点 |
error on line 1 at column 9: Unexpected token: < |
XML 只允许一个根元素,多出来的那个 < 就是罪魁祸首 |
<r a=1> 属性值没加引号 |
error on line 1 at column 6: Unexpected token: 1 |
属性值必须用引号包起来,裸写数字也不行 |
<a>A & B</a> 正文里有裸 & |
error on line 1 at column 7: Unexpected token inside entity |
& 是实体起始符,要写成 & |
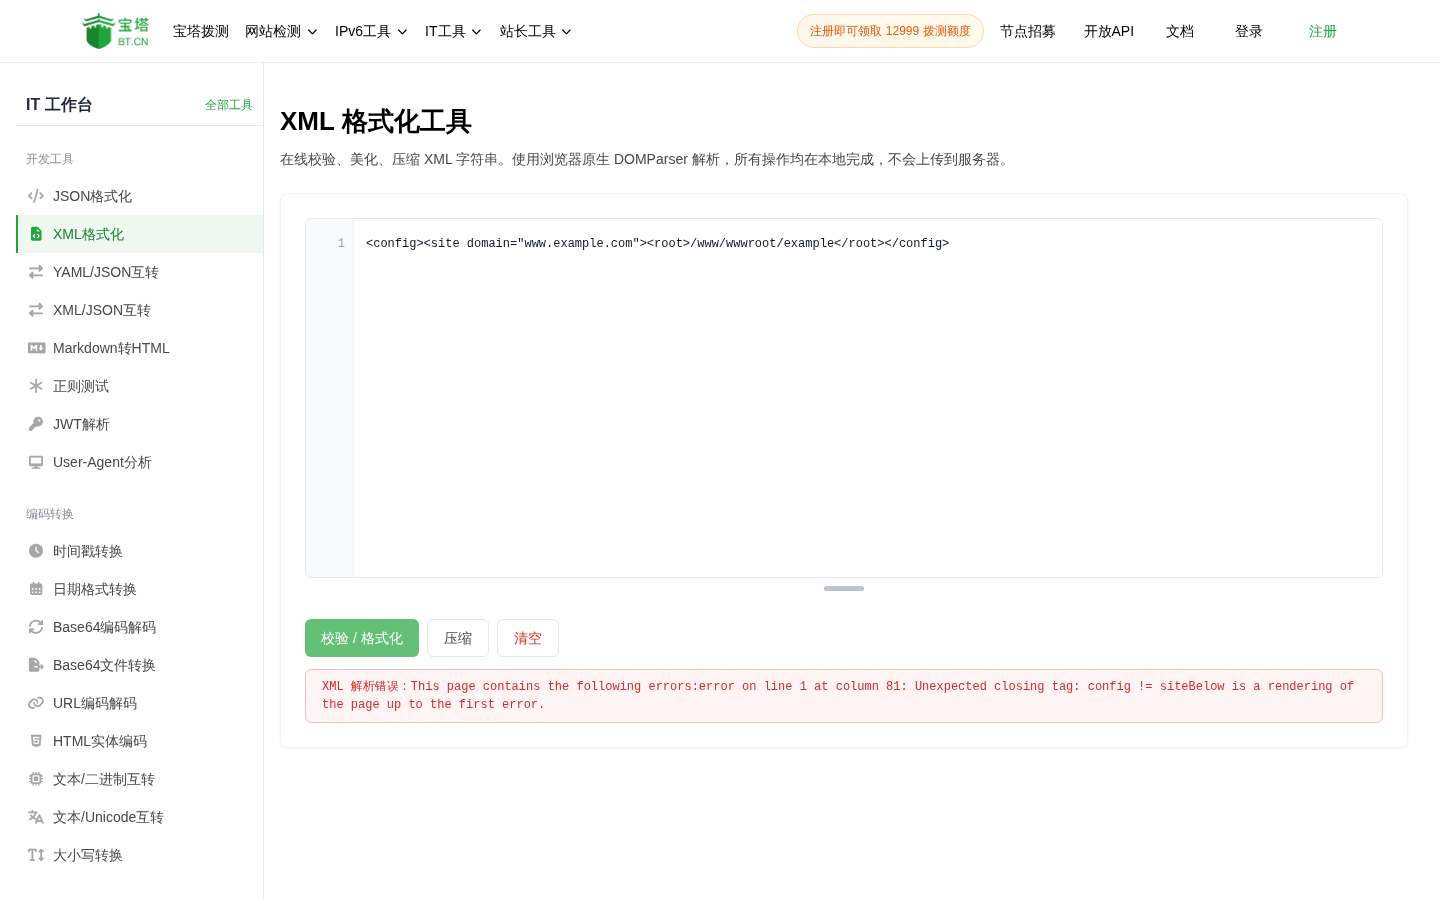
读这类报错有个省时间的顺序:先看 != 或 Unexpected 后面提到的标签名,再看列号。列号对一行压缩的 XML 意义不大(一行就是几百个字符),但标签名往往直接点名了问题。比如上面的 config != site,意思是解析器在 </config> 这里等的是 </site>——往前翻,<site> 少了闭合。
压缩:只删纯空白,不动文本内容
反过来,把带缩进的内容压成一行,点「压缩」即可。实测上面那段 203 字节的格式化结果,压缩后是 180 字节,少了 23 字节,约 11%。
压缩的边界值得记一下,因为它跟很多人的直觉不同:
- 纯空白的文本节点会被整段删掉。
<b> </b>压缩后变成<b/>。 - 文本里的内容不删。
<a> hello </a>压缩后仍是<a> hello </a>,首尾空格还在。 - CDATA 段原样保留。
<c><![CDATA[x < y]]></c>压缩后一个字符都不变,CDATA 里的<不需要转义。 - 标签之间的换行和缩进是删干净的那部分,这也是省下 23 字节的来源。
所以压缩适合两类场景:把 XML 塞进请求体、写进日志单行记录、或者放进只接受一行的配置字段。它不会把 5KB 的文件变成 1KB——省的是排版空白,不是数据。
注意压缩和格式化对空白的处理方向相反:格式化会去掉文本节点首尾的空格(<a> hello </a> 变成 <a>hello</a>),压缩不会。同一段内容走两个按钮,文本首尾的空白结果不一样——如果这段文本参与签名或摘要,处理完要核对。
命名空间 xmlns:顺序会变,内容不会丢
带命名空间的 XML(RSS、SOAP、Android 布局文件里很常见)格式化后,xmlns 声明仍会保留,但属性顺序可能被调整。实测输入:
<rss version="2.0" xmlns:dc="http://purl.org/dc/elements/1.1/"><channel><title>bt</title><dc:creator>btprobe</dc:creator></channel></rss>格式化后 <rss> 上的属性变成了 xmlns:dc 在前、version 在后,<dc:creator> 这个带前缀的标签原样保留。原因是浏览器 DOM 把命名空间声明当特殊属性处理,序列化时会先输出它们。
这不会造成问题:XML 规范里属性本身没有先后语义,解析器按名字取值,不按位置。只有当你拿格式化结果和原文做逐字 diff 时,才会看到这处差异——别把它当成「工具改坏了」。
编码声明会被改写成 UTF-8
这条是实际踩过才知道的:声明里写 encoding="GBK" 的 XML,格式化后声明会变成 encoding="UTF-8"。实测输入 <?xml version="1.0" encoding="GBK"?><r><a>1</a></r>,输出第一行就是 <?xml version="1.0" encoding="UTF-8"?>。
工具在浏览器里按 Unicode 处理文本,输出的声明统一写 UTF-8 是自洽的。但如果原文件真是 GBK 编码,你把结果复制回去保存时要注意按 UTF-8 存,否则文件字节是 GBK、声明写 UTF-8,别的程序打开就乱码了。
XML 和 JSON 该用哪个
同一个数据结构两种写法,选哪个看使用场景,不看喜好:
- XML:需要属性(
<site port="80">)、需要命名空间区分来源、需要混合内容(一段文字里夹标签)、或者对接的系统只认 XML(SOAP 接口、pom.xml、web.config、Android 布局、RSS / sitemap)。 - JSON:接口传输大多数情况用它,体积更小(没有成对的结束标签)、类型直接对应数字/布尔/null、主流语言的解析库开箱即用。
两者要互转时,属性怎么映射成键、只有一个子元素时该是对象还是数组,这些歧义需要人工决定——用 XML/JSON 互转工具能看到转换后的实际结构,再判断要不要调整。
用法:粘贴、校验、按需压缩
- 打开 XML 格式化工具,把 XML 内容粘进输入框(左侧带行号);
- 点「校验 / 格式化」,格式有问题会在下方红框里报出错行和列,按标签名回溯修;
- 格式通过后内容会被自动展开成缩进树形,这时再复制走;
- 需要一行形态就点「压缩」,要清空重来点「清空」。
整个过程在浏览器本地完成,内容不会上传。日常排查 XML 报错时,先过一遍格式校验,比对着报错翻文件快得多。
常见问题
not well-formed 和 XML 不合法是一回事吗?
不是一回事。not well-formed 说的是格式不合规——标签没配对、有多个根节点、属性值没加引号、出现未转义的 & 或 <,这类问题任何 XML 解析器都会直接拒绝。而合法(valid)指的是内容符合某份 DTD 或 XSD 规定的结构,比如某个字段必须是数字、某个子节点必须存在。格式化工具只检查前一种,格式对了它就放过,不会去校验字段结构是否符合你的业务约定。
格式化会改我的数据吗?
会改空白,不会改内容。实测把 <a> hello </a> 格式化,输出是 <a>hello</a>——文本节点首尾的空格被去掉了(缩进本身需要重排空白);但文本中间的空格会保留,多 空格 原样不动。所以对文本首尾空格本身有含义的场景(比如签名、摘要、定长字段),格式化后要人工核对一遍。
压缩能省多少体积?会删掉什么?
压缩只删纯空白的文本节点和标签之间的换行缩进。实测一段 203 字节的缩进 XML 压成一行后是 180 字节,少了 23 字节,约 11%。文本里的内容不受影响:<a> hello </a> 首尾空格保留,而 <b> </b> 这种只有空白的节点会被压成 <b/>,CDATA 段原样保留。
XML 里能写注释吗?注释会被保留吗?
能,写法是 <!-- 说明 -->。格式化时注释会被保留并单独占一行,实测 <r><!-- 节点说明 --><a>1</a></r> 格式化后注释仍在原位。要注意注释里不能再出现 --,否则同样会报格式错误。
xmlns 是什么?为什么格式化后属性顺序变了?
xmlns 是命名空间声明,用来区分同名但来源不同的标签,比如 RSS 里的 dc:creator 靠 xmlns:dc="http://purl.org/dc/elements/1.1/" 才能被识别。实测格式化后 version 和 xmlns:dc 的先后顺序会变,命名空间声明被提到了前面。XML 规范里属性本身是无序的,顺序变化不影响解析结果,只是和原文逐字对比时看着不一样。
GBK 编码的 XML 粘进去会不会乱码?
工具的语法检查不依赖声明里的编码,但输出的声明会被统一改写成 <?xml version="1.0" encoding="UTF-8"?>。实测一份声明为 GBK 的文件,格式化后声明变成了 UTF-8。所以如果原文件真是 GBK 编码,改完记得按 UTF-8 保存回文件,否则声明和实际字节对不上,别的程序打开会乱码。