网页测速报告先读什么?多节点拨测还原真实加载差异
第一眼先看总时长
拿到报告,多数人习惯扫一眼最大的那个数字,然后判断「快」或「慢」。我以前也这样,直到有一次报告显示整体很快,用户却根本打不开——因为那一列里很多节点返回的是错误页,只是耗时很短。
总时长是结论,不是入口。先确认这份报告可信,再读它。
第一步:这份结果有效吗
看状态码。200 不代表内容对,但 5xx、403、404 一定说明请求没有正常完成。
看返回内容。有些节点返回的是拦截页、默认页或者 CDN 的错误页,耗时可能很短,却不代表站点正常。
看有多少节点真的参与了。列表里一堆超时,平均值只代表剩下那几个节点,结论的适用范围要跟着缩小。
这三项不过关,后面的数字都不用看。还有一种情况:结果里只有一两个节点有数据,其余全超时。这种报告只能说明那一两个节点的情况,别当成全网结论。
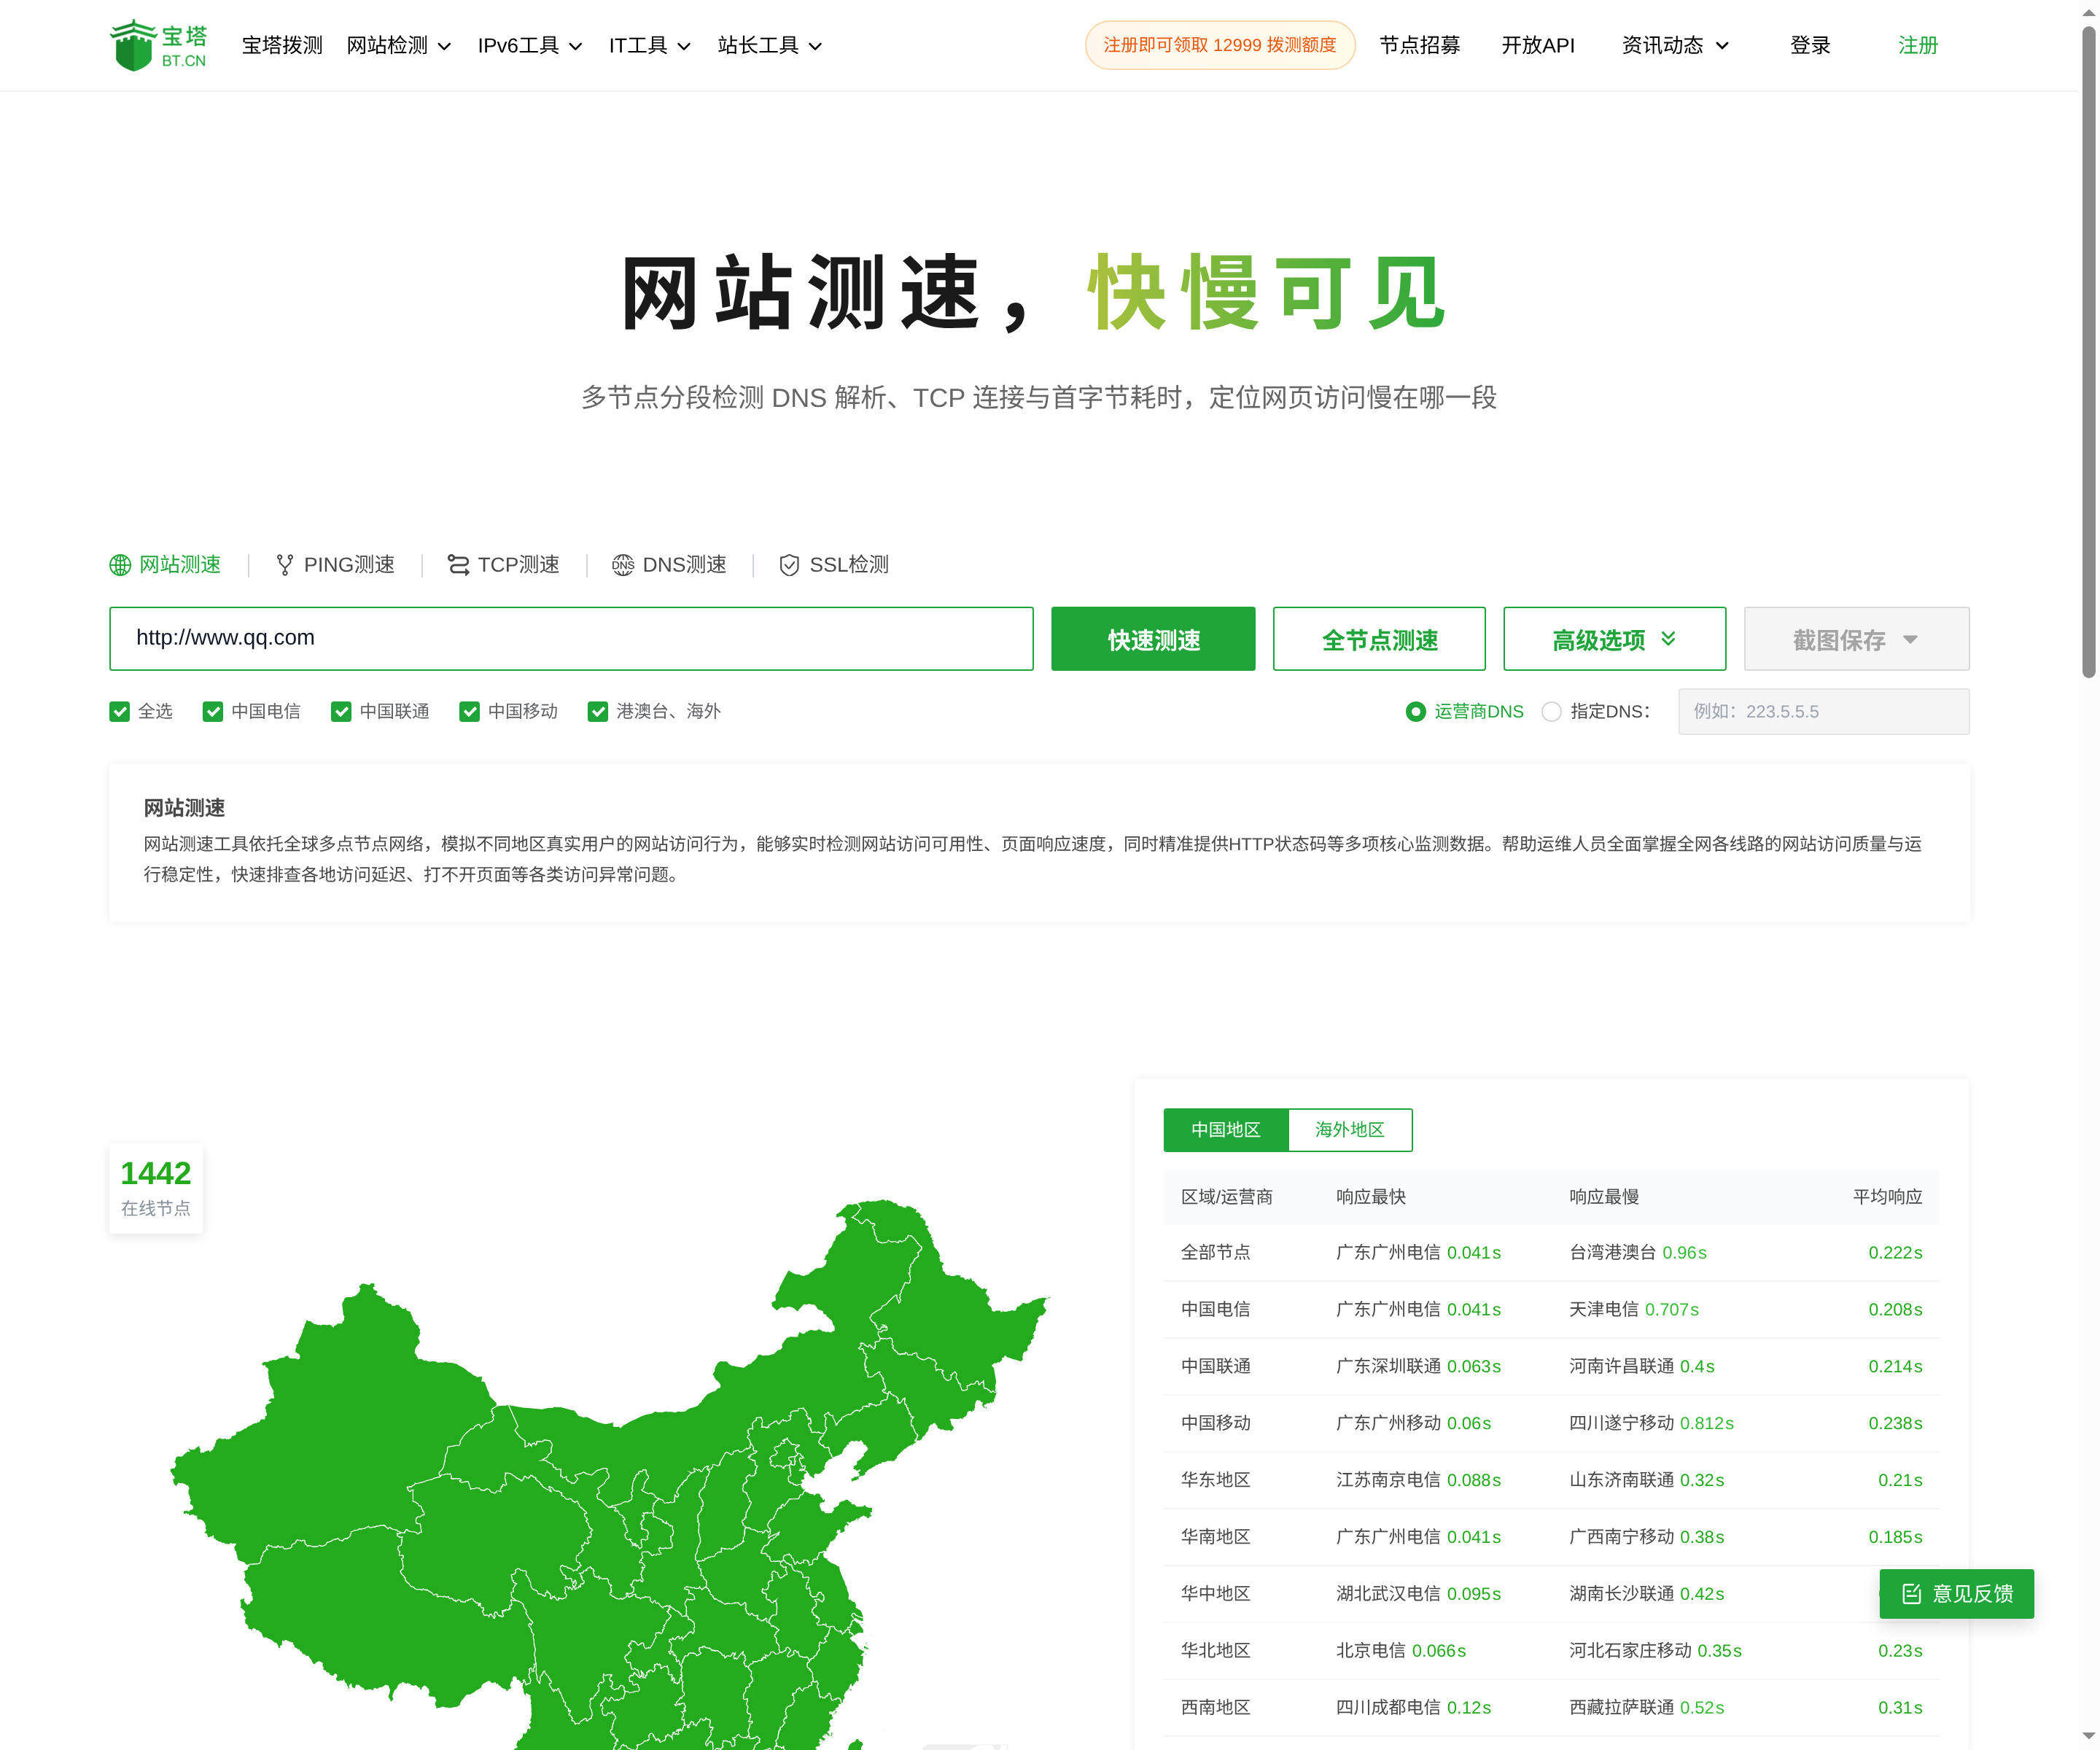
网站测速:多站点分段耗时与状态码
第二步:看分布,不看单点
在宝塔拨测的网站测速的结果页里,平均、最快、最慢摆在一起。最快和最慢差得大,说明不同地区的体验差距明显,平均值意义不大。
按地区和运营商分组,能找到那条边界:是全国都慢,还是某个运营商、某个区域慢。这一步决定你后面查线路还是查服务器。
如果最慢节点只比最快慢一点点,说明整体一致,平均值可以参考;差距一大,就必须以分组结果为准。
节点覆盖也要对一下。用户主要在哪些省,那些省的节点在不在结果里。
第三步:拆分段
到这一步才看五段:DNS、TCP、TLS、TTFB、下载。
看占比,不看绝对值。跨地区的 DNS 和 TCP 天然有差异,TTFB 才是后端处理的核心指标,下载段反映资源和带宽。
某一段占了总时长的大头,优化方向就在那一段。均匀分配的那种,多半是整条链路都不理想。
分段相加不一定严格等于总时长,中间还有排队和重定向的时间,差一点别急着认为数据错了。
第四步:才谈改什么
定位到段,再决定动哪里。DNS 长查解析,TCP 长查线路,TLS 长查证书和协议,TTFB 长查后端,下载长查资源和带宽。
不定位就动手,最常见的结局是改了半天,总时长没变。
复测和留基线
改完用同一批节点复测,看同一段有没有下降。节点换了,前后就没有可比性。
把每次的报告留一份,标上时间和变更内容。下次出问题,你能直接对照,而不是凭印象说「以前挺快的」。
报告本身也有保质期。半年前的数据只能做趋势参考,别拿来当今天的基线。
读报告的顺序稳定了,判断才不会来回摇摆。
