端口连接时好时坏?多节点拨测先分清是网络还是服务器
「一会能连一会不能」
用户报障,我连上去试了一下,通的。再试一次,还是通的。于是回复「目前正常」。
第二天又来了。这种「时好时坏」的问题,单次测试永远抓不到,必须靠连续观察。那次之后我学会了先跑一段数据再回话。
先把它变成数据
用连续测速,对同一端口按固定间隔跑一段时间。
记录每次的成功、失败、握手耗时。跑够样本,才有资格谈规律。间隔太稀会漏,太密会产生大量无用数据。
失败类型也要区分:拒绝是立刻失败,超时要等很久。两者混在一起统计,会掩盖真相,分开记规律更清楚。
在宝塔拨测的 TCP 测速里选持续测速,从多个节点同时跑,比自己在本地反复试靠谱。
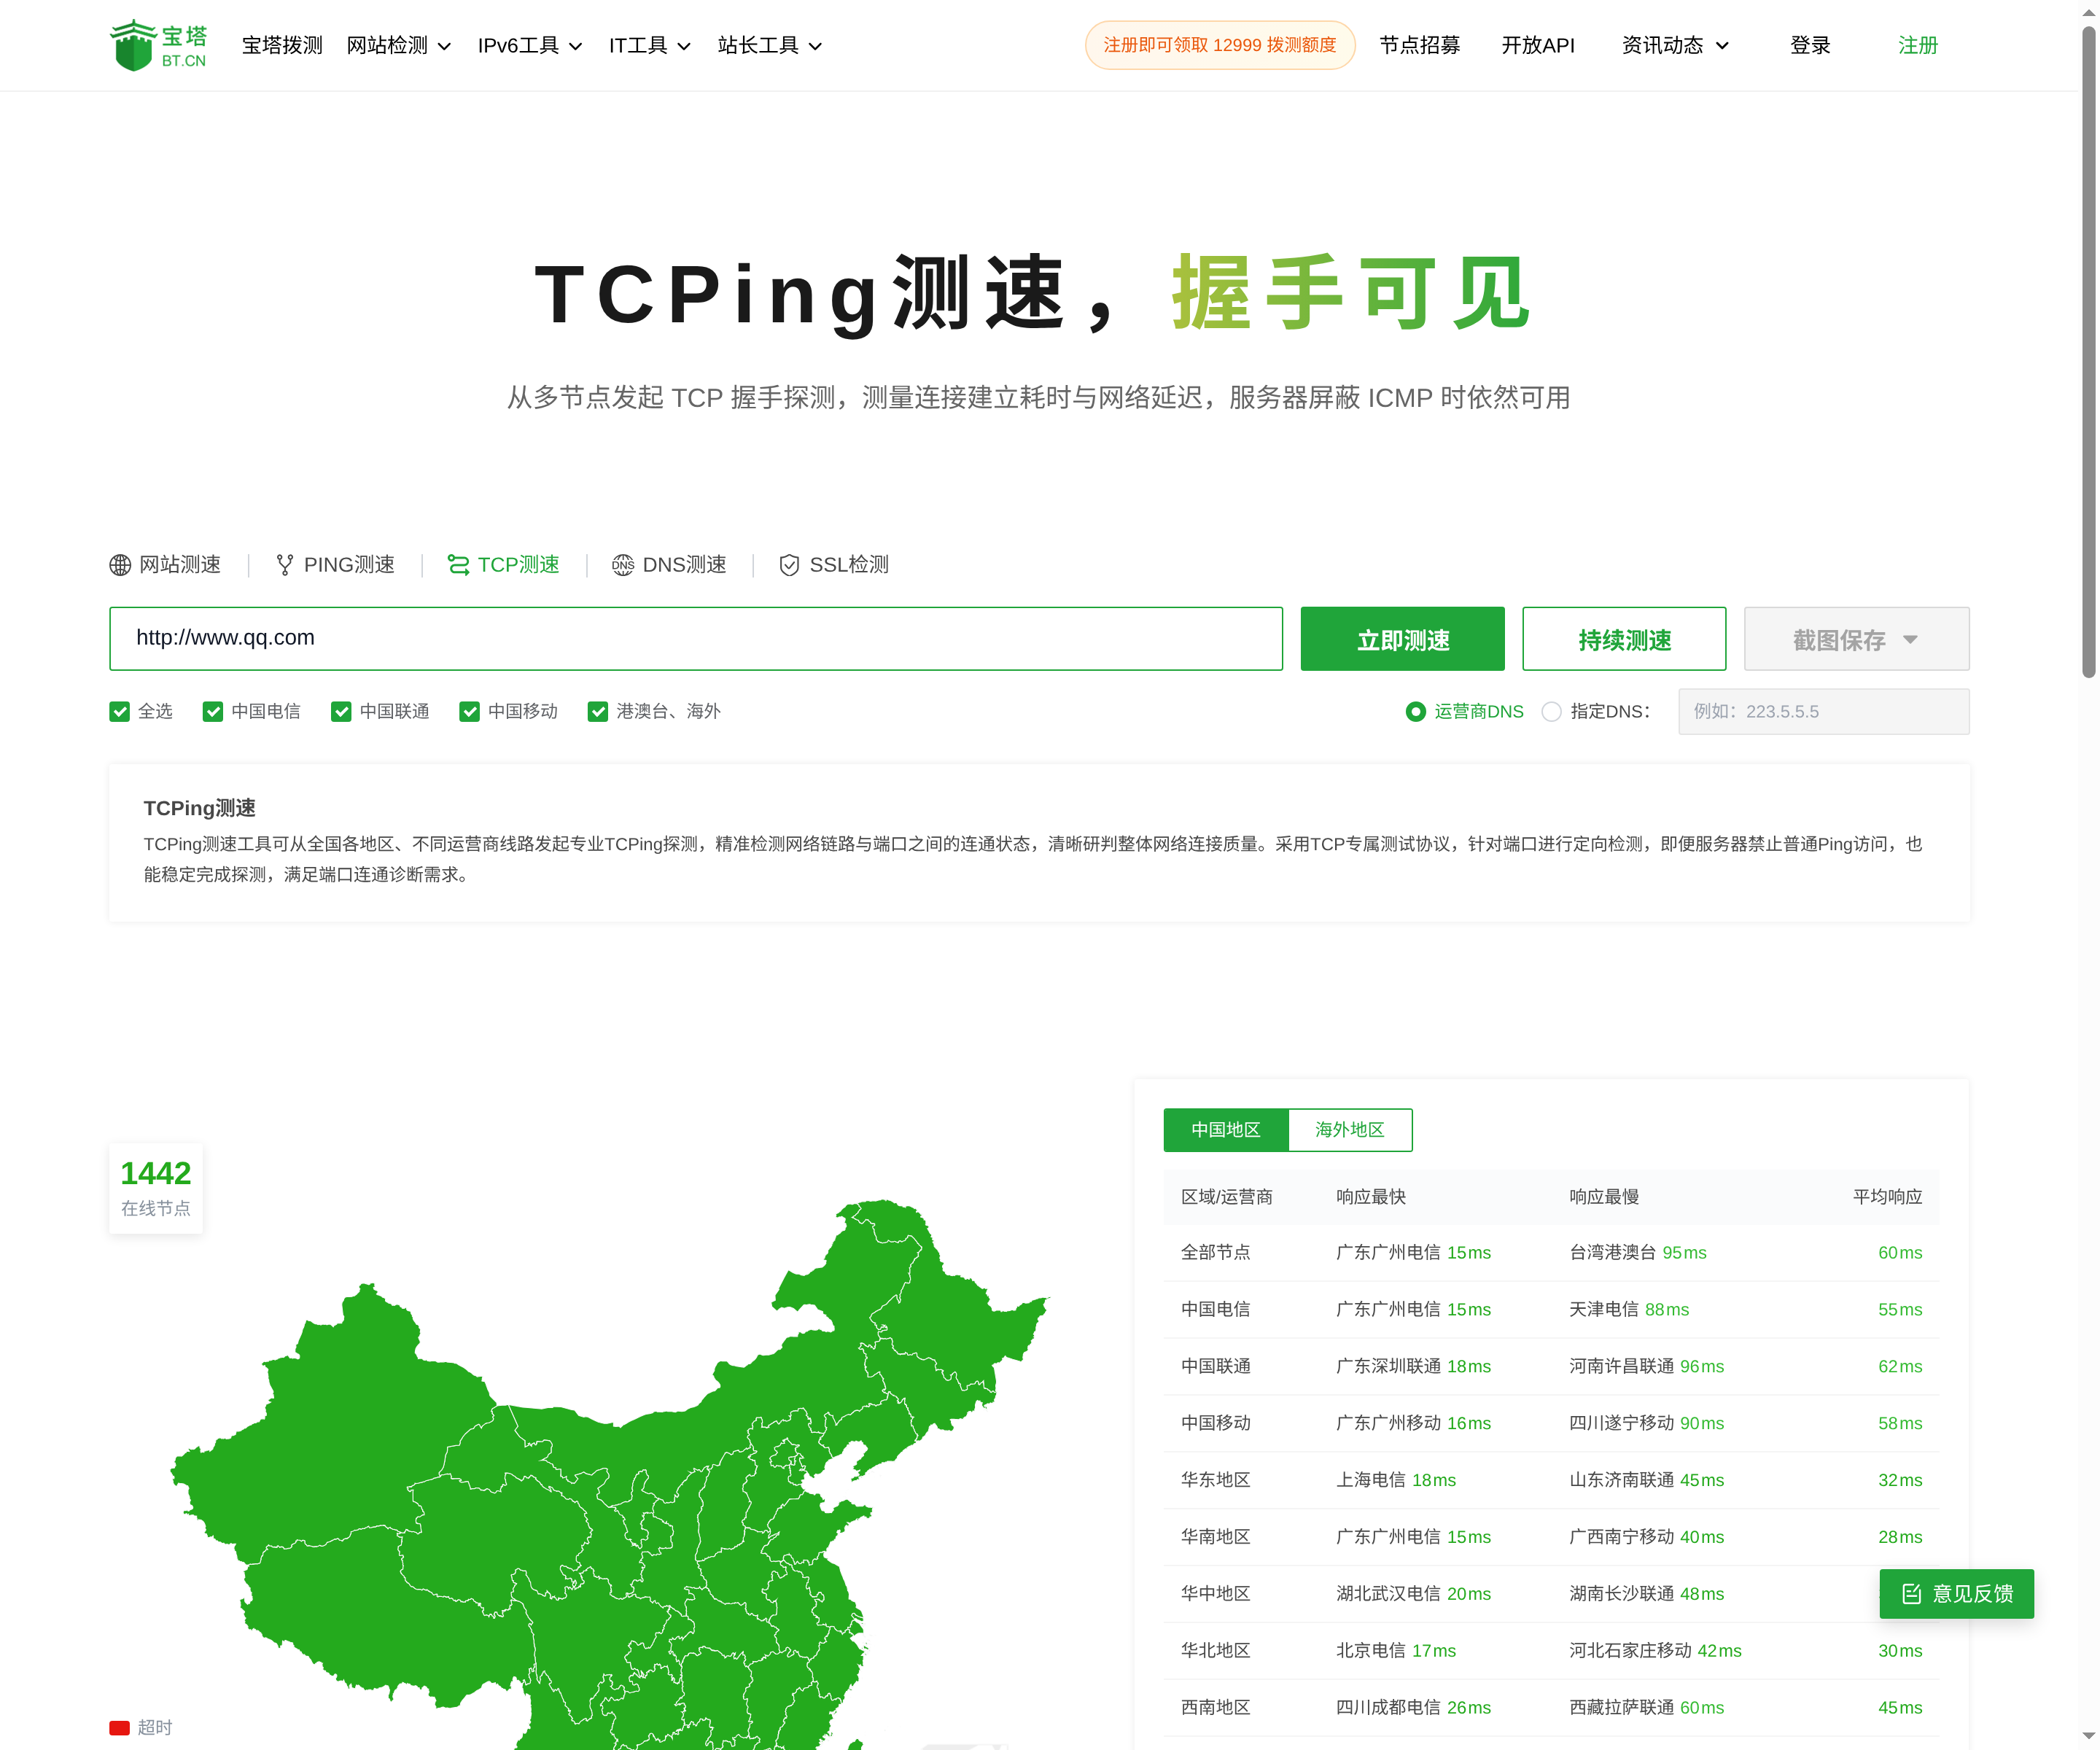
TCP 检测:填域名和端口,多节点看连通与握手耗时
找共同点
第一个维度是时间:失败是不是集中在某个时段。晚高峰、整点、备份时间,都值得对。
第二个维度是节点:是不是只有某家运营商、某个地区失败。
第三个维度是频率:每分钟一次失败,还是几分钟一次,有没有周期性。三个维度里,时间最容易被忽略,但它往往最有用。
三个维度交叉,共同的影子就出来了。
常见的诱因
连接数打满,新的握手被拒绝或者排队,表现为间歇性失败。
后端进程重启或者健康检查抖动,服务短暂不可用。
防火墙或防护设备限速,超过阈值就丢包。
带宽被打满,握手包也挤不进去。还有一种:NAT 或者负载均衡的连接表满了,新连接直接建不起来。
怎么验证
把失败时间点和服务器日志、监控曲线对上。CPU、连接数、带宽,哪个在同一时刻抬头。
再看看是不是和发布、定时任务重合。很多「玄学」问题,最后发现是凌晨的备份。日志时区要和测试对齐,不然对不上时间点。
复测与记录
改完继续跑一段时间,看失败率有没有下降。
记录里写清测试周期、节点、失败时间点和当时的服务端状态。连续测速时别只记成功次数,耗时曲线比成功率更敏感,很多故障在彻底不通之前,先表现为变慢。能不能抓住,取决于采样频率:一分钟一次能抓到大部分分钟级抖动,秒级抖动端口层很难完整记录,这一点要实事求是。
样本量不够时,别下结论。和用户沟通时,把周期和样本量说清楚,对方更容易理解为什么需要时间。这不是拖延,是对结论负责。结论里写清适用时间范围,过了那个范围要重新测,数据有保质期,尤其在高频变更的环境里。
偶发问题不可怕,可怕的是没有数据就开始猜。
