服务器端口开得越多越方便吗?多节点拨测先分清是网络还是服务器
图省事,放开一整段
新业务上线,为了联调方便,我把一段端口全放开了,想着以后慢慢收。
后来忘了。几个月后做扫描,发现十几个端口对公网开放,其中两个还是内部管理用。那次清理花了一整晚。
方便的代价
扫描器不挑食,全端口扫一遍就能找到。
端口后面挂着什么服务、版本多老、有没有弱口令,都是可被试探的入口。暴露面越大,出事的概率越高。端口不是越少越好,是越明确越好:该开的一个不能少,不该开的一个不能多。
端口之间还能横向:一个弱服务被拿下,其他服务就成了下一站。
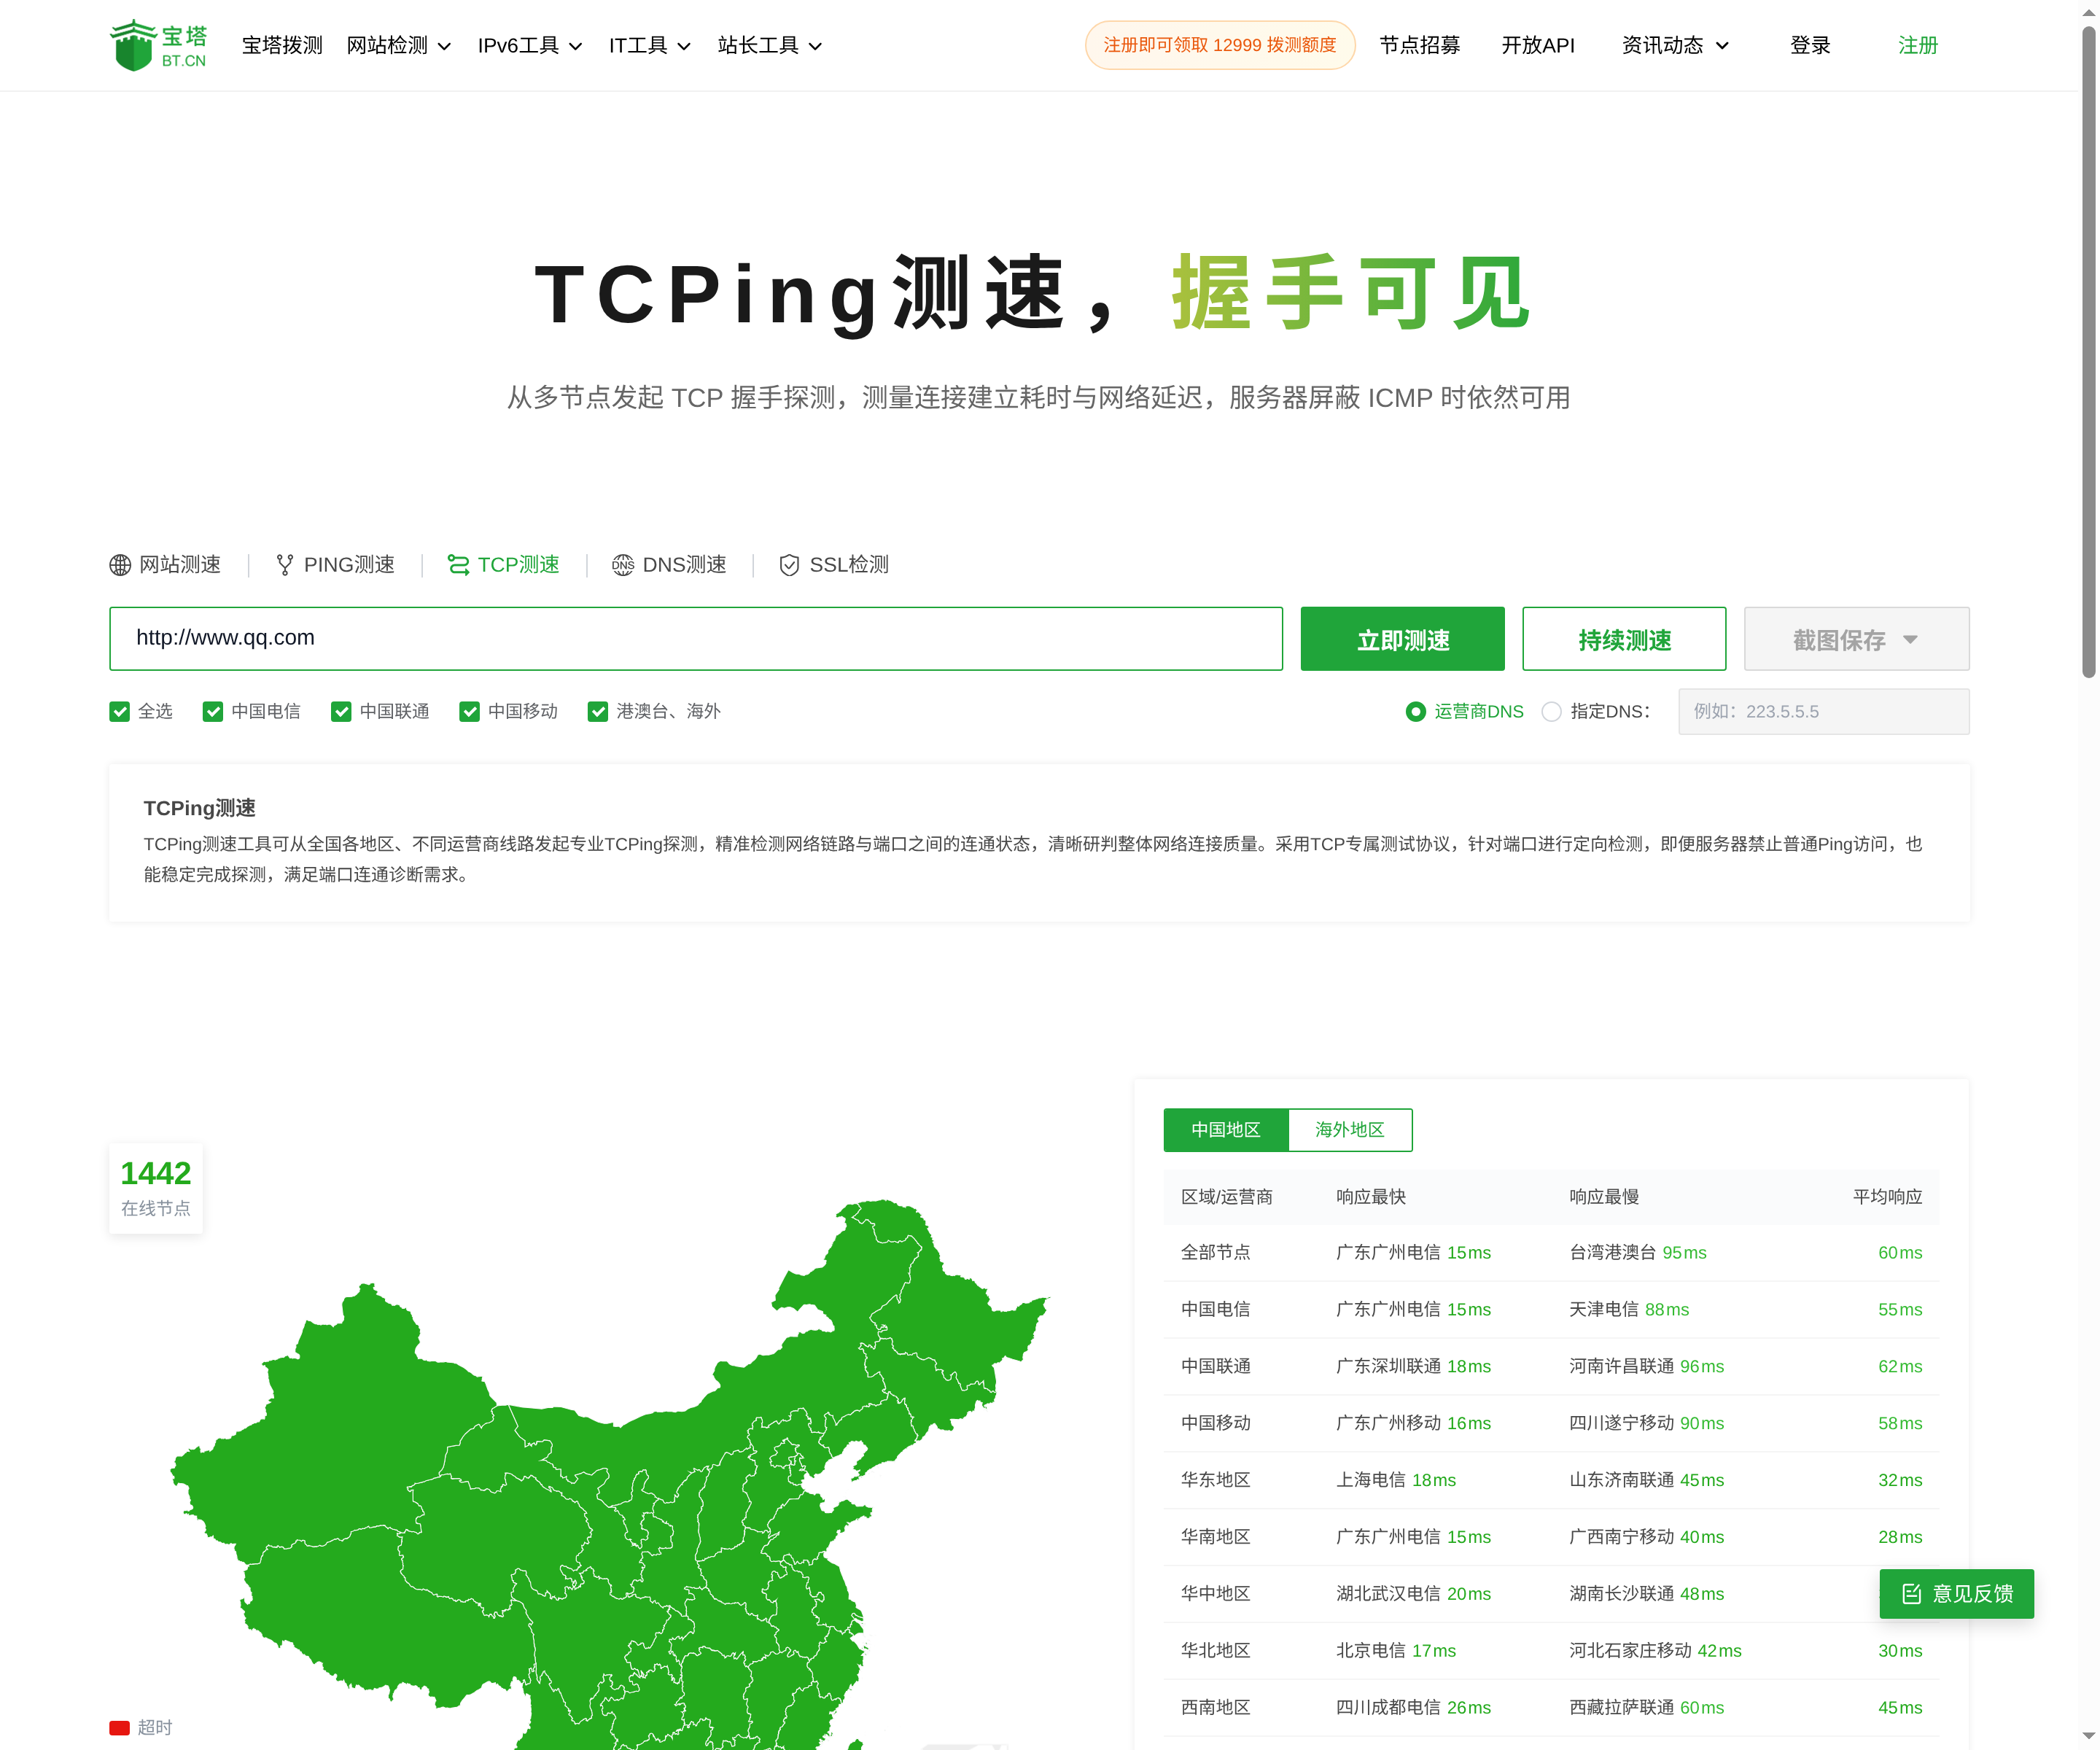
TCP 检测:填域名和端口,多节点看连通与握手耗时
用依赖清单
先列业务到底依赖什么:对外提供哪些服务、从哪些来源访问、用什么协议。
只给必需的一对「端口 + 来源」,其余默认拒绝。清单最好和业务方一起过,别自己拍脑袋。
「以后可能用得上」是最贵的理由。真需要时再加,加一条规则的代价,比清一次暴露面小得多,也比出一次事故便宜。
从外部核对
在服务器上看监听,只能看到本机认为的状态,防火墙和云安全组是另一层。
用宝塔拨测的 TCP 测速从多地区多运营商节点探测,确认哪些端口真的能从外面连上。
按运营商分组看,能发现只对部分网络开放的情况,这类最容易被忽略。探测结果和规则对不上,就是漏网。
收敛策略
默认拒绝,按需放行,最小权限是老话,但有效。很多事故不是被攻破,是被遗忘,临时规则最容易忘,加的时候一定要写到期日,到期自动提醒。
来源写网段,别写单个 IP,换办公地点不至于失效,也少一次救火。
区分环境,生产只开对外的,内部服务一律走内网或跳板,别图省事直接暴露。
复测与变更管理
每次改安全组、加临时规则,都记下来,标上过期时间。审计时看三个东西:开放端口、来源范围、服务版本,三个都对上,风险才可控。扫描报告可以留档,季度对比,能看出暴露面是在扩大还是收缩。
配置变更后用同一批节点复测,确认该关的关了、该开的没被误关,别只看一个节点。
定期扫一次,比出事再查便宜,也更容易和团队达成共识,减少扯皮。端口管理不是一次性项目,是日常流程的一部分,写进变更规范才算落地,否则过几个月又会反弹。分阶段推进,阻力小很多,可以先从低风险环境做示范,有了效果再推广,别一上来就动生产。长期看,这套习惯会省下很多事,比每次救火强。
端口列表短一点,睡得踏实一点。
