JSON该用对象还是数组?从身份、顺序和查找方式决定
同一个接口,两种写法
做数据同步时,对方给的配置一会儿是对象,一会儿是数组。我按对象写了取值,第二天字段变成列表,全报错。
不是谁写错了,是没人商量过该用哪种,接口文档里也没写。
三条判断标准
三条不复杂,难的是每次都问一遍,而不是凭记忆。
身份:每个元素有没有稳定的唯一标识,比如 id、域名、端口,有就可以当键。
顺序:元素的先后有没有业务含义,比如步骤、时间线,有就必须用数组。
查找:调用方主要按 key 取一个,还是遍历全部,这决定了数据结构的形状。
三条里有两条指向同一边,就按那一边定。拿不准的时候,把两份真实数据贴进宝塔拨测的开发者工具集格式化对比,差异看得见。
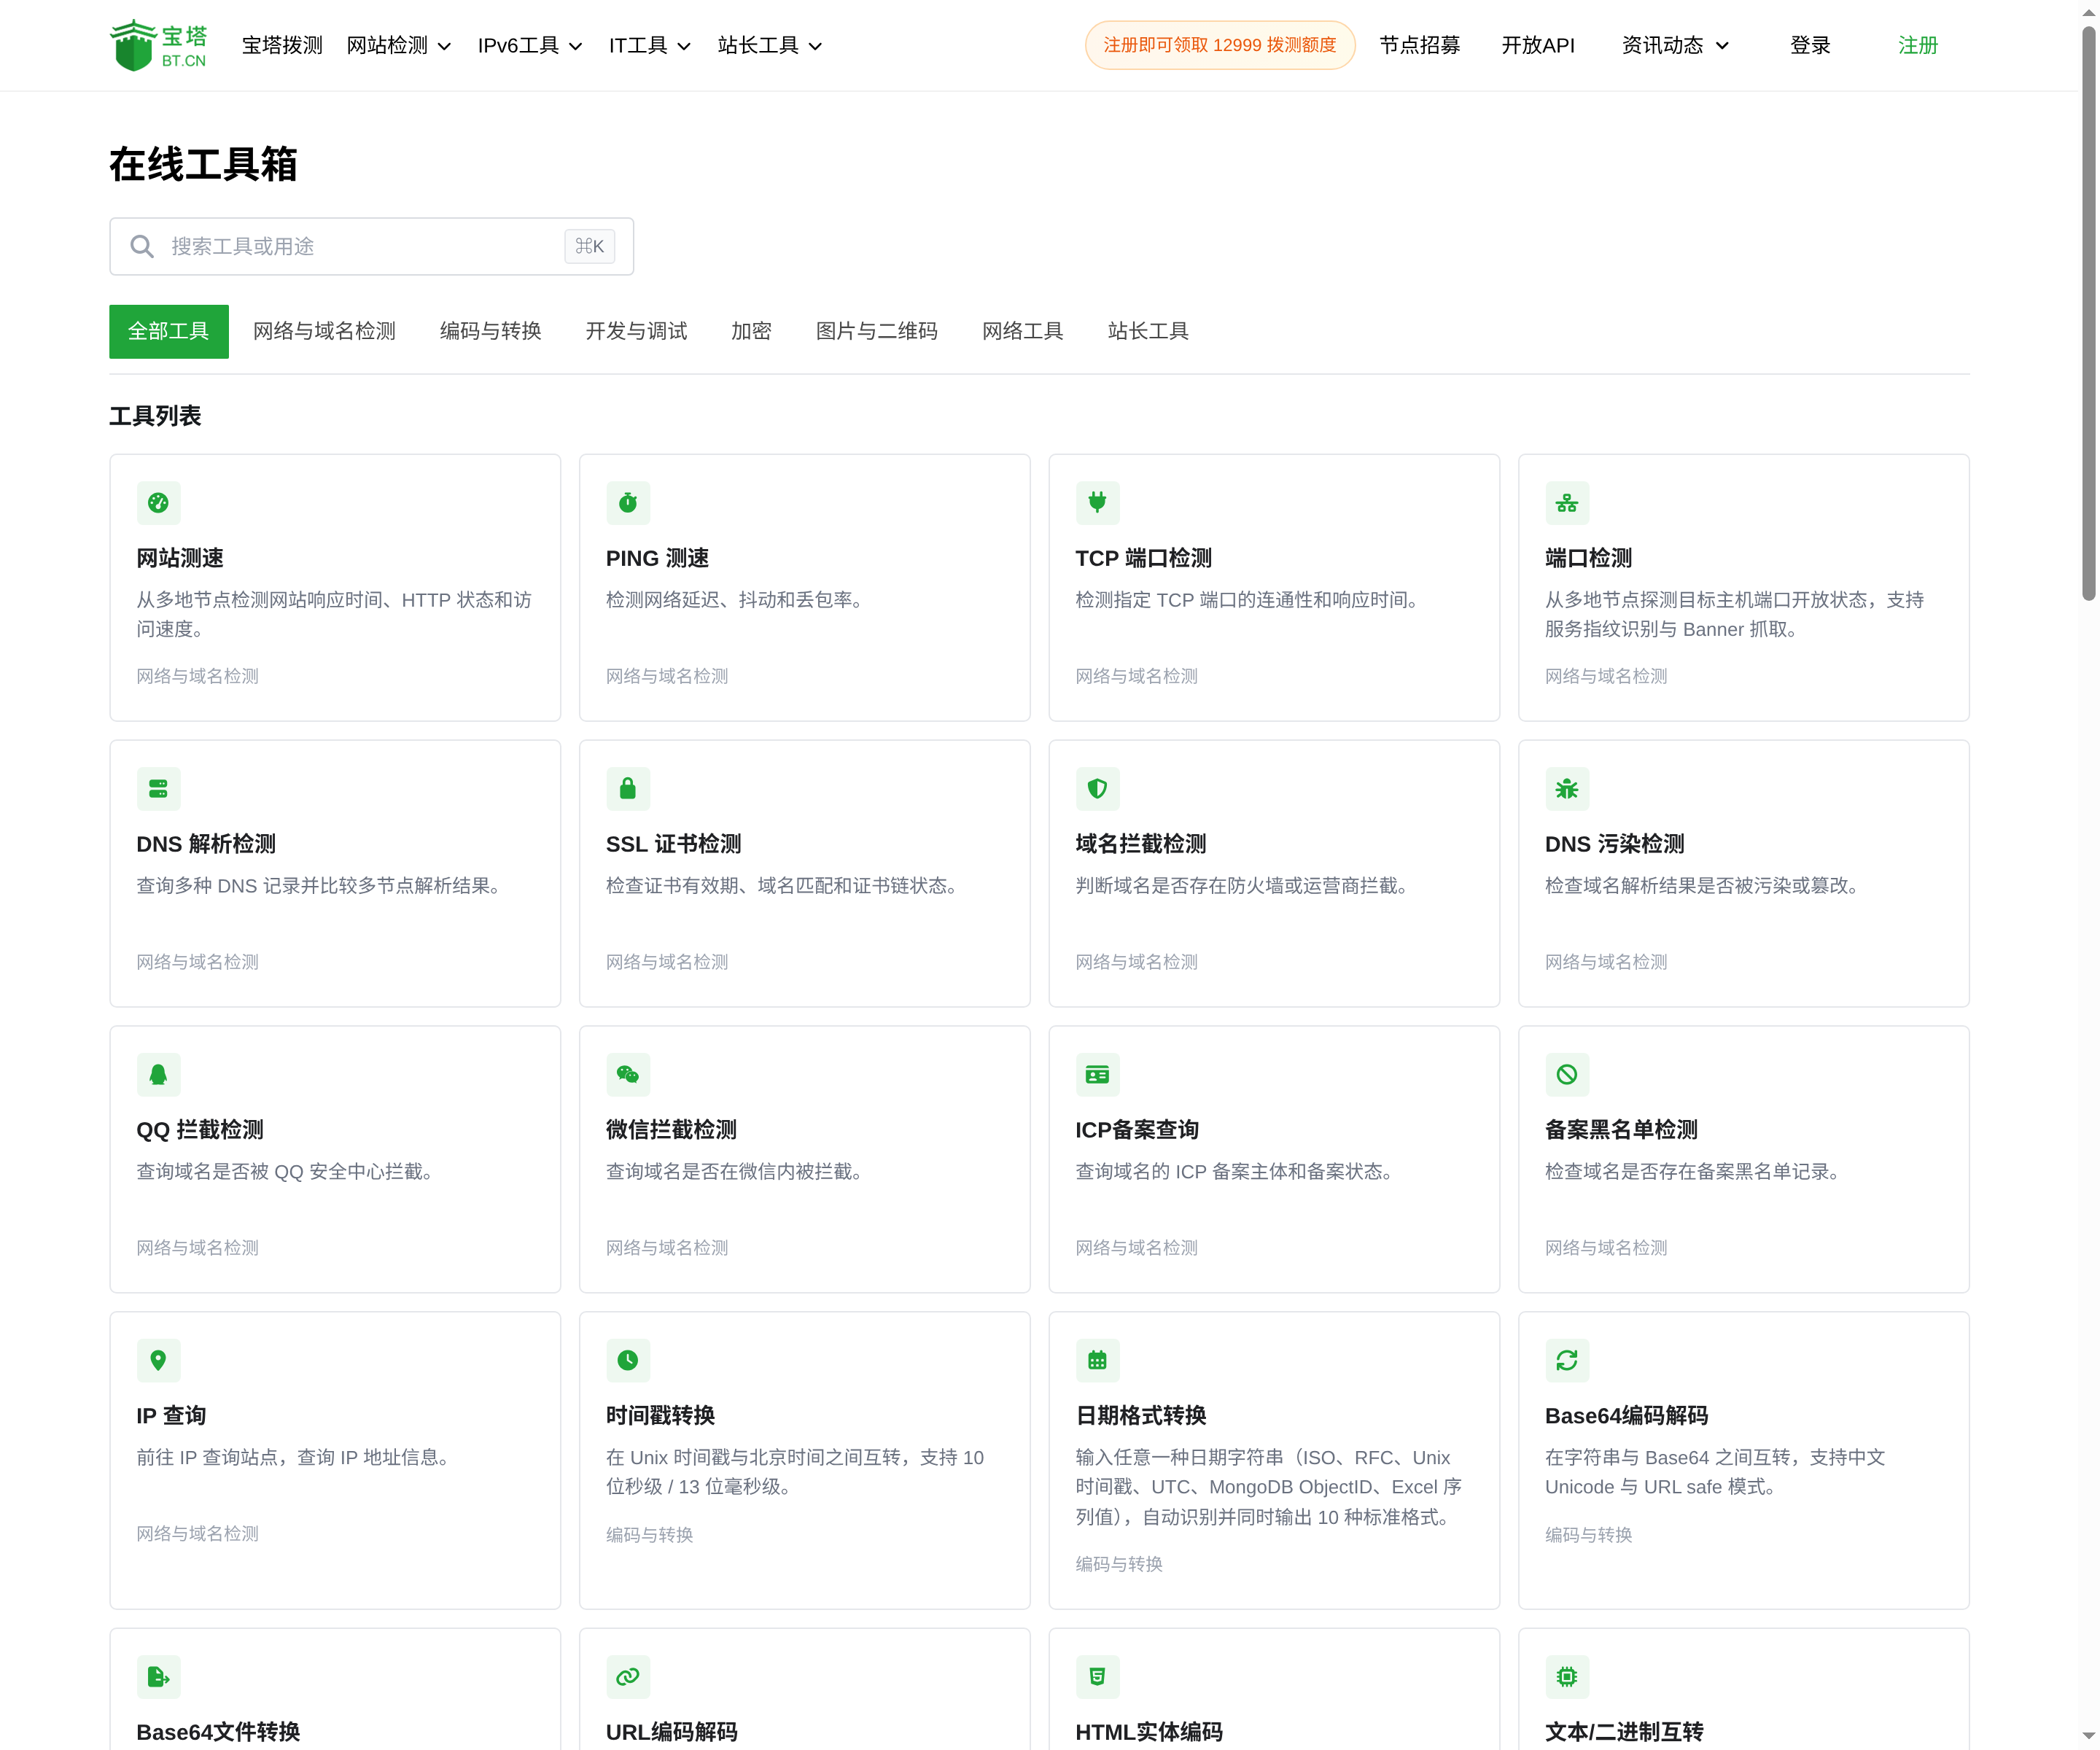
宝塔拨测工具盒:站长工具与 IT 工具入口
该用数组的情况
顺序和重复,是它最强的两个理由,其次是遍历方便。
有顺序,比如操作步骤、日志条目、排行榜,顺序本身就是信息。
允许重复,同一个值可能出现两次,用对象会互相覆盖。
主要用途是遍历,很少按某个键直接取,数组最顺手。
该用对象的情况
按名字取值,是它最舒服的场景,代码也更好读。
每个键唯一,天然适合当索引,比如按域名、按端口,取值一次到位。
只需要按名字取值,不需要顺序,也不用考虑重复。
增删频繁,按 key 操作比遍历更快,数据量一大差距就明显了。
反着用会怎样
这三种后果,都要花时间补,而且往往在最忙的时候暴露。
数组当字典:每次取值都要遍历,数据一多就慢,还容易写错下标。
对象当列表:顺序不保证,前端渲染出来顺序乱跳,用户以为数据错了。
字段含义靠位置猜:加一个字段,所有依赖位置的代码全废,改一次崩一片。
折中与验证
没有完美答案时,选改动最小的那个,也最好解释的那个。
既要身份又要顺序,可以用数组,元素内部带 id,两边都不耽误。
定下来就写进接口文档,写清为什么这么选,别让下一个人再猜一次。
结构定对了,后面改起来才轻松。
结构定错,后面全是补丁。
补丁多了,就成技术债了。
技术债这东西,早晚要还。
早点还,利息少。
这个道理,做接口的人都懂。
懂归懂,做到的不多。
做到的那几个,都挺省心。
省心这件事,值得追求。
追求省心,本身就省心。
这话听着绕,其实很实在。
实在的话,往往不好听。
听进去就好。
听进去,就能少踩几次。
少踩坑,就是进步。
进步一次,就顺一次。
顺了,就不折腾了。
