接口返回 304、正文 0 字节,是请求出错了吗?
手工发送条件请求后,收到 304 仍继续解析空正文,程序就可能报“解析 JSON 失败”。遇到这种情况,先别急着改服务器。要分清的是:服务器本来应该返回完整内容,还是客户端带着一个条件,要求它在内容符合某个版本时省略正文。
本文用一个公开的 ETag 演示接口,把普通 GET、相同标签和不同标签放在一起对照,再讲自己的网站应该怎样查。图片和请求采集于 2026 年 11 月 13 日。先用宝塔拨测查看普通 GET,再由独立 Chrome 发送手工条件请求,两组结果各自解释。
先取得普通响应,别一开始就盯着 304
进入宝塔拨测的网站测速,打开“高级选项”,将请求方式明确选为 GET,输入下面的公开示例地址,发起一次测速:
https://httpbingo.org/etag/baota-demo-v1
这里的 baota-demo-v1 是路径指定的演示标签,方便观察条件请求。它不是这篇文章计算出的文件摘要,也不代表某个真实业务文件的第一版。自己排查时,应换成发生问题的完整资源地址。
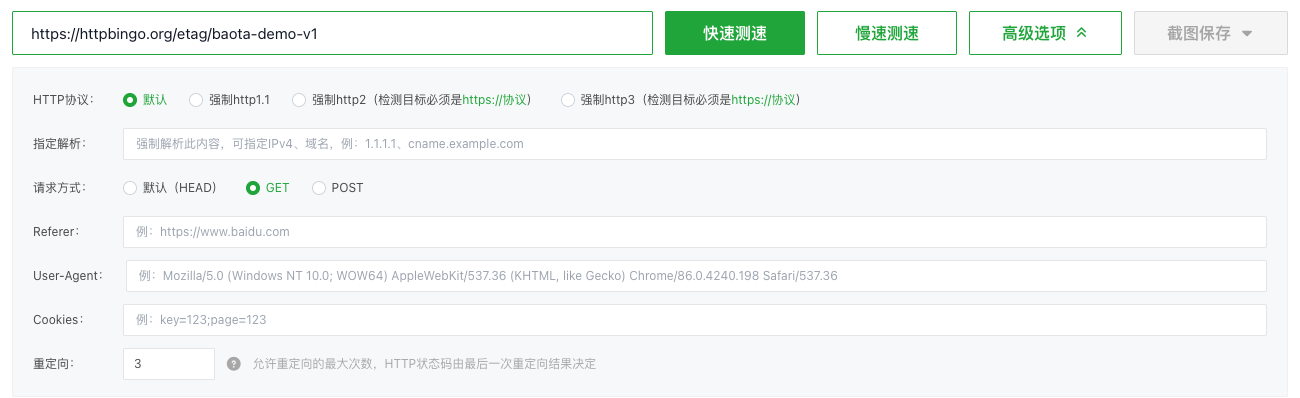
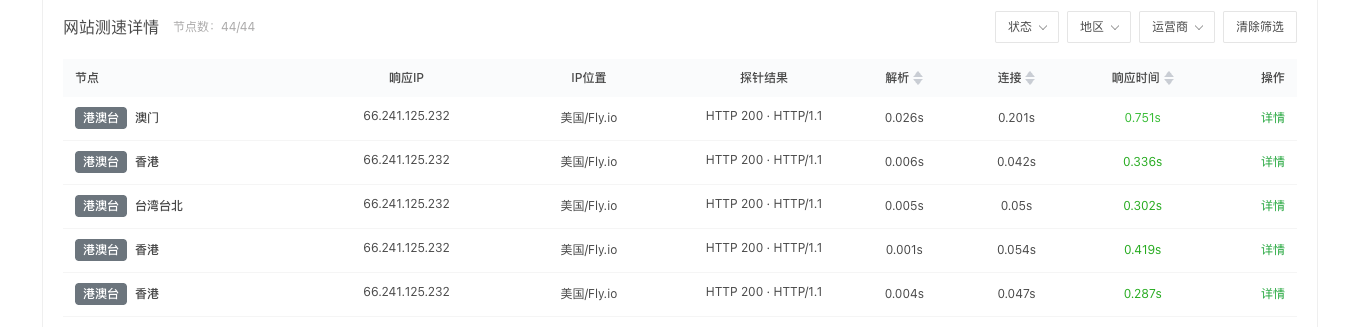
请求方式要先选对。普通 HEAD 也可以没有正文,如果默认用 HEAD 测完,就拿下载体积去解释 GET 的内容,很容易把两个问题混在一起。本轮只选择港澳台、海外这组节点,任务结束后显示 44/44;下图截取其中五条可见记录,探针结果均显示 HTTP 200。
点开澳门节点的“详情”,可以看到 HTTP 状态码为 200、无重定向,平台记录的下载体积为 688B。响应头里有这一行:
ETag: "baota-demo-v1"
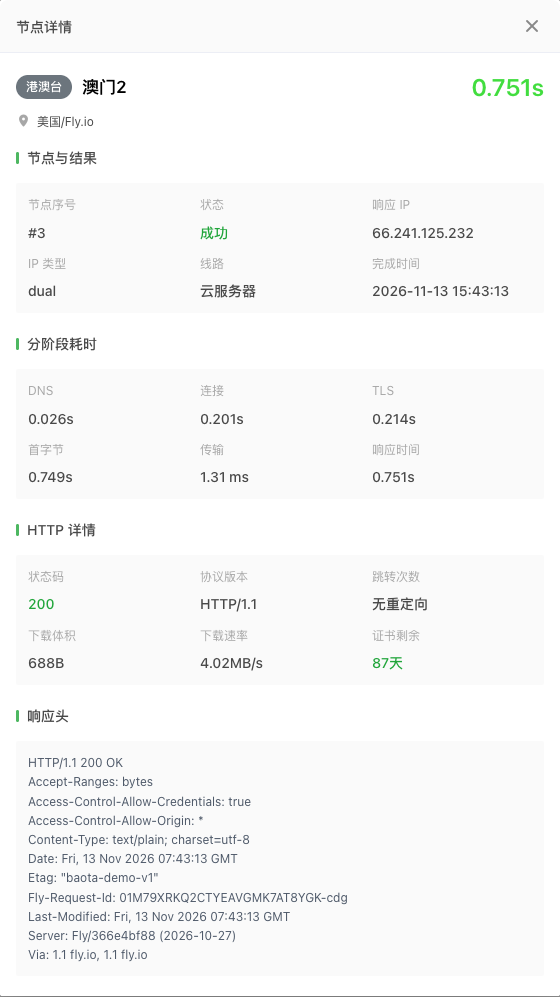
ETag 是服务器提供的表示校验标识。客户端使用时把它作为一个完整值保存和传回,不要根据字符串外观,自行认定它一定是 MD5 或修改时间。这里也要保留两侧双引号。看到 ETag 只说明响应提供了校验标识,还没有验证匹配条件会得到什么状态。
平台的“成功”和 HTTP 200,同样只描述这条探测记录。它们可以帮我们确认这次普通 GET 的结果,不能代替对业务内容是否正确、用户是否拿到最新版本的检查。
用同一个地址,对照三种请求条件
接下来在 Chrome 打开上面的示例地址,进入开发者工具的 Console。下面的代码只发 GET:先不带条件取得标签,再原样传回标签,最后换成一个不同值。
const url = location.href;
async function read(condition) {
  const headers = condition
    ? { 'If-None-Match': condition }
    : {};
  const r = await fetch(url, {
    cache: 'no-store',
    credentials: 'omit',
    headers
  });
  return {
    condition: condition ?? '未设置',
    status: r.status,
    etag: r.headers.get('etag'),
    bodyBytes: (await r.arrayBuffer()).byteLength,
    ok: r.ok
  };
}
const normal = await read();
if (!normal.etag) throw new Error('普通响应未提供 ETag');
const same = await read(normal.etag);
const different = await read('"different-demo-v2"');
console.table([normal, same, different]);
这段代码要在示例页面内运行,location.href 才是目标地址。不要在另一个网站的控制台直接照搬;换成真实业务接口时,也要重新考虑身份凭据和跨域限制。本例的公开接口不需要登录,代码明确不携带凭据。
本次 Chrome 实际请求中,未设置条件时为 200,读取正文 1356B;带回 "baota-demo-v1" 时,实际网络状态和 Fetch 的 status 都是 304,正文 0B;换成 "different-demo-v2" 后为 200,读取正文 1416B。
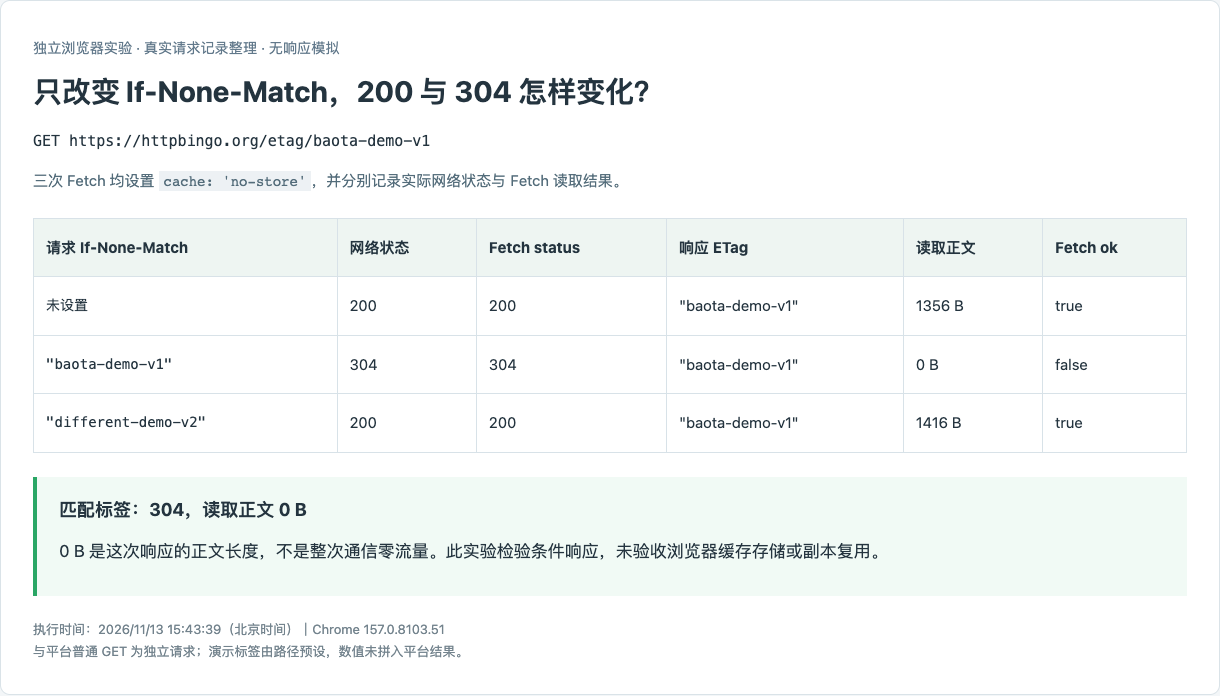
这不是一次“先坏后好”的过程。我们只改变请求条件,没有修复服务。演示接口的正文包含请求信息,两次 200 的长度不同,也不能拿来证明真实文件更新了版本。代码读到的是浏览器可读取的内容长度,平台下载体积是另一条请求的记录,这些数字也不宜直接当成压缩传输量互相比较。
这里特意使用 cache: 'no-store',让浏览器绕过 HTTP 缓存查找,并且不把这次下载的响应写入该缓存。它是 Fetch 的请求选项,不是服务器返回的 Cache-Control 响应头。这组实验只观察“带着条件发到网络后如何响应”,没有验收浏览器怎样保存或复用内容副本。
304 没有正文,接收方从哪里取得内容
对于本例的条件 GET,匹配标签后返回 304,是在告诉接收方不必重新传输相应表示的正文。304 本身不带正文,但仍有状态、响应头和网络交互。因此,0B 正文不等于整次通信零流量,也不等于服务器完全没有处理请求。
正常缓存流程里,接收方需要找到对应的已保存表示,再按响应头更新元数据、使用合适的副本。此时网络记录中的状态与脚本最终获得的响应不一定相同,不能看到网络面板的 304,就认定应用收到了空正文;本例使用 no-store 手工请求,实际读到的 status 才是 304。手工填写一个标签,服务器并不会把缺少的副本凭空补出来。如果自己的程序没有保存正文,却主动发送了一个匹配标签,拿到 304 后继续解析空内容,就需要先处理这层调用约定。
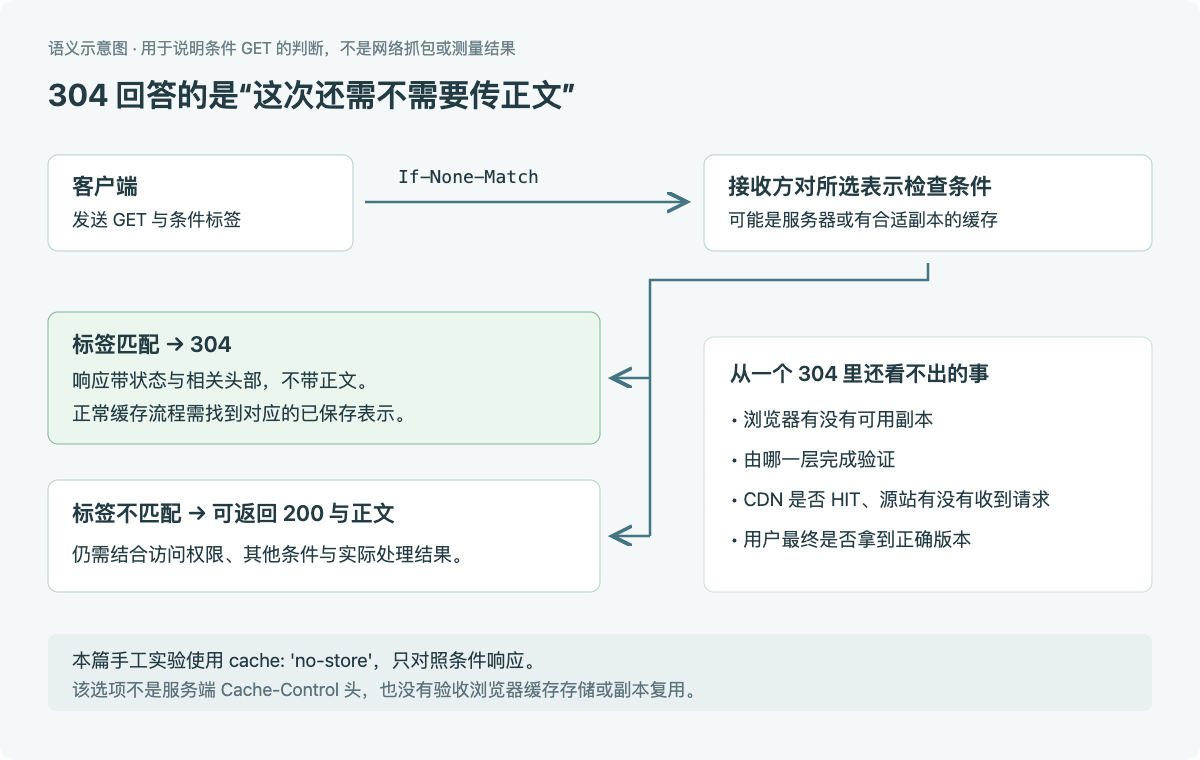
图里的“接收方”也可能是有合适副本的缓存。只凭一个 304,无法确定验证到了哪一层,更无法知道源站有没有收到请求。CDN 是否 HIT,要结合对应产品的缓存标记与日志;是否回源,还需要请求链路上的证据。不能把“省略正文”写成“没有回源”。
304 虽然在 3xx 范围内,也不是常见的“跳到另一个网址”。不需要把它当成 301、302 去找新页面,更不要为了统一显示 200 添加跳转规则。
还有一个容易误读的值是 response.ok。它只对 200–299 返回 true,所以这次手工 Fetch 读到 304 时为 false。这一个布尔值不能诊断服务端异常。客户端若要自己管理条件请求,就要明确区分完整响应、304、网络失败和其他状态,不能把它们都交给同一段正文解析代码。
同样是空正文,也要先区分下面几种情况:
| 请求与响应 | 先核对什么 |
|---|---|
| 普通 HEAD 返回 200 | 方法本来就不取正文,不能据此判断 GET 丢失数据 |
| GET 返回 204 | 服务的调用约定是否允许没有内容,不要套用 304 的版本校验解释 |
| 条件 GET 返回 304 | 条件来自哪里,客户端有没有能对应上的已保存内容 |
| 客户端显示请求失败 | 有没有实际收到 HTTP 响应,报错出在网络还是后续解析 |
例如,网络面板已经收到 304,而程序随后报告 JSON 解析失败,这是两个发生在不同阶段的现象。保留原始状态和请求条件,再查程序怎样处理空正文,比把解析错误直接记成“服务器没响应”更容易找到问题。也不要只为了避开报错,就把所有请求的条件字段删掉;先判断客户端是否打算自己管理副本,再决定相应处理方式。
换成自己的网站,按资源逐项核对
先找到真正显示旧内容或解析失败的请求。首页 HTML、脚本文件和接口是不同资源;首页拿到了新版本,不代表某个脚本也更新了。在浏览器 Network 中保留记录,点开对应请求,把完整 URL、方法、请求条件和响应头放在一起看。
接着取得一次不手工携带条件的 GET,保存正文、ETag 和时间;再携带刚取得的标签请求一次。若要判断发布是否正确,必须检查正文里的版本或实际内容,而不是只看状态码。条件请求返回 200,也可能只是标签不同,不能自动解释成“缓存已修复”。
比较前还要确认是同一份表示:路径、查询参数、登录身份、语言与编码等请求条件有没有变化,响应是否通过 Vary 区分了相应请求头。把另一个地址或另一类内容的标签拿过来,即便字符串一样,也不能证明它们可以共用正文。
如果内容已变,旧标签仍不断得到 304,应沿着这条具体资源检查:应用怎样生成与更新 ETag,代理有没有保留相关字段,实际响应的正文和校验值是否对应。保留同一时间段的请求日志再判断,避免只靠一个状态码把问题定位到浏览器、CDN 或源站。
如果要验收真实浏览器的缓存复用,应另做一轮:确认资源允许缓存,使用正常缓存模式,让浏览器自己管理条件字段,并检查请求记录与页面最终内容。本篇的 no-store 手工实验不能替代这一步,也不要把“禁用缓存”时的观察当作正常复用结果。
记录问题时,写清“哪个 URL、携带哪个标签、实际返回什么状态、客户端有没有对应内容副本”。有了这几项,304 就能回到具体的请求里解释,后续该查标签生成、缓存策略还是客户端处理,也更容易分清。
