HTTP 200 却中文乱码,怎样核对 UTF-8 字节和 charset?
网页返回了 200,中文却变成一串看不懂的符号。重新测速还是 200,下载的正文也不是空的。遇到这种情况,继续确认“请求有没有成功”已经不够了,还要看收到的字节是什么,以及客户端按什么规则把它们变成文字。
下面用一份固定的 UTF-8 纯文本做对照:正文完全相同,一组响应声明 UTF-8,另一组故意声明 windows-1252。实测与截图均采集于 2026 年 11 月 13 日,属于公开接口的预设演示,没有改动真实业务网站的配置,也不把切换演示参数称为事故修复。
先固定正文,再改变声明
演示原文只有七个字符:
中文拨测:你好
这段文字事先按 UTF-8 编成 21 字节。这里的全角冒号也占三个字节,“七个字符”与“21 字节”是两个不同口径。没有 BOM,也没有 HTML 标签,后续不需要猜测文件保存时用了什么编码。
公开服务的 Base64 接口负责返回指定字节,两个地址的路径完全一致,查询参数只改变 Content-Type。Base64 只是把字节放进 URL 的办法,不会自动把正文转成所声明的字符集。错误声明组的目标是:
https://httpbingo.org/base64/5Lit5paH5ouo5rWL77ya5L2g5aW9?content-type=text%2Fplain%3B+charset%3Dwindows-1252
正确组将其中的 windows-1252 换成 utf-8。这不是推荐给网站使用的错误配置,而是把“字节相同、声明不同”这个条件单独拎出来,观察浏览器究竟会怎样显示。
200 和非零体积,能说明到哪一步
在宝塔拨测的网站测速中打开高级选项,明确选中 GET,再输入错误声明组的完整地址。这里需要读取正文,不能沿用只取响应头的 HEAD。等待当前检测进度达到 100%,再查看节点表与详情。
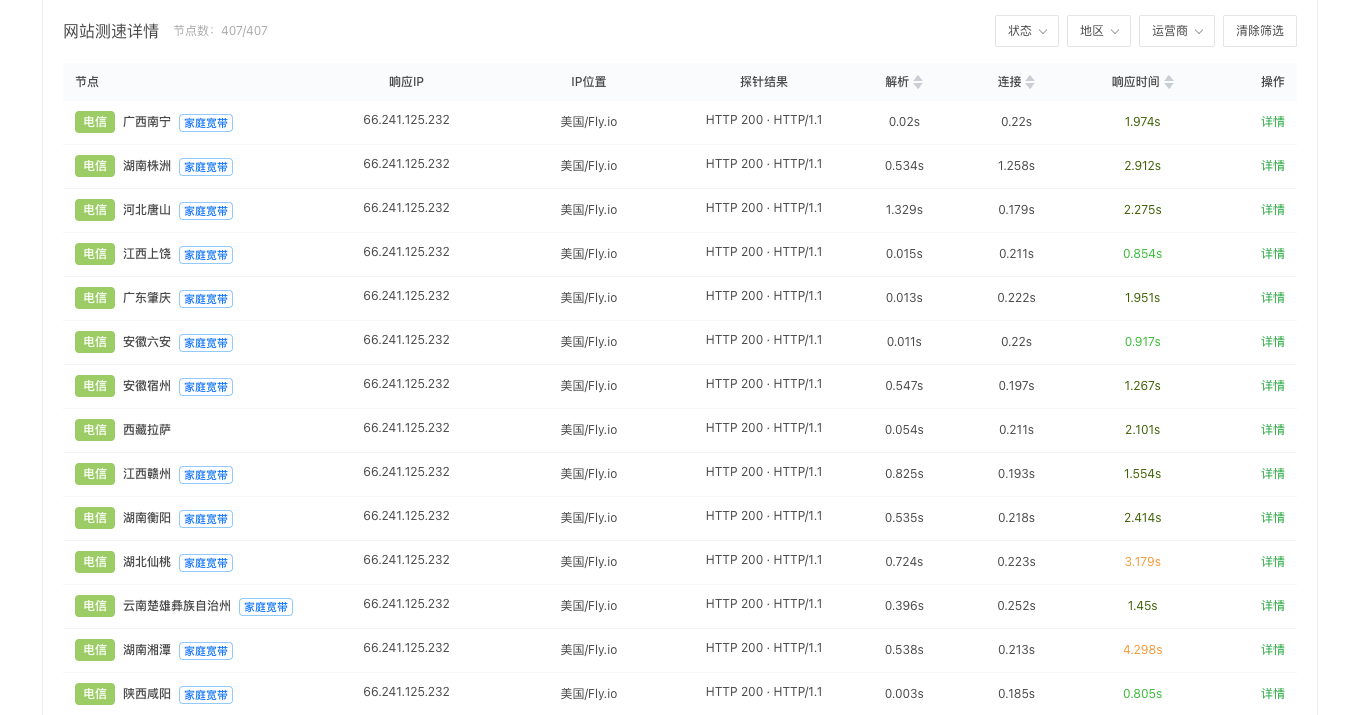
表格中可见节点返回 HTTP 200。打开其中一个 200 节点的详情,可以继续核对响应头里的内容类型,以及该节点显示的下载体积。此次详情保留了故意设置的声明:
Content-Type: text/plain; charset=windows-1252
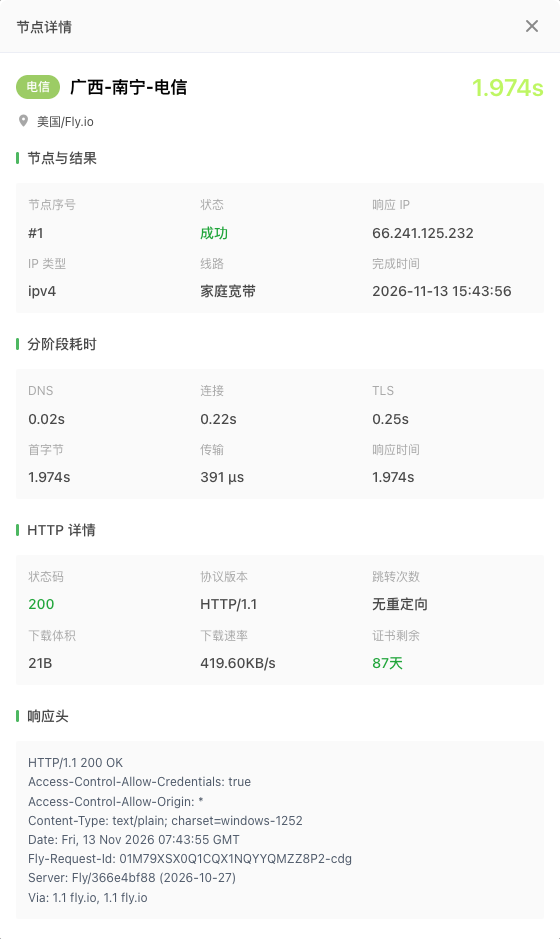
这些信息说明该节点取得了响应,但表格没有执行浏览器的文字显示流程。200 也没有替我们检查“中文应该显示成什么”。同样,正文非空只能排除一部分空响应问题,不能证明其中每个字节都会被正确解码。
Content-Type 是服务端给接收方的处理说明。声明为 windows-1252,不等于实际正文就一定是这种编码。若应用输出的是 UTF-8,代理却附上了另一个 charset,请求仍可能成功,错误会出现在后面的字符解释过程。
平台详情中的体积与后文的 Fetch 长度即使数值相同,也不能直接互相校验。它们来自不同客户端、不同请求,工具的统计口径也需要单独确认。这里用节点详情核对响应声明,用实际字节数组核对正文内容,不把其中一个结果扩展成另一个结果的保证。
真正打开页面,看浏览器采用了什么
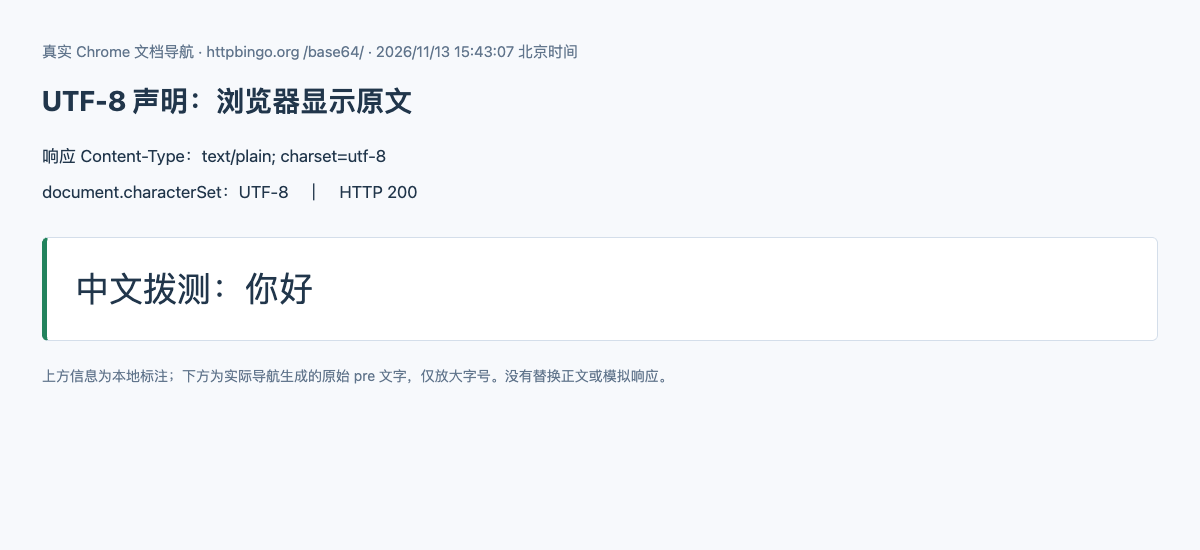
接下来用真实 Chrome 分别导航到两个目标地址。这里记录的是文档本身的 document.characterSet 和页面实际文字,不是把响应先用脚本解码,再把字符串放进自建页面。
正确声明组的文档采用 UTF-8,显示出原来的中文:
错误声明组同样返回 200,文档实际采用 windows-1252,显示为另一串字符:
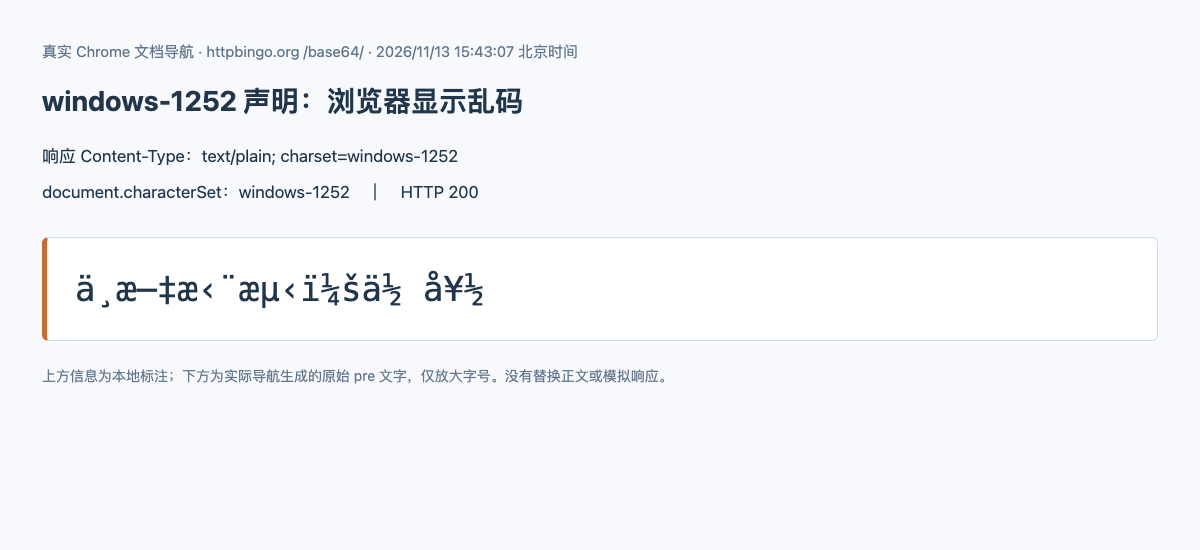
两张图的来源说明和字号放大都是采集时添加的本地标注,原始纯文本没有被替换。浏览器字符集与文字先记录,随后才添加标注。这一处理是为了让短文本看得清楚,不代表远端服务自带图中的说明界面。
自己复查时,可以在直接打开目标后的开发者工具控制台执行 document.characterSet,再与网络面板中该文档最终响应的 Content-Type 对照。若地址经过跳转,检查最终文档那一跳,不要误看入口的重定向响应头。记录显示文字时,也应保留这个文档的实际内容,而不是另一个标签页或脚本请求的输出。
这时还不能仅凭画面宣称“两次传回的字节相同”。截图只展示解码后的文字;开发者工具或调试协议返回的文本也可能已经经过解码。要确认内容是否变化,还得读取字节缓冲区。
用 arrayBuffer 核对字节,别拿字符串代替
本次另行发起同源 Fetch,用 arrayBuffer() 读取两组实际响应正文,再对字节数组计算 SHA-256。两份结果都是 21 字节,哈希相同,并且与事先生成的 UTF-8 源文件一致。显式按 UTF-8 解码,两份都能还原“中文拨测:你好”。
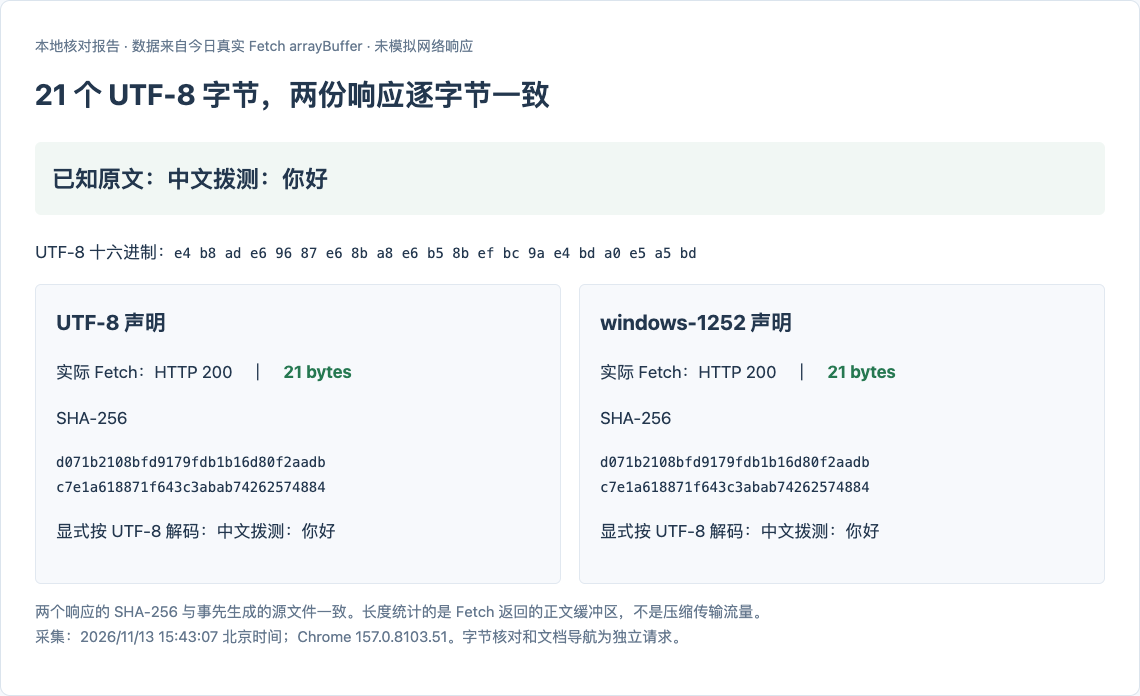
字节读取与前面的文档导航是独立请求。这份证据说明固定演示接口的两次字节读取一致,导航也分别表现出对应的解码结果;没有把 Fetch 记录说成导航那一次请求的原始线缆抓包。生产接口如果会根据时间、Cookie 或用户身份返回不同内容,复查时还要把这些请求条件对齐。
需要在自己的同源页面里核对时,可以在浏览器控制台使用下面的方式,将 url 换成有权读取的目标路径。跨域读取仍受浏览器访问规则约束,不能用它绕过限制。
const url = '/需要核对的路径';
const response = await fetch(url, { cache: 'no-store' });
const buffer = await response.arrayBuffer();
const digest = await crypto.subtle.digest('SHA-256', buffer);
const sha256 = [...new Uint8Array(digest)]
  .map(value => value.toString(16).padStart(2, '0')).join('');
console.log(response.status, response.headers.get('content-type'));
console.log(buffer.byteLength, sha256);
console.log(new TextDecoder('utf-8', { fatal: true }).decode(buffer));
这段代码把“收到多少字节”“字节是否相同”“指定 UTF-8 后是什么文字”分开输出。最后一行采用严格解码,遇到无效 UTF-8 会抛错。不过,没有抛错也不能独立证明任意未知文件原本采用 UTF-8;本例能够确认编码,是因为生成数据时就已经明确选择了 UTF-8。
为什么 Fetch 读着正常,页面却不正常
Fetch 标准定义的 text() 使用 UTF-8 解码,不能拿它代替文档导航的字符集判断。本次从同一 Fetch 响应克隆后调用 text(),两组都得到原来的中文;独立导航到错误声明组时,页面仍然显示乱码。这两个结果可以同时成立。
因此,“接口在脚本里输出正常”只证明那条读取路径得到了正常字符串。它不能直接证明浏览器打开同一地址、另一个客户端保存文件,或程序用其他解码器读取时也会正常。报告问题时,需要写清楚乱码发生在哪一种读取方式里。
例如同一个地址在脚本里正常、直接打开时乱码,就应把这两种结果同时留下,包含浏览器版本与最终 Content-Type。不要为了让记录看起来一致,只保留正常的那一次,也不要把脚本解码后的结果再写入页面,用它替代真正的直接访问现象。
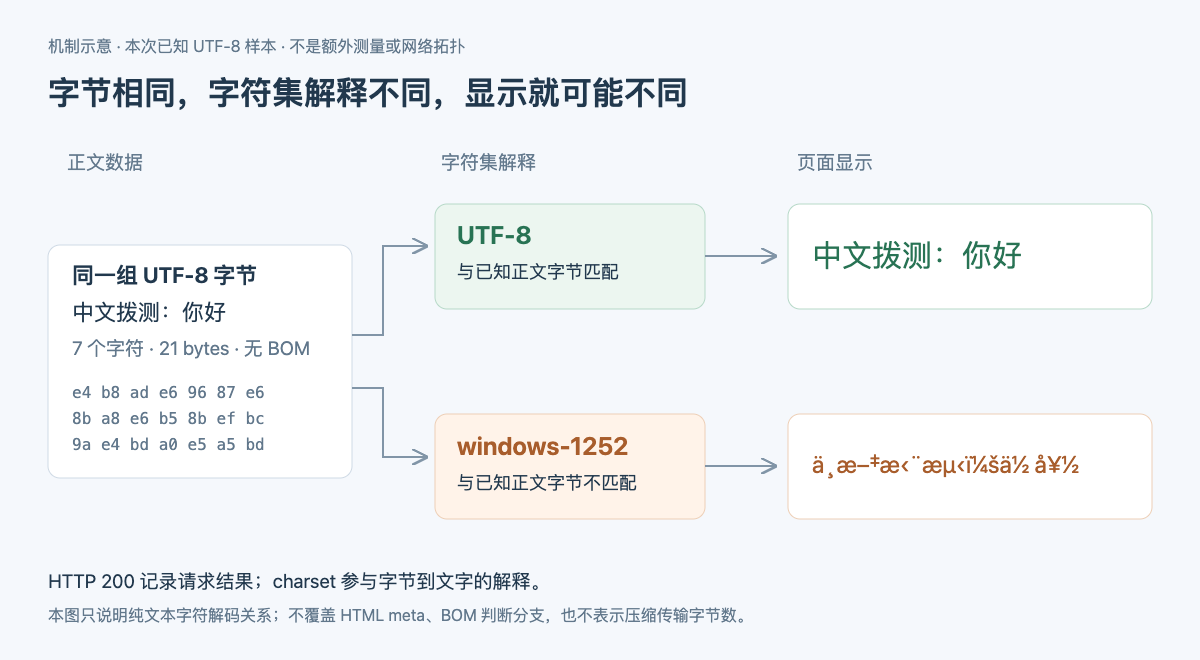
正文长度也要保留统计阶段。本次 21 字节来自 Fetch 返回的正文缓冲区,不是压缩传输流量。Content-Encoding 中的 gzip 等处理与字符集属于不同层次:内容解码得到正文数据后,字符集才决定这些字节对应哪些文字。开启压缩无法纠正 charset 与正文编码不一致的问题。
回到自己的站点,沿着内容来源检查
先保留出现乱码时的 URL、请求方式、响应头和原始文件,避免把浏览器里已经乱码的文字复制出来,再保存为 UTF-8,误以为那就是服务端原来发出的字节。复制和再次保存会引入新的编码过程,后面的比对可能只是在检查这份新文件。
接着确认内容从哪里产生:静态文件保存时的编码、模板与应用输出的编码、最终客户端收到的 charset 是否一致。网站经过 CDN 或反向代理时,要检查最终响应,不能只看应用配置。若不同访问入口表现不同,应分别保留对应响应,再判断是哪一层改变了内容或声明。
还可以保留一份修改前的字节哈希,修正后重新获取。如果目标只是纠正声明,正文哈希仍相同而中文恢复可读,是很有用的对照;如果哈希也变了,就需要继续确认内容变化是否符合预期,不能将显示正常直接等同于原始内容已经完整恢复。
HTML 还涉及 BOM、HTTP 声明和页面内编码声明等判断条件。本次为了排除干扰,使用的是无 BOM 的纯文本,没有实测 HTML 的 meta 或 BOM 分支。遇到真实 HTML 页面,应结合它的实际字节和声明检查,不能把增加一个 meta 标签当成通用修复。
如果原始内容仍是正确的 UTF-8,而最终声明错误,就应沿输出链路修正声明;如果乱码已经被再次保存,字节本身也可能改变,只改响应头未必能恢复原文,需要从正确来源重新生成或恢复。处理后,再用相同请求条件复查最终响应,并回到真正出现乱码的客户端确认显示。到这一步,200、字节一致和中文可读才各自有了对应的证据。
