下载路径没有后缀,怎样确认中文文件名和实际内容?
拿到一个 /export?id=123 这样的下载地址,路径里看不到 .txt、.pdf 或 .xlsx,浏览器保存时却出现完整的中文文件名。这通常不需要先改 URL:服务器可以通过响应头提供建议保存名,文件内容也可以由接口动态生成。
真正需要核对的是,服务器给了什么名字,浏览器采用了什么名字,保存下来的又是什么内容。只看下载按钮有没有反应,很容易把这几件事混在一起。
这次用宝塔拨测和真实 Chrome 检查同一条公开测试地址。实测与截图日期均为 2026 年 11 月 13 日。为了让现象容易复现,响应头由测试接口按参数预设;它返回的是 JSON 回显,不是一份业务系统生成的拨测报告。
先准备一条没有文件后缀的接口地址
公开测试服务的 /response-headers 可以按查询参数返回响应头。本例保留一个普通英文名,再加一个中文扩展文件名:
const target = new URL('https://httpbingo.org/response-headers');
target.searchParams.set('Content-Disposition',
  `attachment; filename="probe-report.txt"; filename*=UTF-8''${encodeURIComponent('拨测报告.txt')}`);
console.log(target.href);
这里的路径仍然是 /response-headers。查询串虽然包含文件名参数,却不是把接口改成了一个真实存在的 .txt 静态文件。排查自己的系统时,应使用实际导出地址,不必为了让地址看起来像文件而添加后缀。
复制构造结果到网站测速后,展开高级选项,明确选择 GET。这一步容易被忽略:页面的默认方式标为 HEAD,而本例还要观察实际返回的正文体积。GET 和 HEAD 也可能被业务程序分别处理,不能拿另一种方法的结果直接替代。
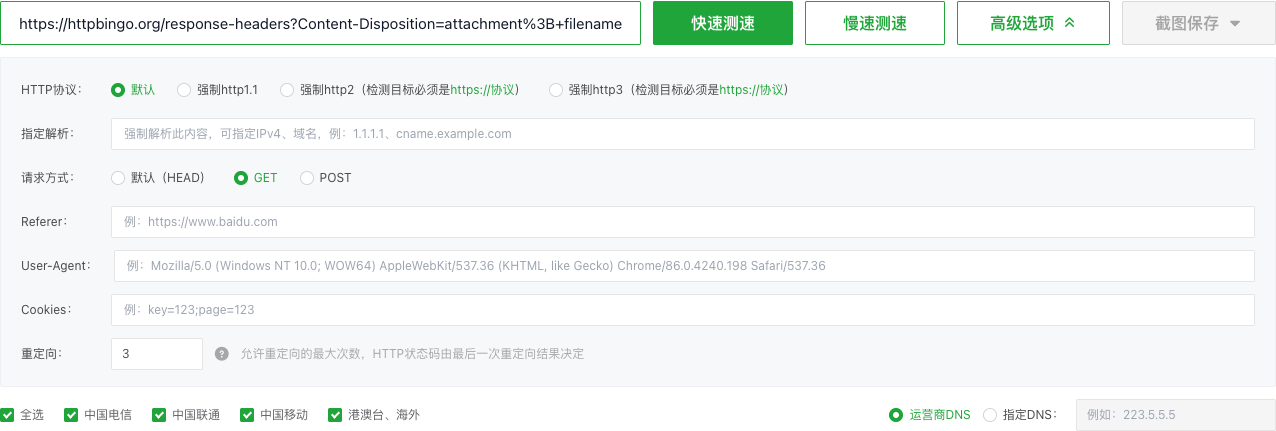
如果完整 URL 中出现 %25E6,先别急着“修乱码”。本例有两层编码:中文文件名先变成扩展参数里的 %E6…,整条头字段再作为 URL 查询参数传输,百分号会编码成 %25。应检查最终响应头,而不是只凭地址栏中的编码样子判断文件名是否错误。
在节点详情里保留完整响应头
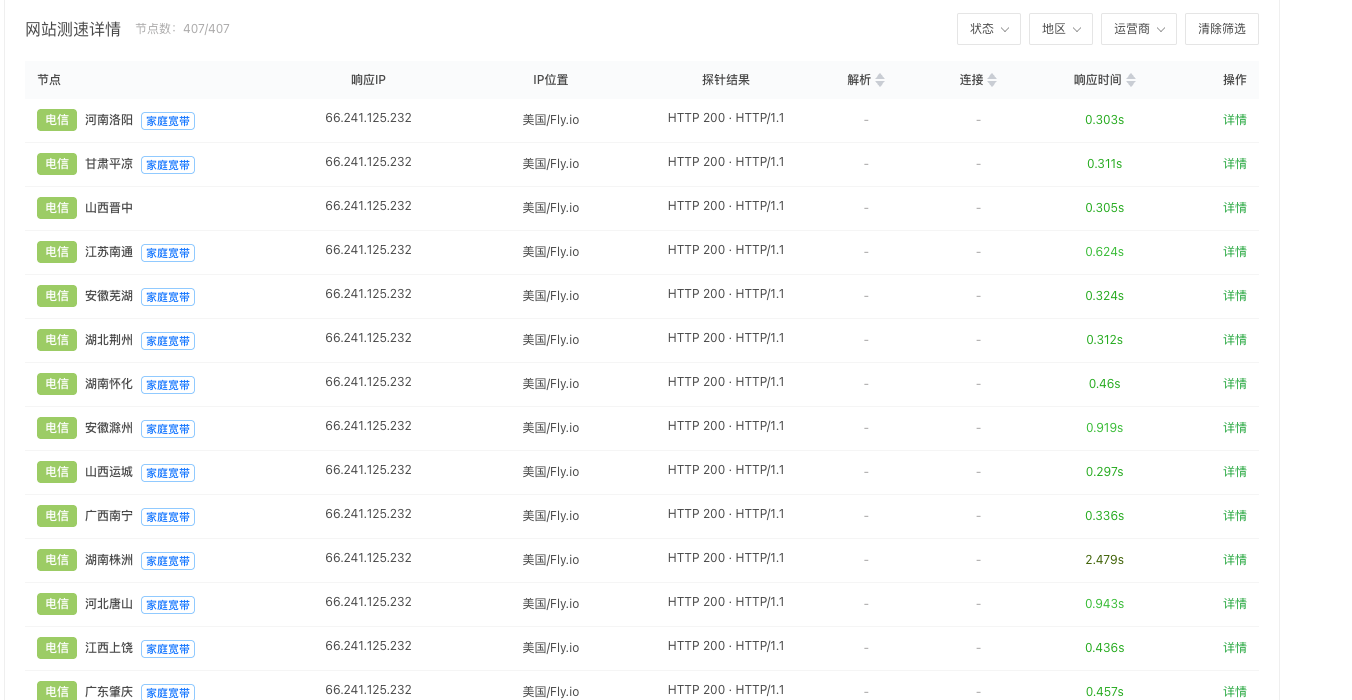
等待任务结束后,从结果表选择一条返回 200 的记录,再打开详情。本次表格展示的是部分节点,不能由这一屏推断全部节点都成功;本文也不依据这次测试给节点速度排位。
河南洛阳电信节点的详情给出了 HTTP 200、无重定向和 205B 下载体积。响应头中既有 Content-Disposition,也有 Content-Type: application/json; charset=utf-8。
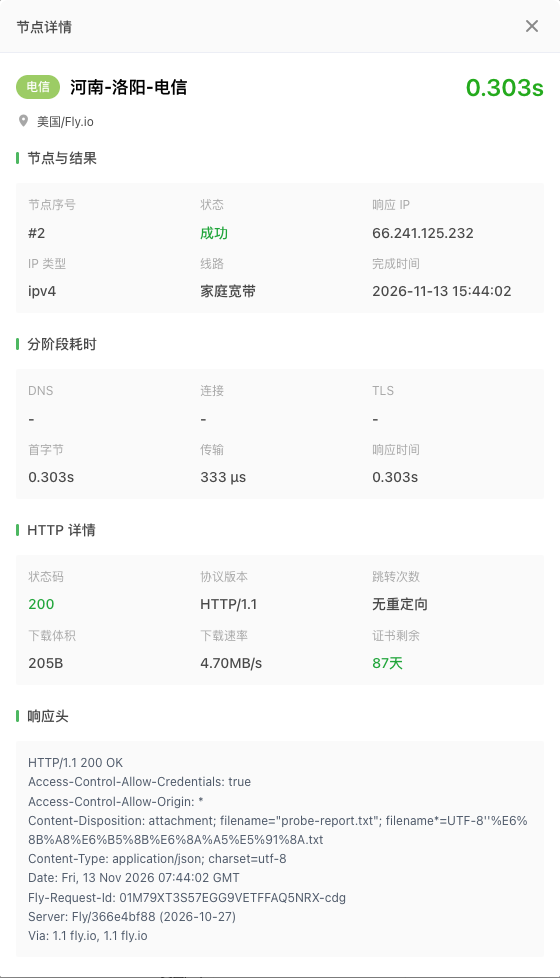
这份响应中的关键字段是:
Content-Disposition: attachment; filename="probe-report.txt"; filename*=UTF-8''%E6%8B%A8%E6%B5%8B%E6%8A%A5%E5%91%8A.txt
attachment 表达希望把响应作为附件处理。filename 是普通文件名参数,这里给出 probe-report.txt;filename* 是扩展形式,用于表达中文等字符。本例按 UTF-8 字节做百分号编码,解码后是“拨测报告.txt”。
UTF-8'' 中间没有漏内容。扩展值由字符编码、可选语言和实际值组成,两个单引号之间的语言项可以为空。这里声明的是文件名参数的编码,不能据此推断文件正文一定用相同编码。
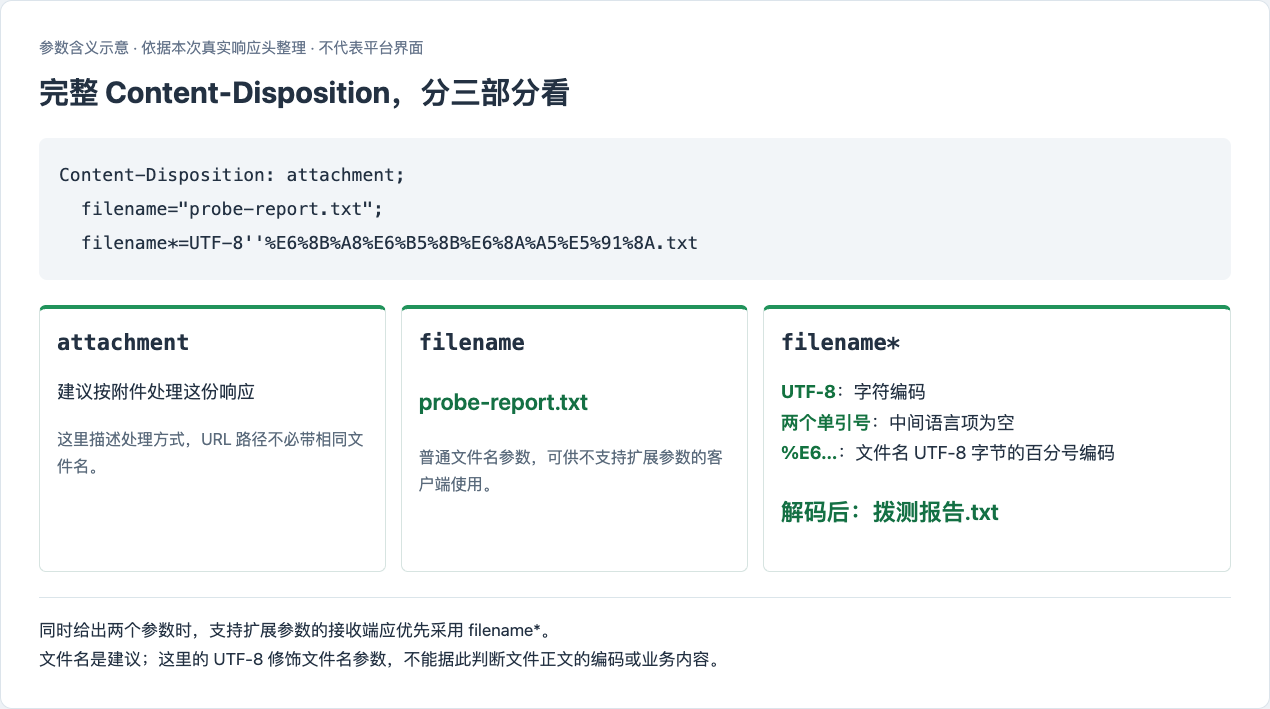
RFC 6266 对同时存在的两个参数给出了接收端优先采用 filename* 的建议,普通参数可供不支持扩展形式的客户端使用。不过,服务端提供的仍是建议名称。浏览器、操作系统的文件名处理,以及用户手动改名,都可能影响最后落盘的名称。
如果只有某个旧客户端下载成英文名,而另一个浏览器显示中文,先保留两边的原始响应和客户端版本,再判断是没有识别扩展参数,还是请求途中有程序改写了头字段。仅靠两个不同名字还不能确定原因,也不应直接删掉普通名参数,试图让所有客户端强制采用中文。
因此,头字段能说明服务器怎样声明下载,浏览器是否采用这份声明,还要继续看客户端结果。
让 Chrome 真正下载,再核对建议名
这次让 Chrome 直接访问相同的构造地址,确实触发了下载事件。事件返回的 suggestedFilename 是“拨测报告.txt”,与扩展参数解码后的名称一致,没有采用普通参数中的英文名。
为把两个概念分清,脚本没有直接拿建议名作为证据文件名,而是通过 saveAs() 保存到固定路径 research/downloaded-response.bin。保存完成后重新读取磁盘文件,得到 205 字节,下载失败信息为 null。
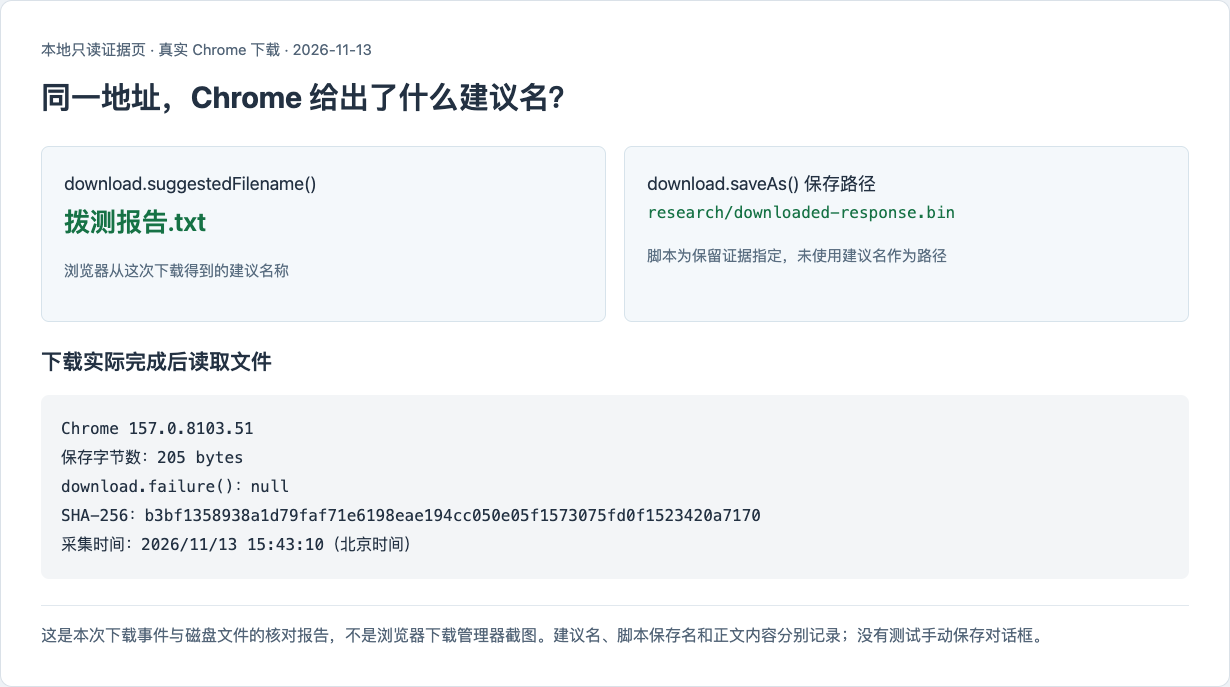
这张图是根据实际下载结果生成的本地证据页,不是浏览器下载管理器截图。它保留了浏览器版本、保存字节数和 SHA-256,方便后续确认看的还是同一份文件;这次没有测试用户在保存对话框里改名的过程。
记录问题时也应这样区分:中文建议名是否正确,是客户端命名问题;指定目录是否真的出现文件,是保存结果问题。只把证据路径写成“拨测报告.txt”,反而容易让人误以为这是浏览器自动决定的最终磁盘路径。
探针访问和本地 Chrome 下载是两次独立请求。它们收到相同的头字段、正文长度一致,可以分别支撑各自的观察;不能据此认为经过相同链路,也不适合拿两次耗时比较客户端性能。
名字叫“报告”,里面也可能只是 JSON
文件名正确,接下来还得看正文。读取刚保存的文件后,按 UTF-8 解码并执行 JSON.parse(),解析通过,内容只有 Content-Disposition 与 Content-Type 两个字段的回显。下面展示的是实际文件全文,没有拿示例文字替换。
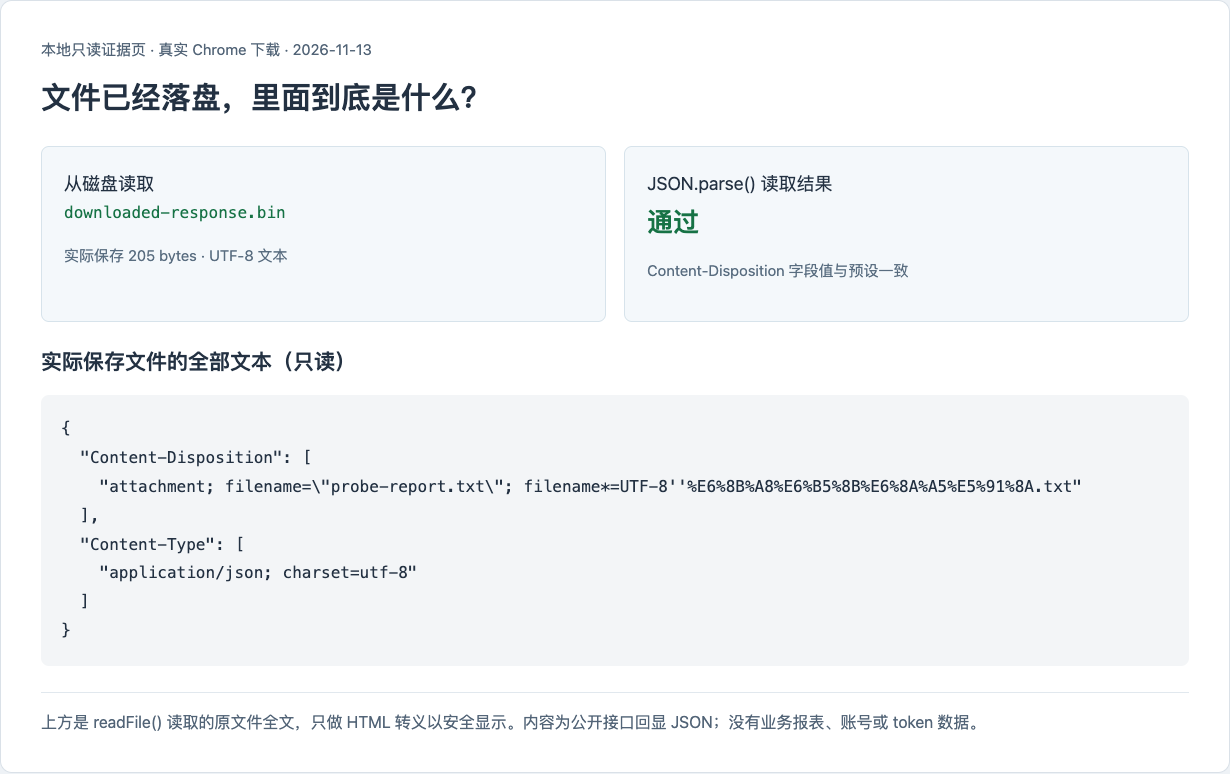
所以,本例虽然建议保存为“拨测报告.txt”,它仍是一段 JSON 文本,不是一份生成好的业务报告。脚本保存成 .bin 也没有改变这些字节。把同样的内容改名为 .pdf 或 .xlsx,不会自动完成格式转换。
需要留意,文件正文里也出现了 Content-Disposition 这个字段名,那是测试服务为了演示而回显的数据。判断浏览器收到的响应头,依据仍是前面的节点详情和浏览器请求记录,不能把正文里的同名 JSON 字段直接当成 HTTP 响应头。实际业务接口通常不会把头字段再写进文件内容。
Content-Type 同样值得核对。这里声明 application/json; charset=utf-8,与实际正文能够解析为 JSON 相符。排查真实导出接口时,如果原本预期是 PDF,实际收到 HTML 登录页或错误 JSON,即使状态码是 200、下载动作完成,也应回到身份状态、导出任务和最终接口响应继续查。
正文大小只能辅助判断。本次 205B 说明保存了非空内容,不说明报告完整;另一份合法的小文件也可能很短。表格看行列,PDF 看能否解析及页内容,压缩包看能否列出预期文件,最终还要按业务预期核对内容。
遇到自己的下载问题,按这几项回查
先把问题落到具体一项,后续处理会清楚一些:
| 看到的现象 | 优先核对什么 |
|---|---|
| 中文名显示为一串百分号 | 保留原始 Content-Disposition,确认是否使用 filename*,编码和实际客户端表现是否对应 |
| 名称正确,打开却是错误提示 | 检查 Content-Type 与实际正文,确认是否拿到登录页、错误 JSON 或过期导出结果 |
| 入口有头字段,最终名字不符 | 沿重定向继续检查真正返回正文的那份响应 |
| 接口头字段没问题,页面下载名仍不同 | 查看页面是否先取回数据、创建 Blob,再由前端代码设置名称 |
本例没有重定向,采用的是直接导航下载。若自己的地址先跳到另一个存储服务,最初入口的响应头不能代替最终文件响应;如果页面自己创建下载,则还要核对页面代码参与命名的部分。
还有一个容易混淆的地方:下载事件能够得到中文建议名,不代表任意跨源页面脚本都能通过 Fetch 读取 Content-Disposition。脚本对响应头的可见性需要单独按 CORS 与响应头暴露规则核对。此次没有把跨源 Fetch 读头作为成功条件,也没有验证这条独立流程。
给同事反馈时,可以同时留下原始头字段、浏览器建议名、实际保存名与一份可核对的正文。这样遇到“中文名没问题,但文件打不开”的情况,下一步就能直接检查内容,而不会继续在 URL 后缀上来回修改。
