中文参数怎么做 URL 编码?重复编码怎么检查?
把中文关键词拼进查询地址后,内容少了一截;原本的加号到了程序里却变成空格;解码一次,结果里还留着 %2F。这些问题都需要先弄清楚:当前处理的是原始参数值、已经编码的文本,还是一条完整地址。
宝塔拨测的「URL 编码 / 解码」工具可以转换字符串,并对照转换前后的内容。下面使用虚构文本演示,不需要准备账号信息或真实业务链接。
先把一个参数值编码,再解码核对
打开工具,在「URL 编码」页签的「输入字符串」框中粘贴:
中文 参数+A&B
其中「中文」后面有一个半角空格,后面还包含加号和 &。输入后,下方「转换结果」会自动更新,无需再找转换按钮。结果为:
%E4%B8%AD%E6%96%87%20%E5%8F%82%E6%95%B0%2BA%26B
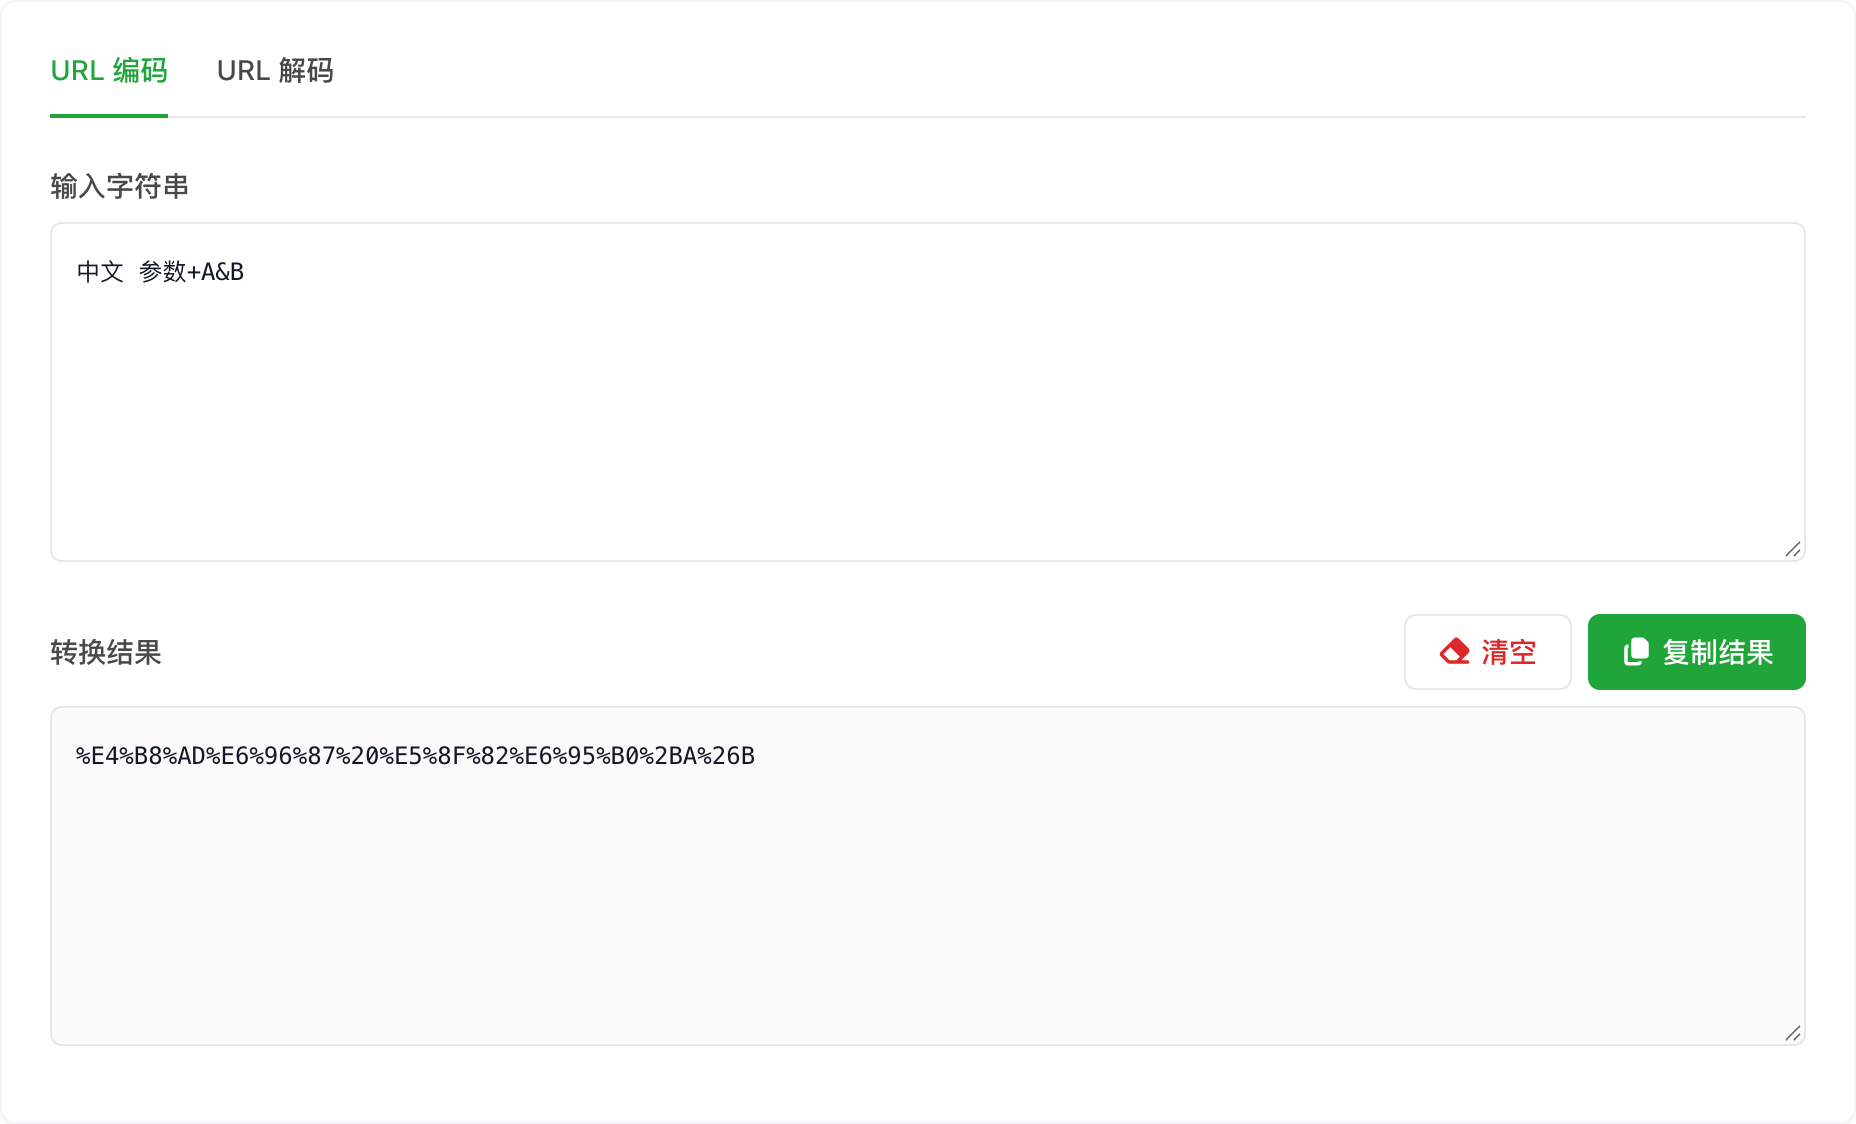
这里的中文按 UTF-8 转成百分号编码,空格变成 %20,原文中的 + 变成 %2B,& 变成 %26。后两项尤其容易漏:查询字符串里的 & 通常用于分隔参数,属于内容的 & 如果原样拼进去,可能被当成下一项参数的开始。
点击「复制结果」,切换到「URL 解码」,把刚才的结果粘贴到「输入已编码的字符串」。下方应恢复为原文,空格、加号和 & 都要一致。
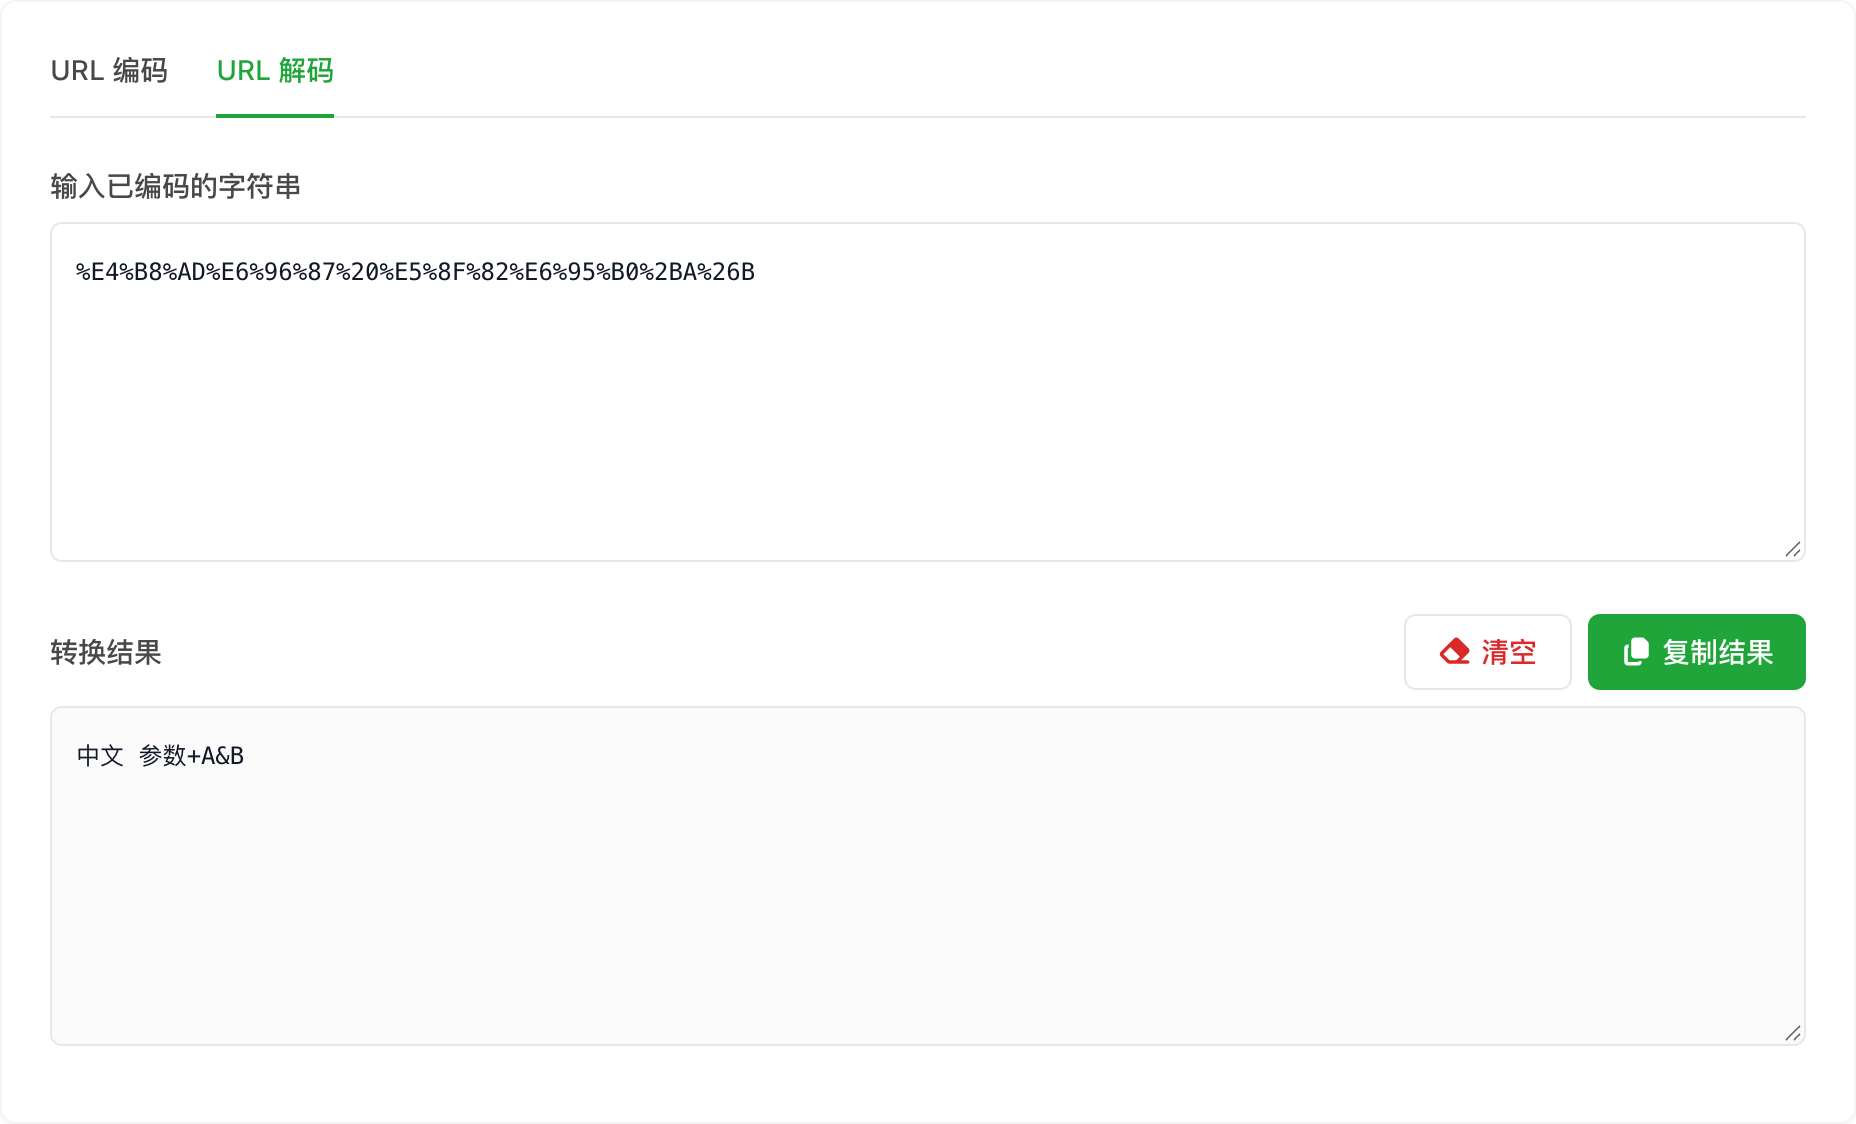
核对时不要只看中文有没有恢复。符号丢失、空格多出一个,也会让实际参数值发生变化。需要重新输入时,当前页签的「清空」按钮可以清掉输入和结果。
拼查询地址时,只编码需要作为内容的部分
假设要把上面的文本放进搜索地址的 q 参数,应先编码参数值,再把结果放到 q= 后面。下面是拼好的示例,域名仅供说明:
https://example.com/search?q=%E4%B8%AD%E6%96%87%20%E5%8F%82%E6%95%B0%2BA%26B
地址中的 https://、路径 /search 和 ?q= 仍然负责表达地址结构,只有 q 的内容经过了转换。若还有其他参数,用于分隔参数的 & 也要保留在值的外面。
本工具使用的是 encodeURIComponent 和 decodeURIComponent。它把输入当作一个需要转换的字符串,不会判断你粘贴的是参数值还是完整地址。把整条地址放进编码框,冒号、斜杠、问号和等号都会被编码。
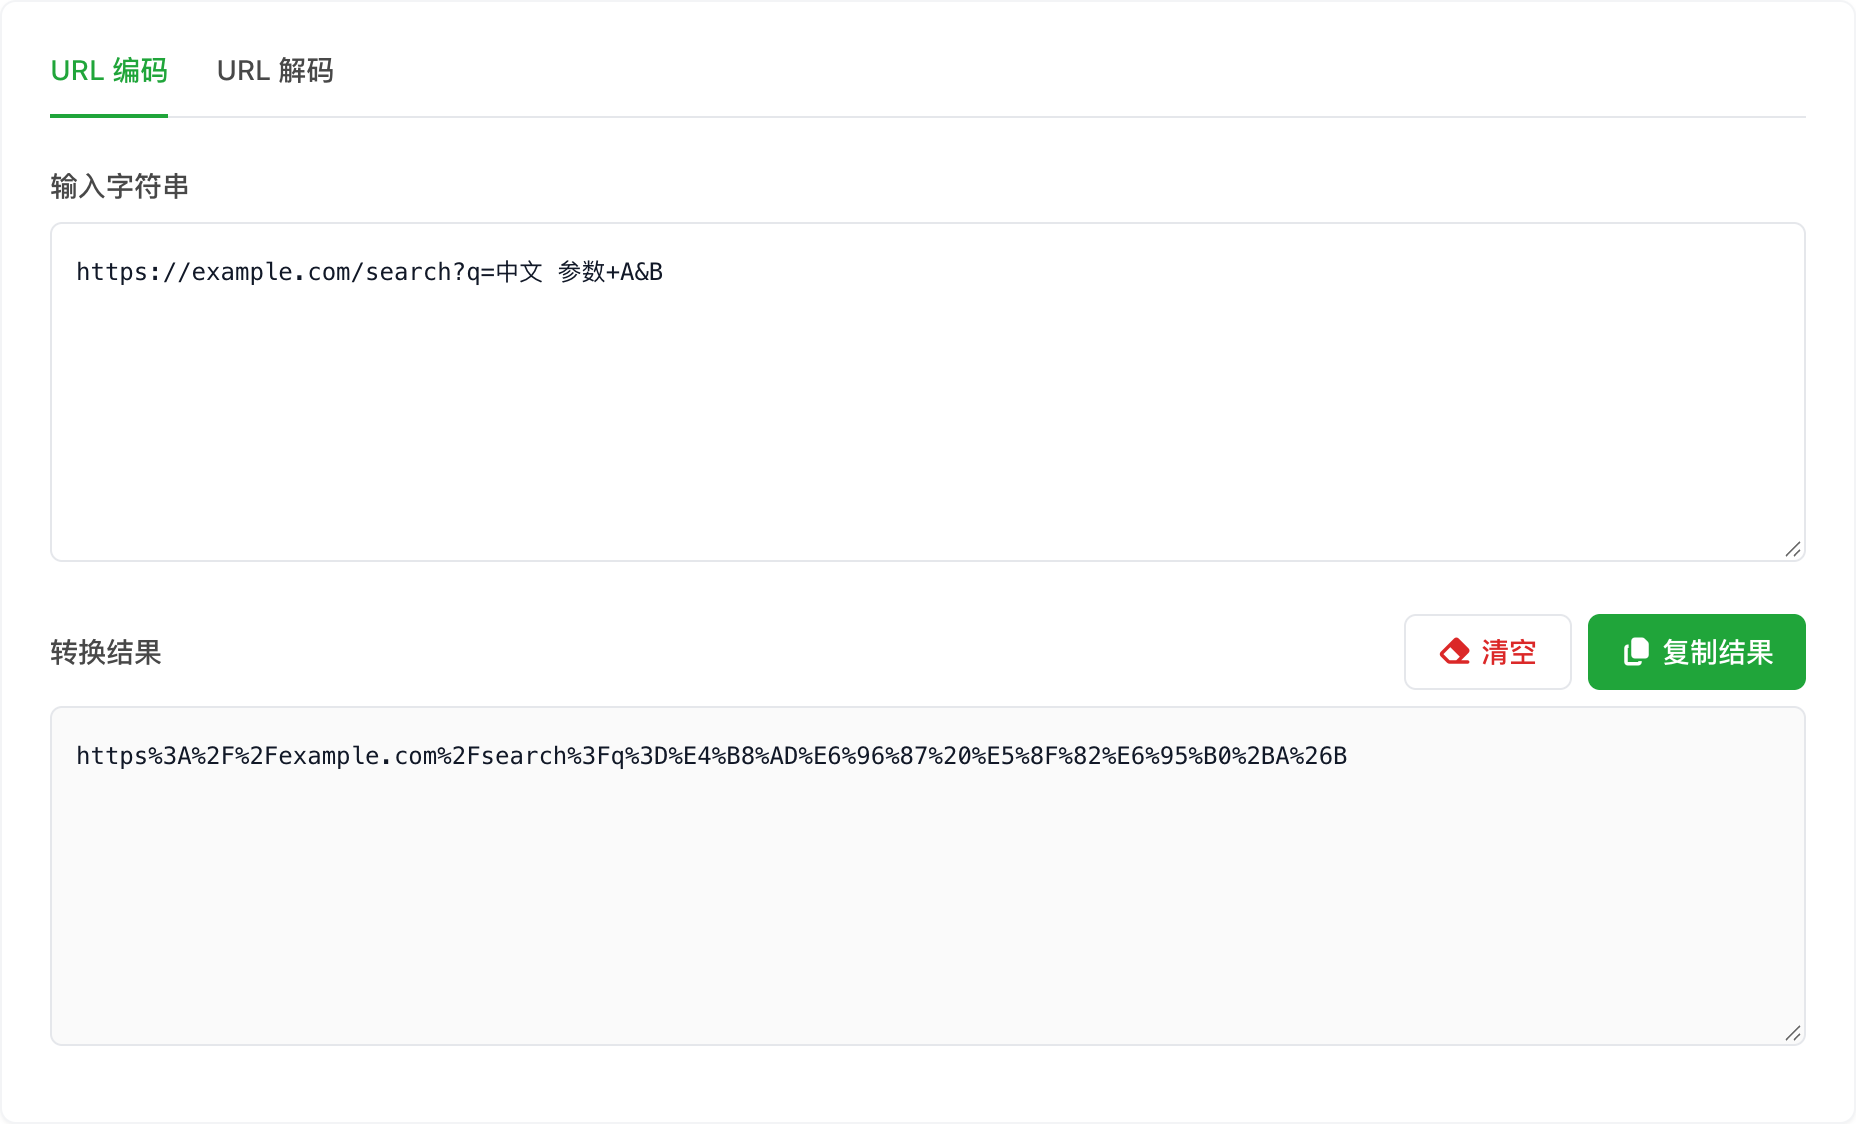
这种结果适用于「整条地址本身就是另一个参数的值」等场景,例如把回跳地址装进外层参数;它不能直接替代原来准备访问的地址。具体需要编码哪一层,要按接收方的参数约定判断。不要为了处理中文,把一条已拼好的业务地址整体转换后直接替换。
查看已有地址时,也不要先把整条地址解码,再按 & 拆分参数。示例中属于 q 内容的 %26 会恢复为 &,这时再拆分,就可能把一个值误分成两项。程序读取查询参数时,可以让 URLSearchParams 先按查询字符串规则解析;取出的值已经解码,不要再无条件解码一次。
如果程序使用 URLSearchParams 生成查询字符串,应把原始文本交给它,让它完成编码。把本工具得到的编码结果再传进去,会把其中的 % 再编码一次。
加号与空格,要看采用哪种规则
切换到「URL 解码」,输入下面这段文本:
A+B%20C%2BD
本工具返回 A+B C+D。第一个裸加号仍是加号,%20 还原为空格,最后的 %2B 还原为加号。
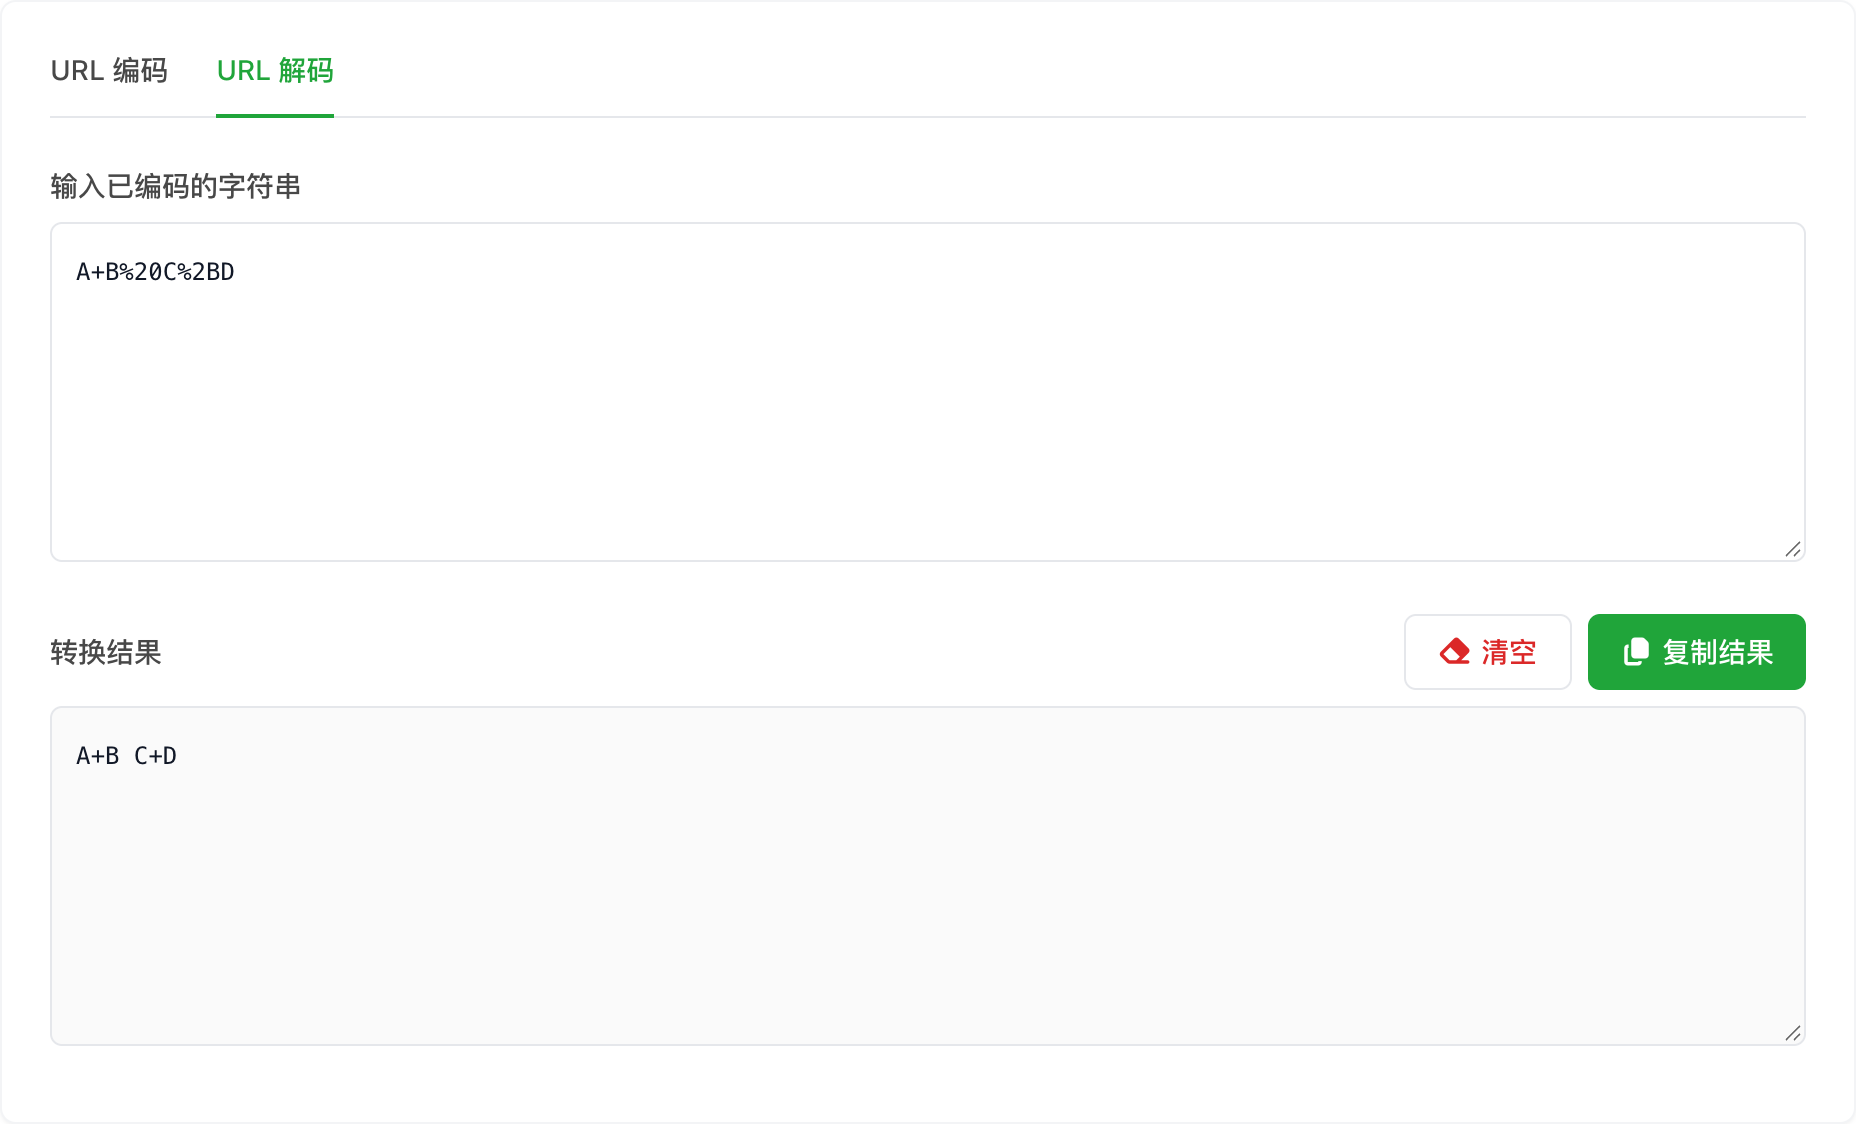
因此,不能把本工具理解为「所有加号都会变空格」的表单解析器。HTML 表单常用的 application/x-www-form-urlencoded 规则会把空格写成 +,解析时再把裸 + 当成空格。URLSearchParams 也采用这套规则。
同样的 q=A+B%20C%2BD 交给 URLSearchParams 解析,取出的 q 会是 A B C+D,与本工具直接解码的结果不同。两者处理的规则不同,不代表其中一个结果错了。
排查「加号为什么变空格」时,先确认数据是否来自表单编码或查询参数解析。需要表达真正的加号,应让它以 %2B 传递。不要对所有来源的字符串统一把 + 替换成空格,那样会改掉原本就有的加号。
看到 %25,按层检查是否重复编码
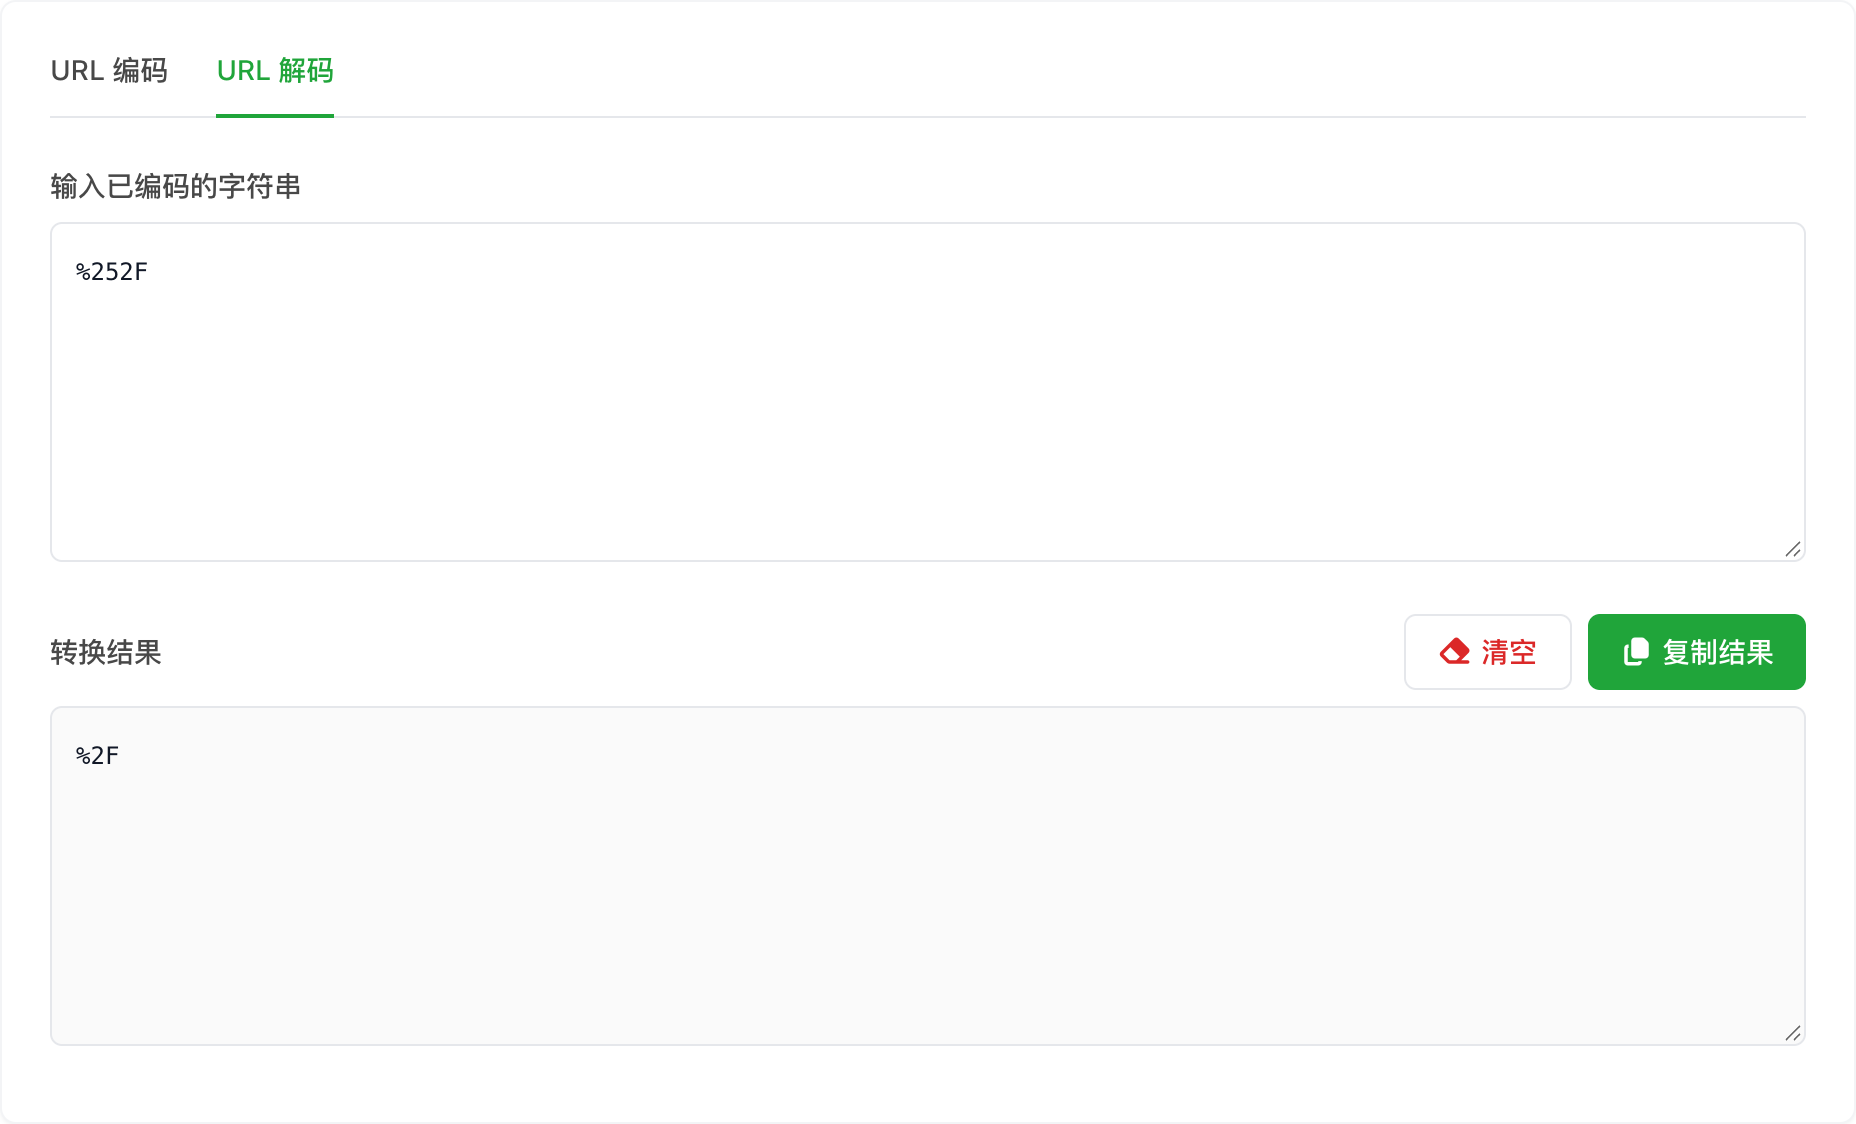
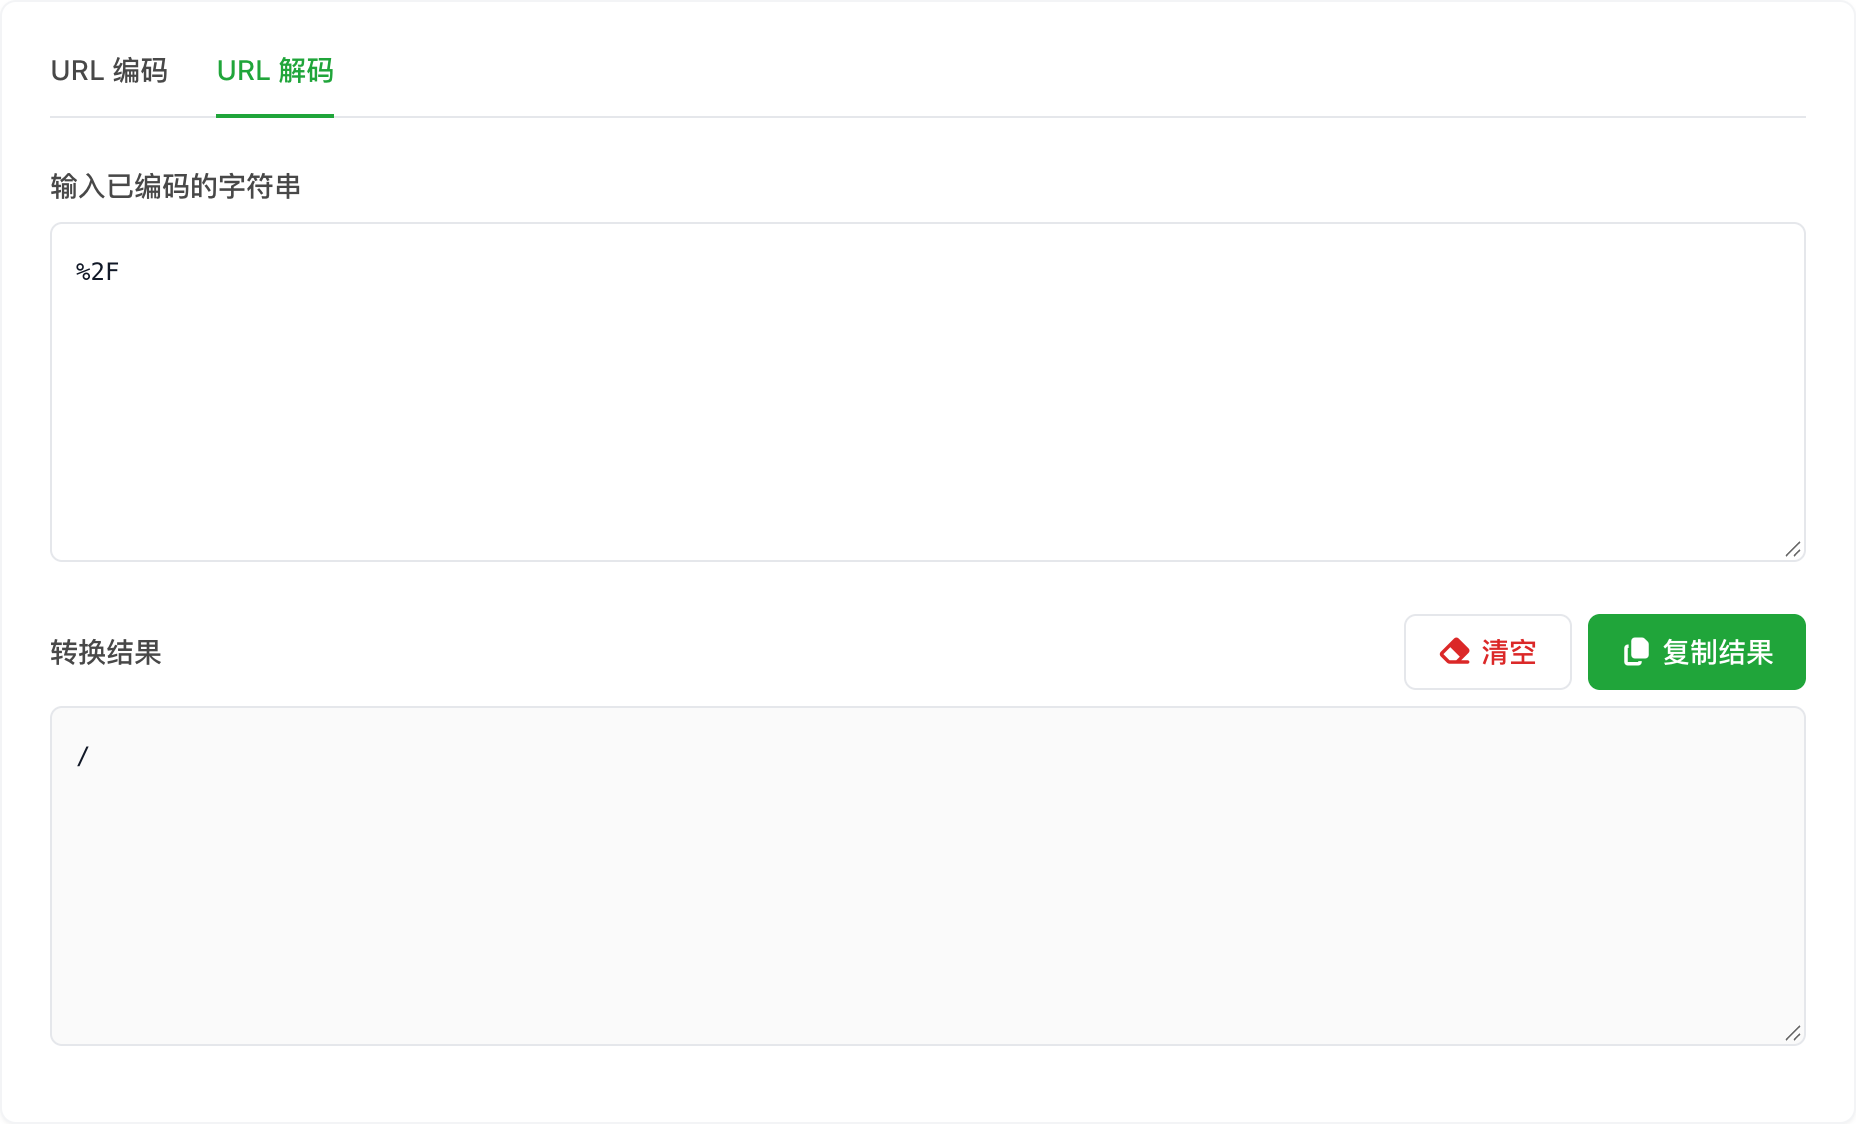
斜杠 / 编码后是 %2F;若再把 %2F 编码一次,百分号会变成 %25,于是得到 %252F。解码时也只能一次还原一层。
在「URL 解码」中输入 %252F,结果为 %2F,此时还没有恢复成斜杠。
再把结果 %2F 放回上方输入框,结果才变成 /。
这个对照可以帮助检查编码层数,但看到 %25 并不能直接认定业务出错。原文可能本来就包含百分号文本,嵌套参数也可能有意保留多层编码。先保留原始内容,再逐次解码,并对照接口文档或程序预期的值判断应停在哪一层。
如果接口期望的值是 /,收到的却是 %2F,可以沿着「原始值、生成请求、接收解析」几个位置检查,确认是否多做了一次编码,或少做了一次解码。不要在正式请求里循环解码直到没有百分号,这可能把原本作为内容的符号变成地址分隔符。
解码报错时,先核对原始文本
如果输入末尾只剩一个 %,或百分号后面的编码被截断,工具会提示「无法解析此字符串:不是合法的 URL 编码」,并清空结果。编码字节不是合法 UTF-8 时,也可能无法解码。
这时先检查复制是否完整、日志有没有截断,以及原始编码是否采用 UTF-8。不要为了消除提示随意删除百分号。工具能帮助确认字符串怎样转换;最终请求能否按预期处理,还需要在实际程序中核对接收后的参数值。
