robots.txt 怎么生成?限制目录、Sitemap 和单独爬虫规则怎么核对
准备给网站写 robots.txt 时,先列清楚哪些路径不希望被抓取,再生成文件,比直接选“全部拒绝”更容易核对。本篇用宝塔拨测的 robots 文件生成工具,演示两个目录限制、一条 Sitemap,以及单独设置 Googlebot 后的输出变化。
以下目录与域名都是示例。操作只发生在生成器里,没有上传文件,也没有改动任何网站的抓取配置。
先清理默认目录,再填写自己的路径
进入「站长工具 → robots 文件生成」。页面初始有一条 /bin/ 限制目录,不应不加检查地沿用到自己的站点。
本例将限制目录改成 /private/ 和 /drafts/,其他空框保持为空。在 Sitemap 中填写完整示例地址:
https://example.com/sitemap.xml
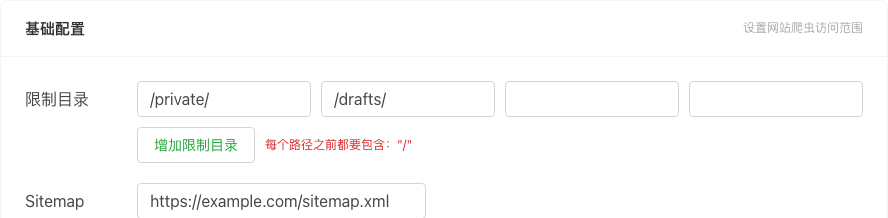
目录路径从 / 开始,表示相对网站根路径的位置。例如 /drafts/ 针对以这个目录路径开头的内容,不是服务器磁盘里的文件夹路径。不要填写 /www/wwwroot/... 一类服务器本地位置。
如果现有输入框不够,可以使用「增加限制目录」或「增加 Sitemap」。每一项都应核对实际站点路径;Sitemap 要填真实可访问的完整地址,不能只写一个文件名。这里的 XML 地址仅用于演示生成文本,不代表示例站点存在这份文件。
允许一般抓取,同时排除指定目录
将「所有搜索引擎」保持为「允许」,各个搜索引擎先保持「默认」,搜索间隔保持「不限」,然后点击「生成」。本次得到的规则主体为:
User-agent: *
Disallow:
Disallow: /private/
Disallow: /drafts/

Sitemap: https://example.com/sitemap.xml
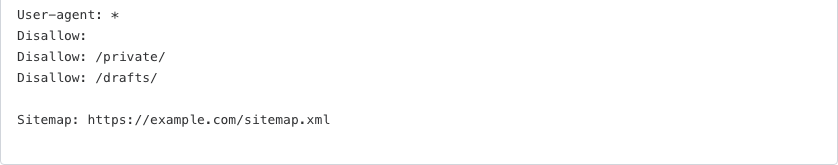
User-agent: * 表示通用规则组。单独的空 Disallow: 不指定禁止路径,后面两条非空规则仍然限制各自的目录;不能只看到空行,就判断整份文件没有限制。
核对结果时,逐行看路径有没有多一个字符、少一个斜杠或大小写不一致。/drafts/ 和 /Drafts/ 不能当成相同路径。Sitemap 是提供站点地图位置,不会覆盖上面的禁止规则,也不会自动创建或提交站点地图。
单独选择爬虫后,再生成一次
接着在国外搜索引擎的「谷歌」一项选择「拒绝」,其他设置不动,再点击「生成」。结果中新增:
User-agent: Googlebot
Disallow: /
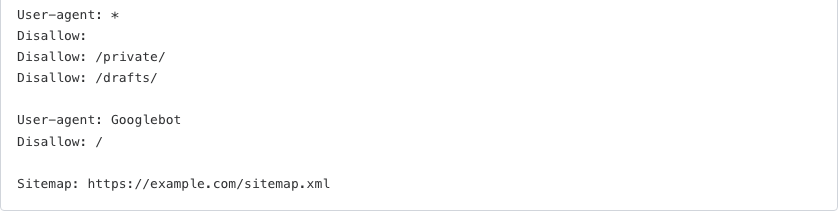
这组规则对 Googlebot 提出了全站不抓取的要求。它不是只禁止前面两个目录,也不能理解成“通用组允许,所以 Googlebot 仍被允许”。匹配到更具体的用户代理组后,应按该组规则判断,不能把不同组按个人理解随意叠加。
本步骤是用来认识输出变化,不是所有网站都应该照做。正式使用前,应把试验中不需要的“拒绝”恢复为“默认”,重新生成并通读最终文本。改变表单后要再次点击「生成」,不要把上一轮结果当成新规则。
搜索间隔能生成,不表示所有爬虫会执行
本次另将搜索间隔填为 10、单位选为“秒”,生成文本增加了 Crawl-delay: 10。这证明生成器能输出该字段,不证明每种爬虫都支持它。
Google 公布的 robots.txt 支持规则不包含 crawl-delay。如果目标是控制某个搜索引擎的抓取频率,应核对该搜索引擎自己的支持方式,不能因为文件里出现了这一行,就认为访问会严格间隔十秒。
文件生成之后,还差发布和验证
确认规则后,将最终文本保存为 UTF-8 纯文本文件,文件名为 robots.txt。实际网站需要把它放到对应主机的根路径,例如 https://example.com/robots.txt,并从浏览器打开该路径,确认返回的是预期文本。子目录下的同名文件不能替代根路径文件,其他子域名、协议或端口也需分别核对适用范围。
本篇没有执行上传,因此截图不证明任何线上站点已经采用这些规则。部署后还应检查公开响应内容,并按目标爬虫的规则测试路径是否匹配。
robots.txt 是给遵循协议的爬虫看的抓取约定,不是访问权限控制。需要保护的后台、草稿和私密文件,仍要通过登录鉴权和服务器访问规则限制;只把路径写进 Disallow,不能阻止浏览器或不遵守规则的客户端直接请求它。
