canonical标签怎么核对?用蜘蛛抓取HTML,分清规范页与禁止收录
同一篇文章可以通过带参数、不带参数或不同栏目地址打开时,维护人员通常会为它声明一个规范地址,也就是canonical。检查的重点是服务器返回的HTML里有没有这项声明、它指向哪里,而不只是页面能否打开。
抓取需要核对的具体地址
打开“蜘蛛模拟抓取”,填入完整页面地址,选定蜘蛛类型后点“开始抓取”。本次用MDN的HTTP文档页 https://developer.mozilla.org/en-US/docs/Web/HTTP,保持“百度蜘蛛”选项,仅抓取这一页。
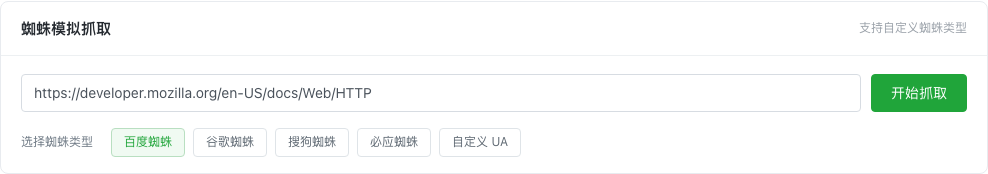
检查自己的文章时,要分别保留读者实际使用的地址。如果问题出在 ?from=... 这样的参数版本,先抓取这个版本,再与规范页核对。不要一开始就删掉参数,否则检查的已经是另一个请求。蜘蛛名称对应工具发出的User-Agent,不代表搜索引擎真的完成了抓取、收录或规范页选择。
最终地址和canonical要分别看
本次请求详情显示HTTP 200、跳转次数0,最终地址仍为这篇MDN文档。这说明该次请求没有靠HTTP重定向换到另一个页面;canonical则要继续到HTML里找,不能从“没有跳转”推断“没有规范地址”。
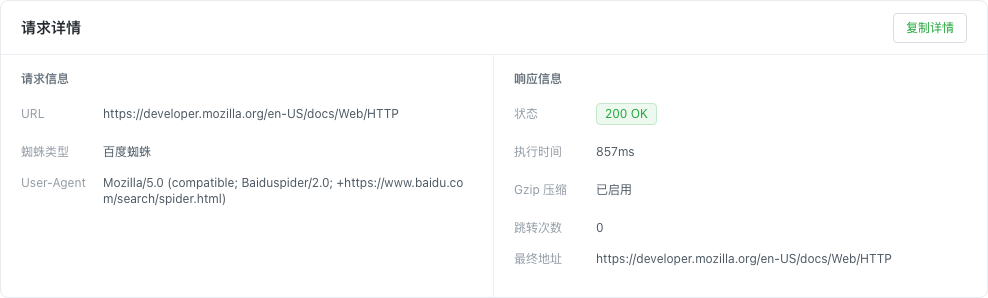
重定向与canonical解决的问题相关,但行为不同。301、308等HTTP重定向会让客户端按响应继续请求新地址;HTML中的canonical声明本身不会把当前浏览器自动带走。文章还能在原地址打开,与它声明了另一个规范地址并不矛盾。
当前工具的TDK卡片列出Title、Description和Keywords,并没有单独的canonical字段。不能把这张卡片中没有出现canonical,写成页面缺少canonical。应继续查看下面的“页面内容预览”,或使用“复制内容”后在编辑器里搜索 canonical。
在原始HTML中找声明
本次滚动工具的HTML预览,能看到一条 rel="canonical",其 href 指向当前文档自身。另一次直接读取公开页面源码也找到了相同地址。这是本次页面声明的自引用canonical,不是搜索引擎最终选定规范页的证明。
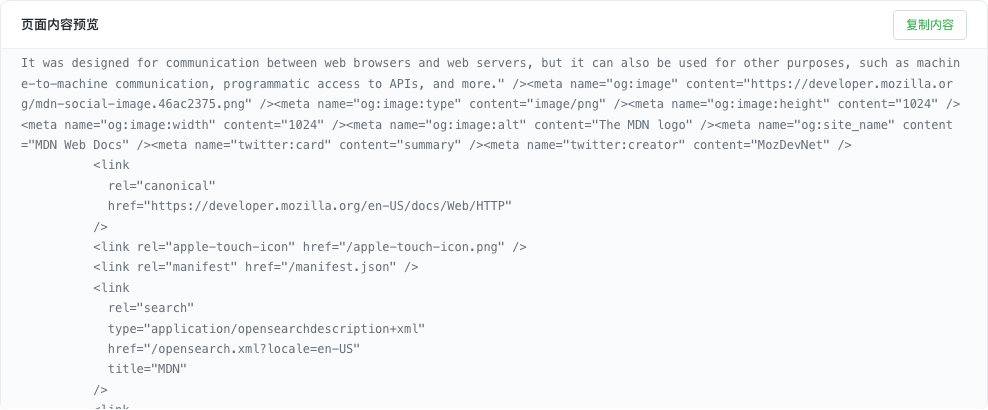
核对时应一起看标签和地址。rel="canonical" 用来声明关系,href 才是规范地址;只搜索到“canonical”这个单词,可能命中脚本、注释或正文示例。建议确认它是HTML头部中的有效 link 标签,目标协议、域名和路径是否符合预期,有没有多个互相矛盾的声明。若页面提示内容超过1 MiB被截断,预览中没找到标签,也不能据此确认完整页面没有。
有些页面会通过HTTP Link 响应头声明canonical,PDF等非HTML资源也可能采用这种方式。本文截图展示的是HTML标签,不能把HTML未发现的结果扩展成所有声明方式都不存在。
canonical、robots与noindex不能互换
canonical表达的是重复或相似内容之间的规范地址建议。对Google而言,它是一项信号,搜索引擎仍可能选择其他地址。robots.txt 的抓取规则主要控制抓取行为,禁止抓取也可能让搜索引擎无法读取页面里的canonical;它不适合代替规范页设置。
noindex 表示不要把页面加入索引,通常通过HTML的robots元标签或HTTP X-Robots-Tag 发送。它与“请把重复页信号归到这一个地址”不是同一个目的。想合并参数版本时,不要仅因为名字都与SEO有关,就同时机械添加禁止抓取和noindex。
本次从工具抓取到的HTML中没有解析出 meta name="robots" 或 meta name="googlebot",这只描述这份HTML,未审计全部HTTP索引指令。检查自己的网站时,可把来源地址、最终地址、canonical目标和索引指令逐项记下来;修改模板后重新抓取对应版本。至于搜索引擎采用了哪个规范地址,应再看搜索平台提供的URL检查结果。
