HTTP压缩怎么核对?分清Accept-Encoding、响应编码与下载体积
看到响应体只有几百字节,不能直接判断网站“压缩很好”。有的客户端会自动解压,有的检测只请求HEAD;页面上展示的大小,也未必是网络中压缩正文的字节数。核对压缩需要同时保留请求方式、编码头和实际正文。
先让工具请求正文
打开网站测速,输入公开测试端点 https://httpbingo.org/gzip。展开“高级选项”,把请求方式从默认HEAD改为GET。本次仅选“港澳台、海外”组,执行快速测速,不填写Cookies等账号信息。
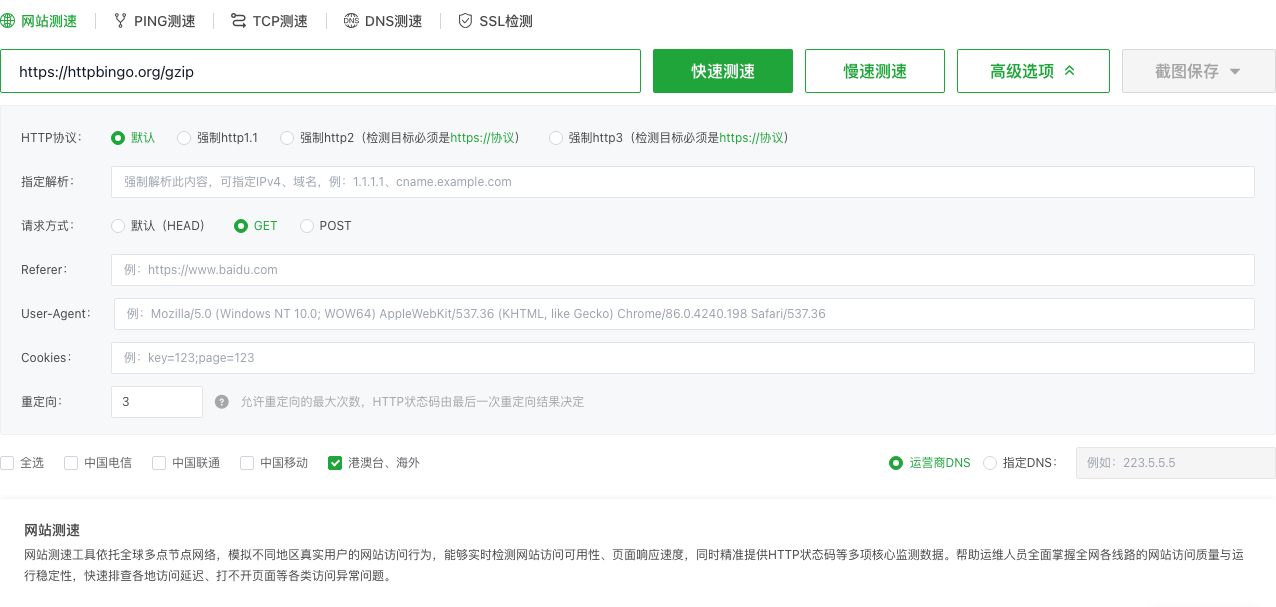
HEAD按HTTP语义不传送响应正文,适合看响应头,却不能拿本轮零正文下载来衡量GET的压缩效果。当前高级选项可以选择GET,但没有独立的任意请求头输入项,本文没有在界面里伪造 Accept-Encoding 控件。
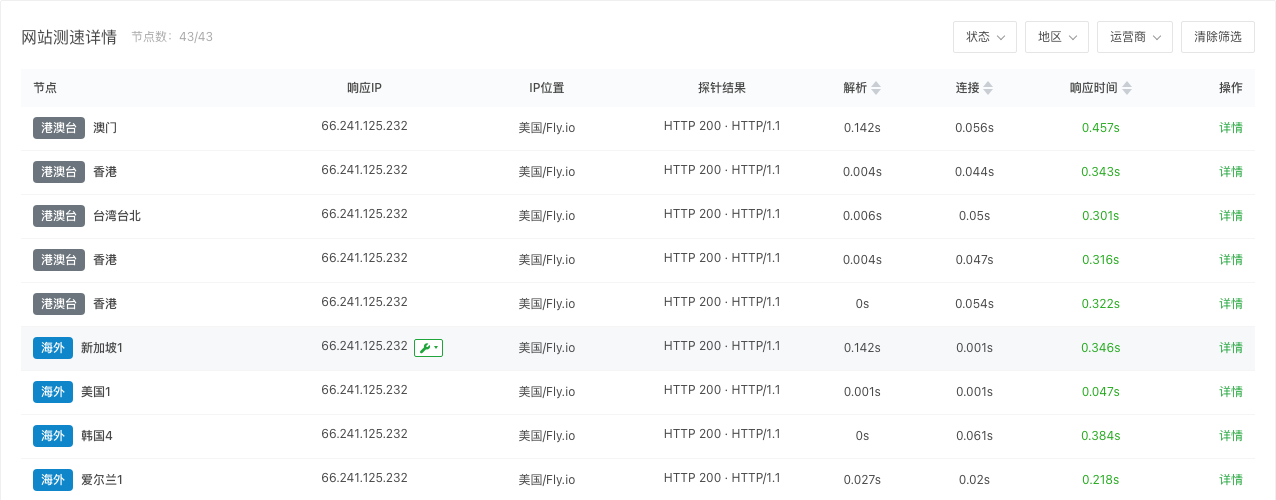
本轮实际完成43/43个节点,列表可见HTTP 200和HTTP/1.1。这只能先确认这些请求取得了响应;要了解某个节点的正文大小和响应头,继续点该行“详情”。
工具展示值要保留它自己的口径
本次澳门2节点详情显示200、无重定向、下载体积667B。响应头列表没有展示 Content-Encoding。这份界面不足以确认该667B是压缩前还是解压后的正文,也不能据此宣布目标未启用gzip。
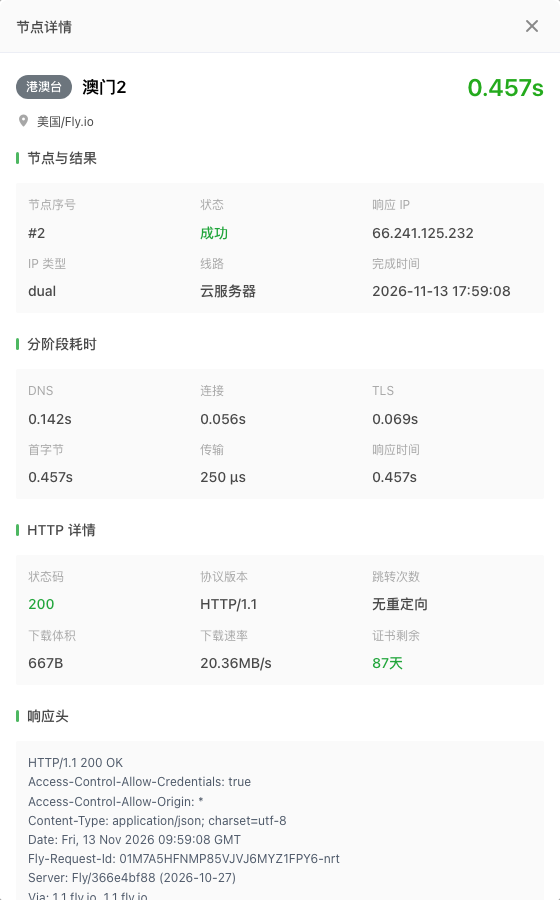
客户端、代理与检测服务之间可能存在解码处理,界面字段不等于原始传输抓包。本次没有证据确定哪一环进行了处理,因此保留这项限制,再用单独的客户端请求补查。不要拿这个667B与另一轮本地请求的字节直接相减来计算“节省流量”。
三个头字段分别回答什么
Accept-Encoding 是请求头,表达客户端接受的内容编码,例如gzip、br或identity;Content-Encoding 是响应头,说明这份表示实际使用了什么编码。Content-Type 则描述内容类型,JSON即使经过gzip压缩,类型仍然可以是JSON。
Vary: Accept-Encoding 告诉缓存:选择响应时考虑了这个请求头,后续匹配缓存也要考虑它。它不是“压缩已开启”的开关,也不是所有压缩响应都必须无条件出现的固定装饰。应结合服务器是否真的按该请求头选择不同表示判断。
用不自动解压的请求核对真实字节
本次在本地另发GET,显式发送gzip,并保留收到的正文,没有启用curl自动解压。它与平台节点是两组独立请求:
curl -sS -H 'Accept-Encoding: gzip' \
  -D gzip-headers.txt -o gzip-body.bin \
  -w '%{size_download}\n' https://httpbingo.org/gzip
本次响应包含 Content-Encoding: gzip 与 Content-Length: 294,保存文件也是294字节,开头为gzip标记 1f 8b。独立解压同一个文件后,正文为597字节。这两个数字分别属于编码后的正文和解码后的正文,均不包括TLS、HTTP头等整条连接的全部开销。
这个测试端点还有一项需要注意的行为:另一轮本地请求即使发送 Accept-Encoding: identity,仍返回gzip;两轮都没有Vary。它是用于展示压缩响应的测试端点,不能拿这组结果作为正常站点已经按客户端能力正确协商编码的证明。两轮回显包含的请求信息不同,正文长度也不同,不宜当作同一份内容的压缩前后对照。
检查自己的站点时,应固定URL、请求方法和内容版本,再分别核对编码选择、缓存变体与同一响应的原始字节。如果用自动解压选项保存文件,应明确文件已经解码,不能把磁盘文件大小当作压缩正文大小。只有这些条件对应起来,才有依据讨论具体资源的体积变化;不能由一条响应头推断源站整体已经优化完成。
