拨测结果怎么理解
拨测结果最容易被误读的地方,是只看了最差的那个数字。
一整页节点列表,只要有一个 3 秒的延迟跳出来,很多人立刻判定「服务器挂了」。但真相往往是:那个节点所在的运营商在跟你的机房互联,和你服务器本身没半点关系。
这篇讲怎么把这些数字读对。
结果页上都有什么
一次网站测速跑完,页面上大致能看到四类信息:
- 总览:平均响应时间、最快节点、异常节点数量、成功率
- 分组明细:按中国电信、中国联通、中国移动、港澳台海外,再按华东华南等地区排列
- 单个节点:响应时间、状态码,部分工具还给丢包率
- 截图:可保存精简或完整截图,方便贴给别人看
大部分人的注意力都集中在「响应最慢」那一行,其实真正该看的是分布。
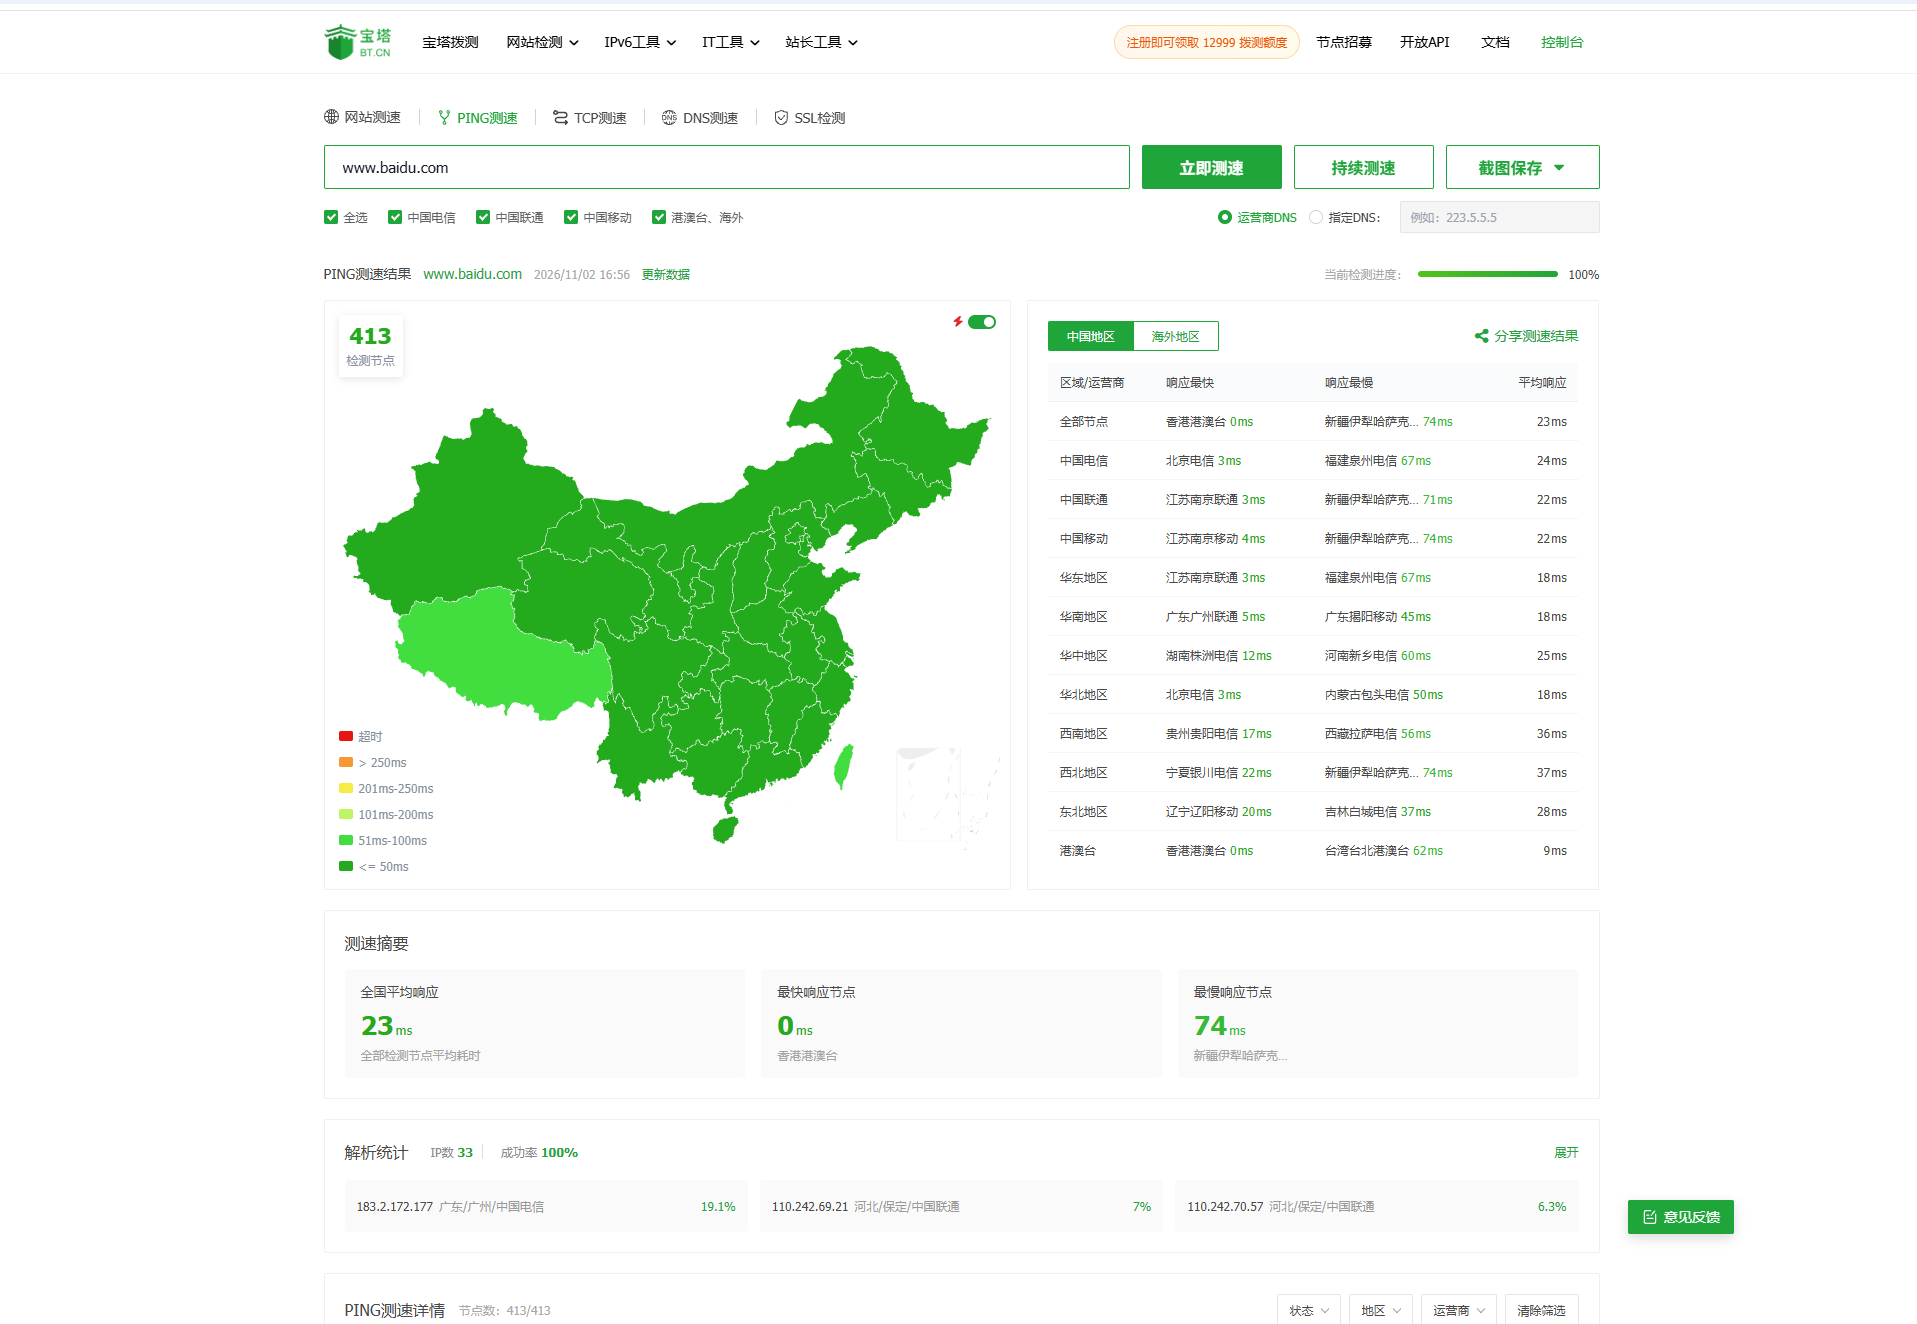
PING 检测结果:按运营商与地区分组,含最快、最慢与平均值
三步读法:平均、离散、分布
第一步:看平均值,建立基准线
平均响应时间是全国的总体水平,它是一个基准,不是结论。
举个例子:平均 0.22 秒,说明大部分节点访问是正常的。这时候如果有单个节点跑到 3 秒,它只是离群点,不是故障。
第二步:看离散程度,判断是普遍问题还是个体问题
同一运营商内部对比最有价值。比如电信组里,广州 0.04 秒、天津 0.7 秒,差了一个数量级——这不是「电信不行」,而是特定链路的问题。
判断标准很朴素:如果多数节点挤在一个相近的区间,少数几个远离,那几个就是要单独看的。 如果所有节点都散得很开,反而说明源站本身响应不稳定。
第三步:看异常节点的分布,定位责任方
这一步决定了你该找谁:
| 异常分布 | 大概率原因 | 下一步 |
|---|---|---|
| 集中在某一个运营商 | 该运营商到机房的互联问题 | 找运营商,或让 CDN 加节点 |
| 集中在某一个地区 | 区域性链路故障 | 路由追踪,看断在哪一跳 |
| 港澳台/海外全红,国内正常 | 跨境链路或被墙 | 检查是否有海外业务需求 |
| 全部节点都异常 | 源站、解析、证书、防火墙 | 先查源站和证书 |
状态码怎么念
状态码是拨测结果里信息密度最高的字段,但很多人直接跳过。
- 200:正常,重点看耗时
- 301 / 302:跳转,本身不是错误,但跳转链太长会拖慢速度
- 403:被拒绝,常见于源站或 WAF 把探针当攻击拦了
- 404:路径不存在,检查是不是测错了 URL
- 5xx:服务端错误,源站或后端应用的问题,和网络无关
- 超时 / 无响应:连不上,用 TCPing 进一步确认端口通不通
一条规则:能返回状态码,说明链路是通的,问题在应用层;连状态码都没有,才是网络层的问题。 这两类故障的处理路径完全不同。
延迟数字怎么算「正常」
没有绝对标准,但可以参考这几个量级:
- 0.5 秒以内:正常,用户体验良好
- 0.5 到 1 秒:可接受,偏慢
- 1 到 3 秒:明显慢,用户能感知到等待
- 3 秒以上:大概率有问题,尤其当它只出现在部分节点时
注意这是首字节时间还是完整下载时间,两者差很多。首字节慢,通常是源站处理慢;首字节快但下载慢,通常是带宽或资源体积问题。
三个常见的误判
只看最慢的节点。 一个 3 秒的离群点不影响整体,真正要看的是「有多少节点在什么区间」。
只测一次就下结论。 网络延迟天然波动,单次极值没有统计意义。连测两三次,看趋势。
把状态码和延迟混在一起看。 状态码正常但延迟高,是性能问题;状态码异常但延迟低,是配置或拦截问题。两件事。
想让结果有说服力,加一步截图
排查结论要交给运维、服务商或 CDN 厂商时,文字描述永远不如截图。结果页支持保存精简截图和完整截图,直接附在工单里,对方没有反驳空间。
常见问题
Q:为什么每次检测结果都略有不同? 网络延迟本身有波动,节点负载与路由也可能变化。建议连续检测两三次看整体趋势,而不是只看单次极值。
Q:平均值正常但用户说很慢,怎么办? 让用户提供所在地区和运营商,在 网站测速里对比该地区节点和其他地区的差异,再用路由追踪看具体哪一跳拖慢。
Q:出现大量 403 是什么原因? 多为源站防火墙或 WAF 拦截了探针的高频访问,可检查安全策略或临时放行。
Q:丢包率怎么判断严重程度? 偶发 1% 到 2% 可以观察,持续超过 5% 就该查链路了。
相关文章
-
什么情况适合多节点检测
宝塔拨测的多节点检测适合部分地区打不开、CDN 调度不符合预期、跨网访问明显变慢、怀疑域名被拦截或解析被污染等场景,由全国多地区、多运营商探针节点同时发起;相比本地单次 ping,多节点结果更能说明问题,也便于提交给运维或服务商核对。
-
宝塔拨测能做什么
宝塔拨测提供网站测速、Ping、TCPing、DNS 查询、SSL 证书检测与路由追踪六类多节点检测,全部由分布在全国多地区、多运营商的探针节点发起;此外还有端口检测、域名拦截、污染检测、QQ/微信拦截、ICP 备案、备案黑名单与 IP 归属查询等工具。
-
宝塔拨测怎么开始检测
宝塔拨测支持输入域名或 IP 直接发起检测,网站测速、PING、TCP、DNS、SSL 与路由追踪六类工具可在首页切换,也可直接进入对应工具页;检测前建议确认域名解析、端口开放与证书状态,避免把配置问题误判为网络故障。