正则测试只出一个匹配、<.*> 吞掉整段?g/i/m/s 四个开关与贪婪、分组一次讲清
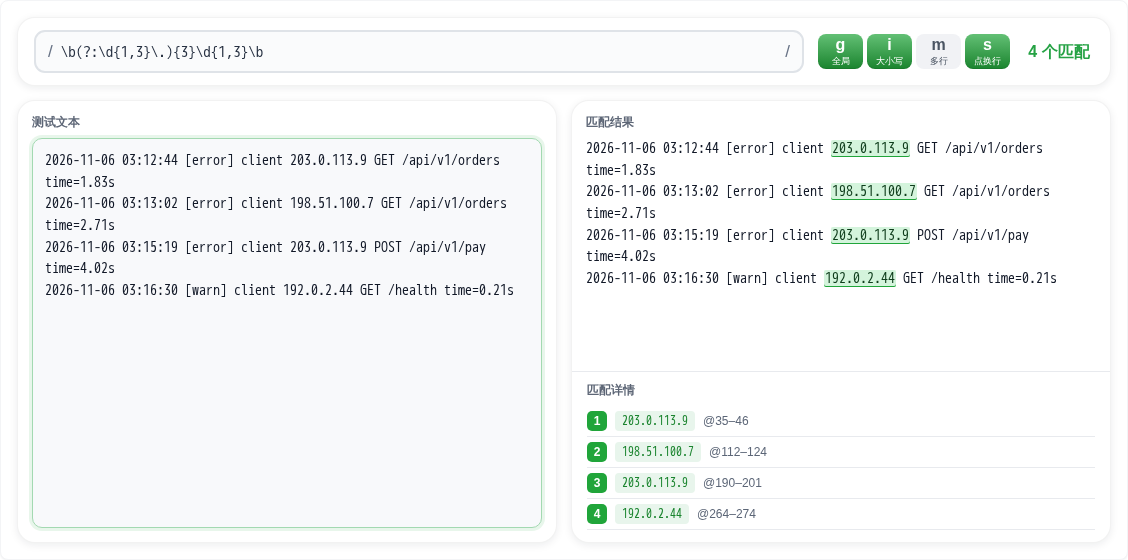
把表达式和待测文本放进宝塔正则测试工具,右边会立刻把命中的部分高亮出来,下方按顺序列出每一处命中的值和位置。计算在浏览器里完成,没有提交按钮,改一个字结果就跟着变。
工具默认已经填好一个匹配 IP 地址的表达式 \b(?:\d{1,3}\.){3}\d{1,3}\b,并默认打开 g、i、s 三个开关(m 是关的)。很多人以为「结果不对」是自己正则写错了,其实先要看这四个开关——它们管的是匹配范围,不是语法。
| 开关 | 按钮上的说明 | 默认 | 管什么 |
|---|---|---|---|
| g | 全局 | 开 | 找全部匹配,还是只找一处 |
| i | 大小写 | 开 | 是否区分大小写 |
| m | 多行 | 关 | ^ $ 认不认每一行的首尾 |
| s | 点执行 | 开 | . 能不能匹配换行 |
注意 s 默认是开的,这正是「. 把整段吞掉」最常见的来源。
只显示 1 个匹配?先看 g 是不是关的
实测同一段 4 行访问日志,表达式 \b(?:\d{1,3}\.){3}\d{1,3}\b:
- g/i/s 全开:显示「4 个匹配」,值为 203.0.113.9、198.51.100.7、203.0.113.9、192.0.2.44,详情里的位置依次是 @35–46、@112–124、@190–201、@264–274;
- 只把 g 关掉、表达式一字不改:变成「1 个匹配」,只剩 @35–46 那一条。
问题不在表达式。非全局模式下,浏览器正则引擎的 exec() 只返回第一处命中,工具也就只渲染一处,统计自然不会超过 1。要数全量,g 必须开着。表达式框里没有 /…/g 这样的字面量可写,g 只能靠按钮切换(框两侧各有一个斜杠,那是界面装饰,不属于输入内容)。
<.*> 一下匹配了一整段?贪婪叠加默认开着的 s
这是两个变量,要分开看:量词的贪婪性,和 s 开关。
先看作对同一段单行 HTML <a href="x">1</a><b>2</b> 的差别:
<.*>:1 个匹配,@0–25,也就是整串;<.*?>:4 个匹配,@0–12、@13–17、@17–20、@21–25,分别是<a href="x">、</a>、<b>、</b>。
.* 会尽量多吃,.*? 吃到满足条件就停,所以按标签逐段切只能用后者。
再看跨行。表达式仍是 <.*>,文本换成两行的 <a>1</a> 和 <b>2</b>:
- 关掉 s:2 个匹配,@0–8、@9–17,正好两个标签;
- 打开 s(默认就是开的):1 个匹配,@0–17,中间那个换行被
.一起吃了。
标准正则里 . 本来不匹配换行,s(dotAll)就是专门放开这一条。工具默认打开它,所以处理多行文本时 .* 会跨行连成一片——这就是「只写了标签匹配,结果跨了好几行」的答案。
^ 和 $ 认不认每行?m 开关决定
实测表达式 ^\S+,文本三行 a1、b22、c333:
- m 关(默认):1 个匹配,a1,@0–2;
- m 开:3 个匹配,a1 @0–2、b22 @3–6、c333 @7–11。
不开 m 时,^ 只锚在整段文本最开头,$ 只锚在最后。要按行取内容(比如逐行解析日志),必须打开 m。
分组捕获的结果在哪看?工具只给整段匹配和位置
实测 (\w+)@(\w+)\.com 对 ops@bt.com sales@example.com:2 个匹配,@0–10 是 ops@bt.com,@11–28 是 sales@example.com。详情区每行只有三样东西——序号、整段匹配值、@起始–结束,没有单独的分组列表。
命名组也一样:(?<y>\d{4})-(\d{2}) 对 2026-11 只显示整段 2026-11 和 @0–7,组里的 2026、11 不会分列出来。
要核对分组内容,可以按详情区给的位置回到原文里自己切,或者把某个分组单独写成一条表达式再跑一次。需要逐组取值的场景,用所在语言的代码或支持分组展示的工具更直接。
详情里出现 ∅ 是什么意思?那是零宽匹配
实测把表达式留空、文本写 abc,显示「4 个匹配」,四行全是 ∅,位置 @0–0、@1–1、@2–2、@3–3。空表达式在每一处字符边界都能命中,但命中的内容长度是 0。
断言类写法同样如此:(?=(\d{3})) 对 abc 123456 得到 4 个 ∅,位置 @4–4 到 @7–7——每个「后面紧跟三位数字」的位置都算一次命中,一个字符也没被消耗。
这类匹配在高亮区看不出颜色,零宽没有字符可涂,只能靠下方位置行确认。工具遇到长度为 0 的匹配会把查找位置往前推一格再继续,所以不会卡在同一个位置反复命中。
报错原文怎么读:正则无效 + 引擎给的那句话
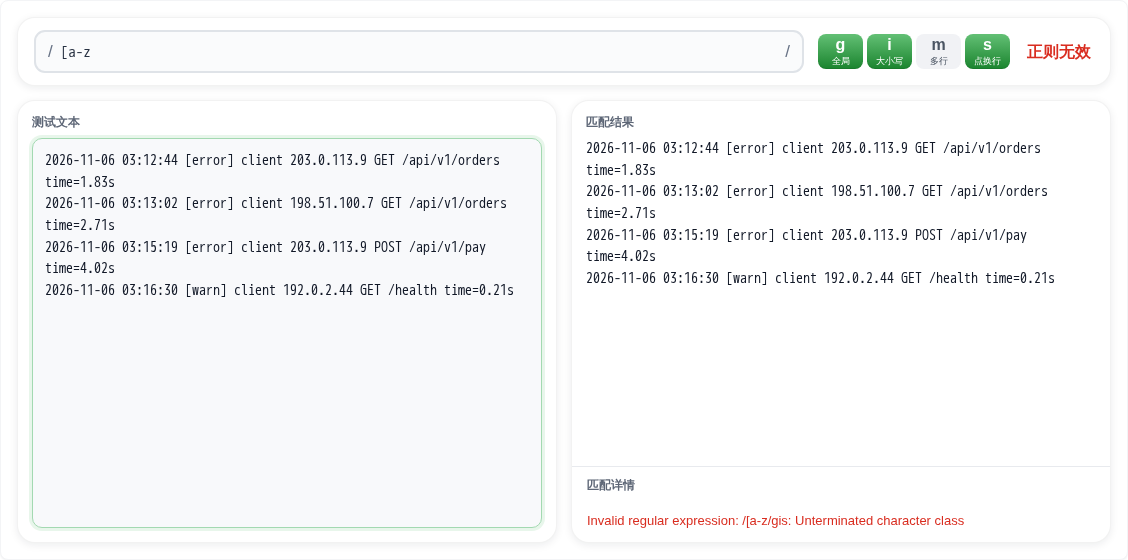
实测表达式 [a-z(少一个右方括号),右上角计数位置变成红色的「正则无效」,详情区给出引擎原文:
Invalid regular expression: /[a-z/gis: Unterminated character class三件事要看清:
- 冒号后面那句
Unterminated character class才是真正的原因,意思是字符组没闭合; /gis是工具把当前打开的开关拼进去的,不属于你的表达式,开关一变这串也跟着变;- 报错不给列号。表达式长的时候用删半段的办法:去掉后半段还能跑,说明错在后半段,逐次折半,比盯着找快。
两类从其他语言教程抄来的写法会直接报错,实测:
(?>a)→Invalid group,JavaScript 没有原子组;a++→Nothing to repeat,也没有占有量词。
匹配中文为什么对不上?这个工具没有 u 开关
四个开关只有 g、i、m、s,没有 u(Unicode 模式),几种常见的中文写法表现就不一样,实测:
| 表达式 | 文本 | 结果 |
|---|---|---|
\p{Script=Han}+ |
宝塔面板 BT Panel | 0 个匹配 |
[\u4e00-\u9fa5]+ |
宝塔面板 BT Panel | 1 个,宝塔面板,@0–4 |
\b宝塔\b |
用宝塔面板建站 | 0 个匹配 |
\p{…}属性转义要 u 开关才生效,没开会当成普通字符去找,结果自然是 0;\b判断的是「词字符」边界,而词字符只算 A–Z、0–9 和下划线,汉字不算,所以\b宝塔\b前后都立不起边界;- 匹配常用汉字,用码点范围
[\u4e00-\u9fa5]更稳妥。
也有反过来的例子:后行断言是可用的,(?<=\$)\d+ 对 price $49 and $128 得到 2 个匹配,49 @7–9、128 @15–18。所以「新语法一定不支持」不成立,具体要看是哪一条。
位置 @35–46 怎么读
起始位置包含、结束位置不包含,是半开区间,下标从 0 开始数。@35–46 覆盖下标 35 到 45,共 11 个字符(46−35=11),正好是 203.0.113.9 这 11 个字符;换成日常从 1 数,就是第 36 到第 46 个字符。要按结果改原文,用这对下标做切片,不会多删或少删一个字符。
它不做什么
- 不校验后端方言:工具跑的是浏览器的 JavaScript 引擎,同一表达式换到 PHP 的 preg_* 或其他语言里行为可能不同,上线前要在实际语言里再跑一遍。
- 不做替换:页面只有表达式、开关、测试文本、匹配结果四块,没有替换框。
- 不解释语法:它告诉你哪几处命中、报什么错,不解释为什么,语法细节仍要查规范。
用起来的顺序
先用默认表达式和默认开关跑一遍,确认工具本身正常;再按需要的语义把开关调好(多数情况 g 要开,跨不跨行决定 s);最后才调表达式本身。顺序反过来,很容易把开关造成的结果当成表达式写错,来回折腾半天。
常见问题
为什么我明明有好几处匹配,工具只显示 1 个?
因为 g(全局)开关没开。实测同一段 4 行日志、同一个匹配 IP 的表达式,g/i/s 全开时显示 4 个匹配,只把 g 关掉就变成 1 个,表达式一个字都没改。非全局模式下浏览器正则引擎只返回第一处命中,工具也就只渲染一处。表达式框里没有 /…/g 这种字面量可写,g 只能靠按钮切换。
显示「正则无效」是哪里写错了?
是表达式语法不合法,不是文本的问题。此时计数位置变成红色「正则无效」,详情区给出引擎原文,例如少一个右方括号的 [a-z 会报 Invalid regular expression: /[a-z/gis: Unterminated character class。冒号后面那句 Unterminated character class 才是原因,末尾的 /gis 是工具把当前开关拼上去的,不属于表达式。报错不给列号,表达式长时可以用删半段再跑的办法缩小范围。
分组捕获到的内容在哪儿看?
这个工具不单列分组,只给整段匹配和位置。实测 (\w+)@(\w+)\.com 对 ops@bt.com sales@example.com 显示 2 个匹配,每行只有序号、完整匹配值、@起始–结束;命名组 (?<y>\d{4})-(\d{2}) 对 2026-11 也只显示整段 2026-11 和 @0–7,组里的 2026、11 不会分列。要核对分组内容,可以按位置回原文切片,或把分组单独写成一条表达式再跑。
结果里出现 ∅ 是什么意思?
是零宽匹配,命中内容长度为 0。实测表达式留空、文本写 abc,显示 4 个匹配,全是 ∅,位置从 @0–0 到 @3–3;断言 (?=(\d{3})) 对 abc 123456 也是 4 个 ∅,位置 @4–4 到 @7–7。零宽没有字符可高亮,只能靠下方位置行确认。
匹配中文该用哪种写法?
用码点范围 [\u4e00-\u9fa5]+,实测对「宝塔面板 BT Panel」命中「宝塔面板」,位置 @0–4。反例有两个:\p{Script=Han}+ 得到 0 个匹配,因为该工具只有 g、i、m、s 四个开关,没有 u(Unicode 模式),属性转义不生效;\b宝塔\b 也是 0 个匹配,因为 \b 只认 ASCII 词字符,汉字前后立不起边界。
把 /error/g 整串粘进表达式框,为什么一个都匹配不到?
表达式框只填本体,开关用按钮点。实测把 /error/g 原样粘进去、文本写 error ERROR,结果是 0 个匹配——开头的斜杠、结尾的 /g 都被当成要查找的普通字符了。正确做法是框里只写 error,全局匹配点开 g。