Markdown 转 HTML 后表格没边框、换行不对?片段、CSS 与转义三件事讲清
把 Markdown 粘进 宝塔 Markdown 转 HTML 工具,右侧会实时出现 HTML 源码,还带一个「复制 HTML」按钮。但复制出去之后,很多人会发现表格没有边框、标题不够大、段落之间多出空行——转换本身没出错,问题在于这个工具输出的是一段 HTML 片段,不是完整网页,也不带任何样式。它长什么样,取决于你把这段片段贴到哪里。
输出的是片段:没有 DOCTYPE,也没有 head 和样式
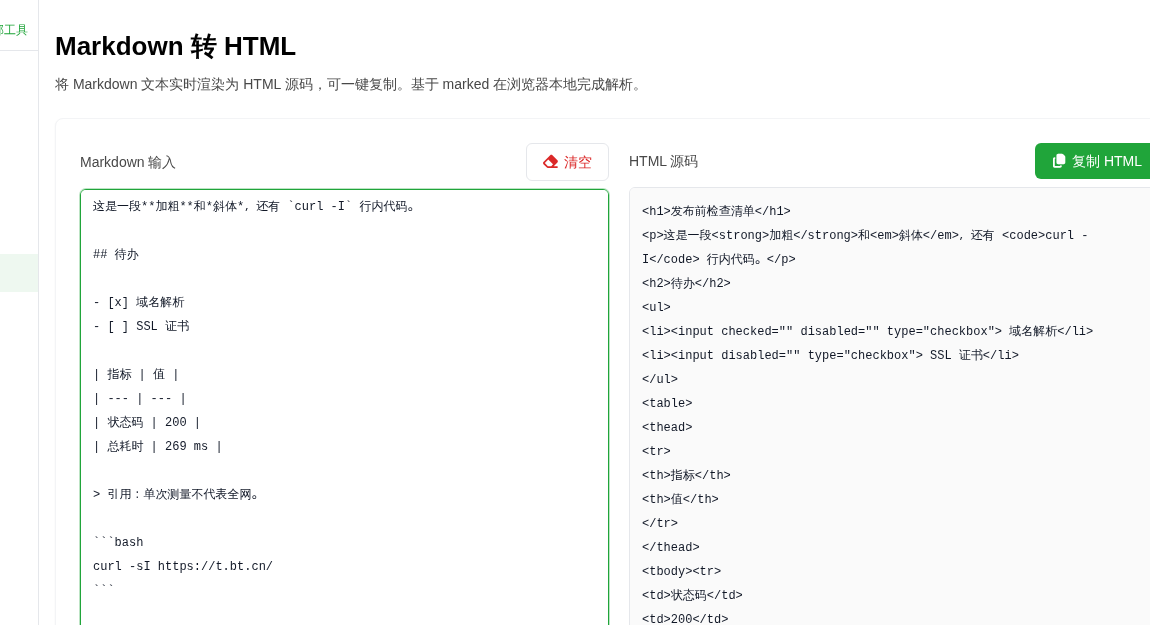
下面截取本次运行输入的开头两段做示范,输出照抄对应结果。同一次运行的完整输入还包含「## 待办」任务列表、GFM 表格、引用块和 bash 代码块,它们对应的产出在后面小节逐条列出。
输入:
# 发布前检查清单

这是一段**加粗**和*斜体*,还有 `curl -I` 行内代码。
输出(原样照抄):
<h1>发布前检查清单</h1>
<p>这是一段<strong>加粗</strong>和<em>斜体</em>,还有 <code>curl -I</code> 行内代码。</p>
清点一下输出的边界:
| 输出里有 | 输出里没有 |
|---|---|
| h1、h2、p、ul、table 等结构标签 | <!DOCTYPE html> |
| strong、em、code 等行内标签 | <html>、<head>、<body> |
| 你写的原始 HTML 标签 | <meta charset> |
| 换行与空白的结构 | 任何 <style> 或 CSS |
所以它给的是「网页正文那一段」。想单独存成 .html 打开,外框要自己补:
<!DOCTYPE html>
<html lang="zh-CN">
<head>
<meta charset="utf-8">
<title>标题</title>
</head>
<body>
<!-- 工具输出的片段贴在这里 -->
</body>
</html>
不补 <meta charset="utf-8"> 的话,文件里的中文编码就只能靠浏览器自己猜,这就是「单独打开是乱码」的常见来源。
表格没边框、标题不够大:片段里没有 CSS
HTML 只描述结构,长什么样由 CSS 决定。工具不输出样式,于是:
- 表格转出来是标准的
<table><thead><tbody>,但浏览器对表格的默认样式就是无边框,所以看起来像几行挤在一起的文字; - 标题的字号来自浏览器默认样式,一旦贴进你自己的站点,就会被站点的 CSS 接管,大小可能和你在工具页看到的完全不同;
- 想要边框和间距,规则要加在承载这段 HTML 的页面上,例如
table { border-collapse: collapse; }再配合td、th的border。
结论:贴进后台编辑器、模板、邮件模板之后,样式来自那个页面,而不是 Markdown 原文。
单个换行会变成 <br>,和 CommonMark 默认规则不同
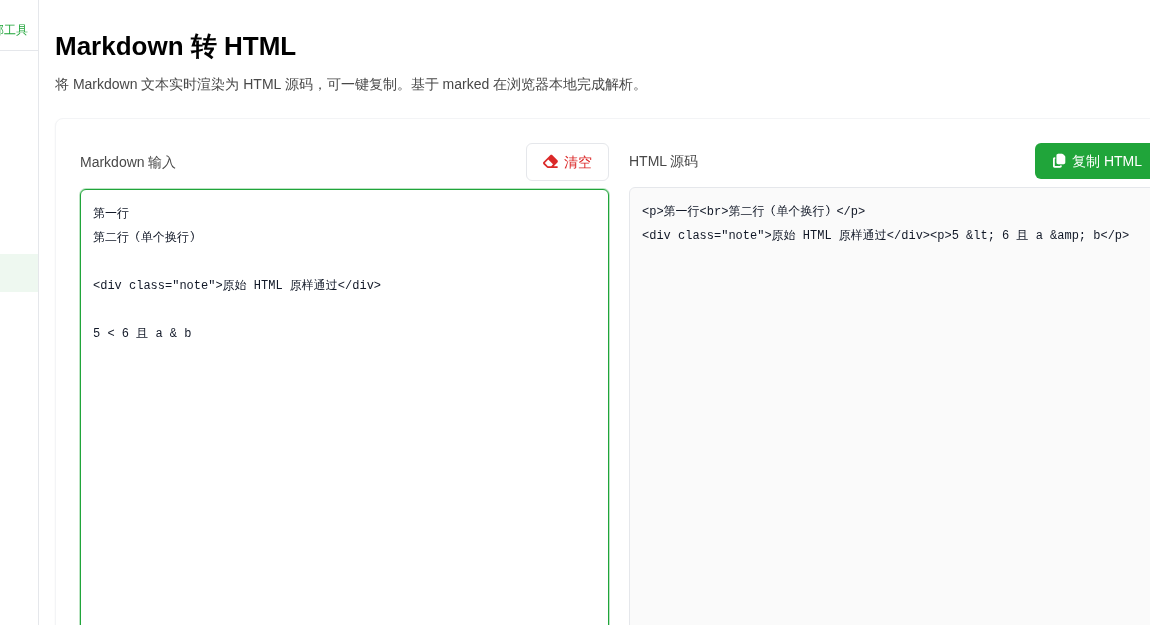
实测输入两行文字,中间只有一个换行、没有空行:
第一行
第二行(单个换行)
输出是:
<p>第一行<br>第二行(单个换行)</p>也就是说,工具把段落内的单个换行直接转成了硬换行 <br>(页面说明里写明基于 marked,这是它开启 breaks 后的行为)。标准 CommonMark 的规定相反:段落内的单个换行是「软换行」,渲染成空格,要硬换行得在行尾写两个空格或一个反斜杠。
这个差别在两种场景会咬人:
- 从 Word、PDF、聊天记录里粘过来的文本,往往每行都被硬折过,转完就是一串
<br>,粘到页面上是断开的几行; - 反过来,把这些
<br>再粘回严格的 Markdown 环境,它们不会自动消失。
要分段就空一行(输出两个 <p>),确实需要强制换行时才只敲一个换行。
文本里的 <、& 会转义,但原始 HTML 标签原样通过
同一次运行里再输入一行 5 < 6 且 a & b,输出是 5 < 6 且 a & b——正文里的特殊字符会被转义成实体,不会破坏文档结构。
但换一个输入就不一样了:写成 <div class="note">原始 HTML 原样通过</div>,输出里就是这段 <div>,标签既没被转义也没被删掉;同一次运行里输入的 <script>alert(1)</script>,也一字不差地出现在输出框中。
这说明一件事:这个工具负责「转」,不负责「清」。Markdown 语法本身允许内嵌原始 HTML,转换器按规范照搬是正确行为;风险出在下一步——如果后端把这段输出直接拼进页面,或者用 innerHTML 插入,脚本会真的执行。
处理办法按数据来源分三种:
- 内容是你自己写的文档:可以不做过滤,直接用;
- 内容来自别人,但只需要排版效果:渲染前按允许列表过滤标签(只留 p、strong、em、a、ul、table 这类),把 script、iframe、事件属性一律去掉;
- 展示用户提交的 Markdown:不要直接把输出塞进 innerHTML,先过滤再插入,也不要指望转换器替你挡。
表格、任务列表、删除线、裸链接这些 GFM 写法都能转
同一段输入里把这些写法各写一遍,输出如下:
- 表格
| 指标 | 值 |→<table><thead><tbody>结构,表头进<th>,数据进<td>; - 任务列表
- [x] 域名解析→<li><input checked="" disabled="" type="checkbox"> 域名解析</li>,勾选状态是属性值,输出的是静态 HTML,页面上点它不会变; - 删除线
~~删除线~~→<del>删除线</del>; - 裸链接
https://t.bt.cn/ping/→ 自动包成<a href="...">,不需要手写链接语法; - 图片
→<img src="/blog/images/demo.png" alt="拨测结果" title="标题">,路径原样照搬,工具不检查图片是否存在,也不改写相对路径。
代码块另说:```bash 只会输出 <pre><code class="language-bash">,只给类名、不做语法着色,颜色要靠承载页面的高亮脚本或 CSS 提供。
两个「看起来没生效」的写法
#后面不加空格:实测#没空格的标题输出<p>#没空格的标题</p>。ATX 标题要求#与文字之间有空格,没空格就是普通段落。- 空行当分段:两个段之间不空行,只会被当成同一段的软换行(本工具则被转成
<br>),不会生成两个<p>。
收尾:先想清楚这段 HTML 贴到哪
一个 Markdown 转 HTML 工具真正要回答的不是「能不能转」,而是「转出来的这段能贴到哪」。判断顺序很简单:贴进已有页面就只管结构,边框字号交给页面 CSS;要单独成页就先补 DOCTYPE、charset 和外框样式;内容来源不可信就先过滤标签再用。
想对照自己手里的 Markdown,可以直接在 Markdown 转 HTML 工具 里粘一遍,输出框的内容就是最终会复制的全部内容;如果这段 HTML 是要放到网站上,顺带用 网站测速 看一下页面体积变大后的加载耗时,也能验证排版改动有没有拖慢打开速度。
常见问题
转换出来的 HTML 能直接存成 .html 打开吗?
能打开,但不是一个完整网页。实测输出以 <h1> 开头,没有 DOCTYPE、没有 html/head/body、没有 meta charset、没有任何 CSS,浏览器只会用默认样式渲染它,中文编码也只能靠浏览器猜。要正式当页面用,自己在外面补 DOCTYPE、html、head、meta charset 和样式,再把片段放进 body。
表格转出来没有边框,是转换失败了吗?
不是。转换只负责结构,输出里是标准的 <table><thead><tbody> 标签,不带任何样式;浏览器对表格的默认样式本来就是无边框。想要边框,得在承载这段 HTML 的页面上加 CSS,例如 table { border-collapse: collapse; } 配合 td、th 的 border 规则。
为什么我只敲了一个换行,输出里却有 <br>?
工具开启了硬换行。实测输入两行文字(中间只有一个换行、没有空行),输出是 <p>第一行<br>第二行</p>。标准 CommonMark 里段落内的单个换行是软换行,渲染成空格而不是 <br>;两种规则不同,所以从 Word、PDF 粘来的硬折行会变成一串 <br>。要分段就空一行。
Markdown 里写的 HTML 标签会被丢掉或转义吗?
不会被丢掉,也不会被转义,是原样输出的。实测把一段带 class 属性的 div 标签写进 Markdown,输出里一字不差;同一次运行里输入的 script 标签(内容是一句 alert(1))也原样出现在输出中。所以这个工具是转换器,不是过滤器:渲染别人提供的 Markdown 时,先把标签按允许列表过滤,再插入页面,不要直接 innerHTML。
代码块为什么不带颜色?
因为输出只给类名,不给高亮。实测 ```bash 代码块输出 <pre><code class="language-bash">,颜色要由渲染页面的高亮脚本或 CSS 决定,工具本身不做语法着色。
为什么 # 后面不加空格就不是标题?
Markdown 的 ATX 标题要求 # 与文字之间有一个空格。实测输入 #没空格的标题,输出是 <p>#没空格的标题</p>,整行被当成普通段落。写成 # 标题 才会输出 <h1>。