中文转 Unicode 得到 中 不是 \u4e2d:三种写法的区别与页面显示成串码的原因
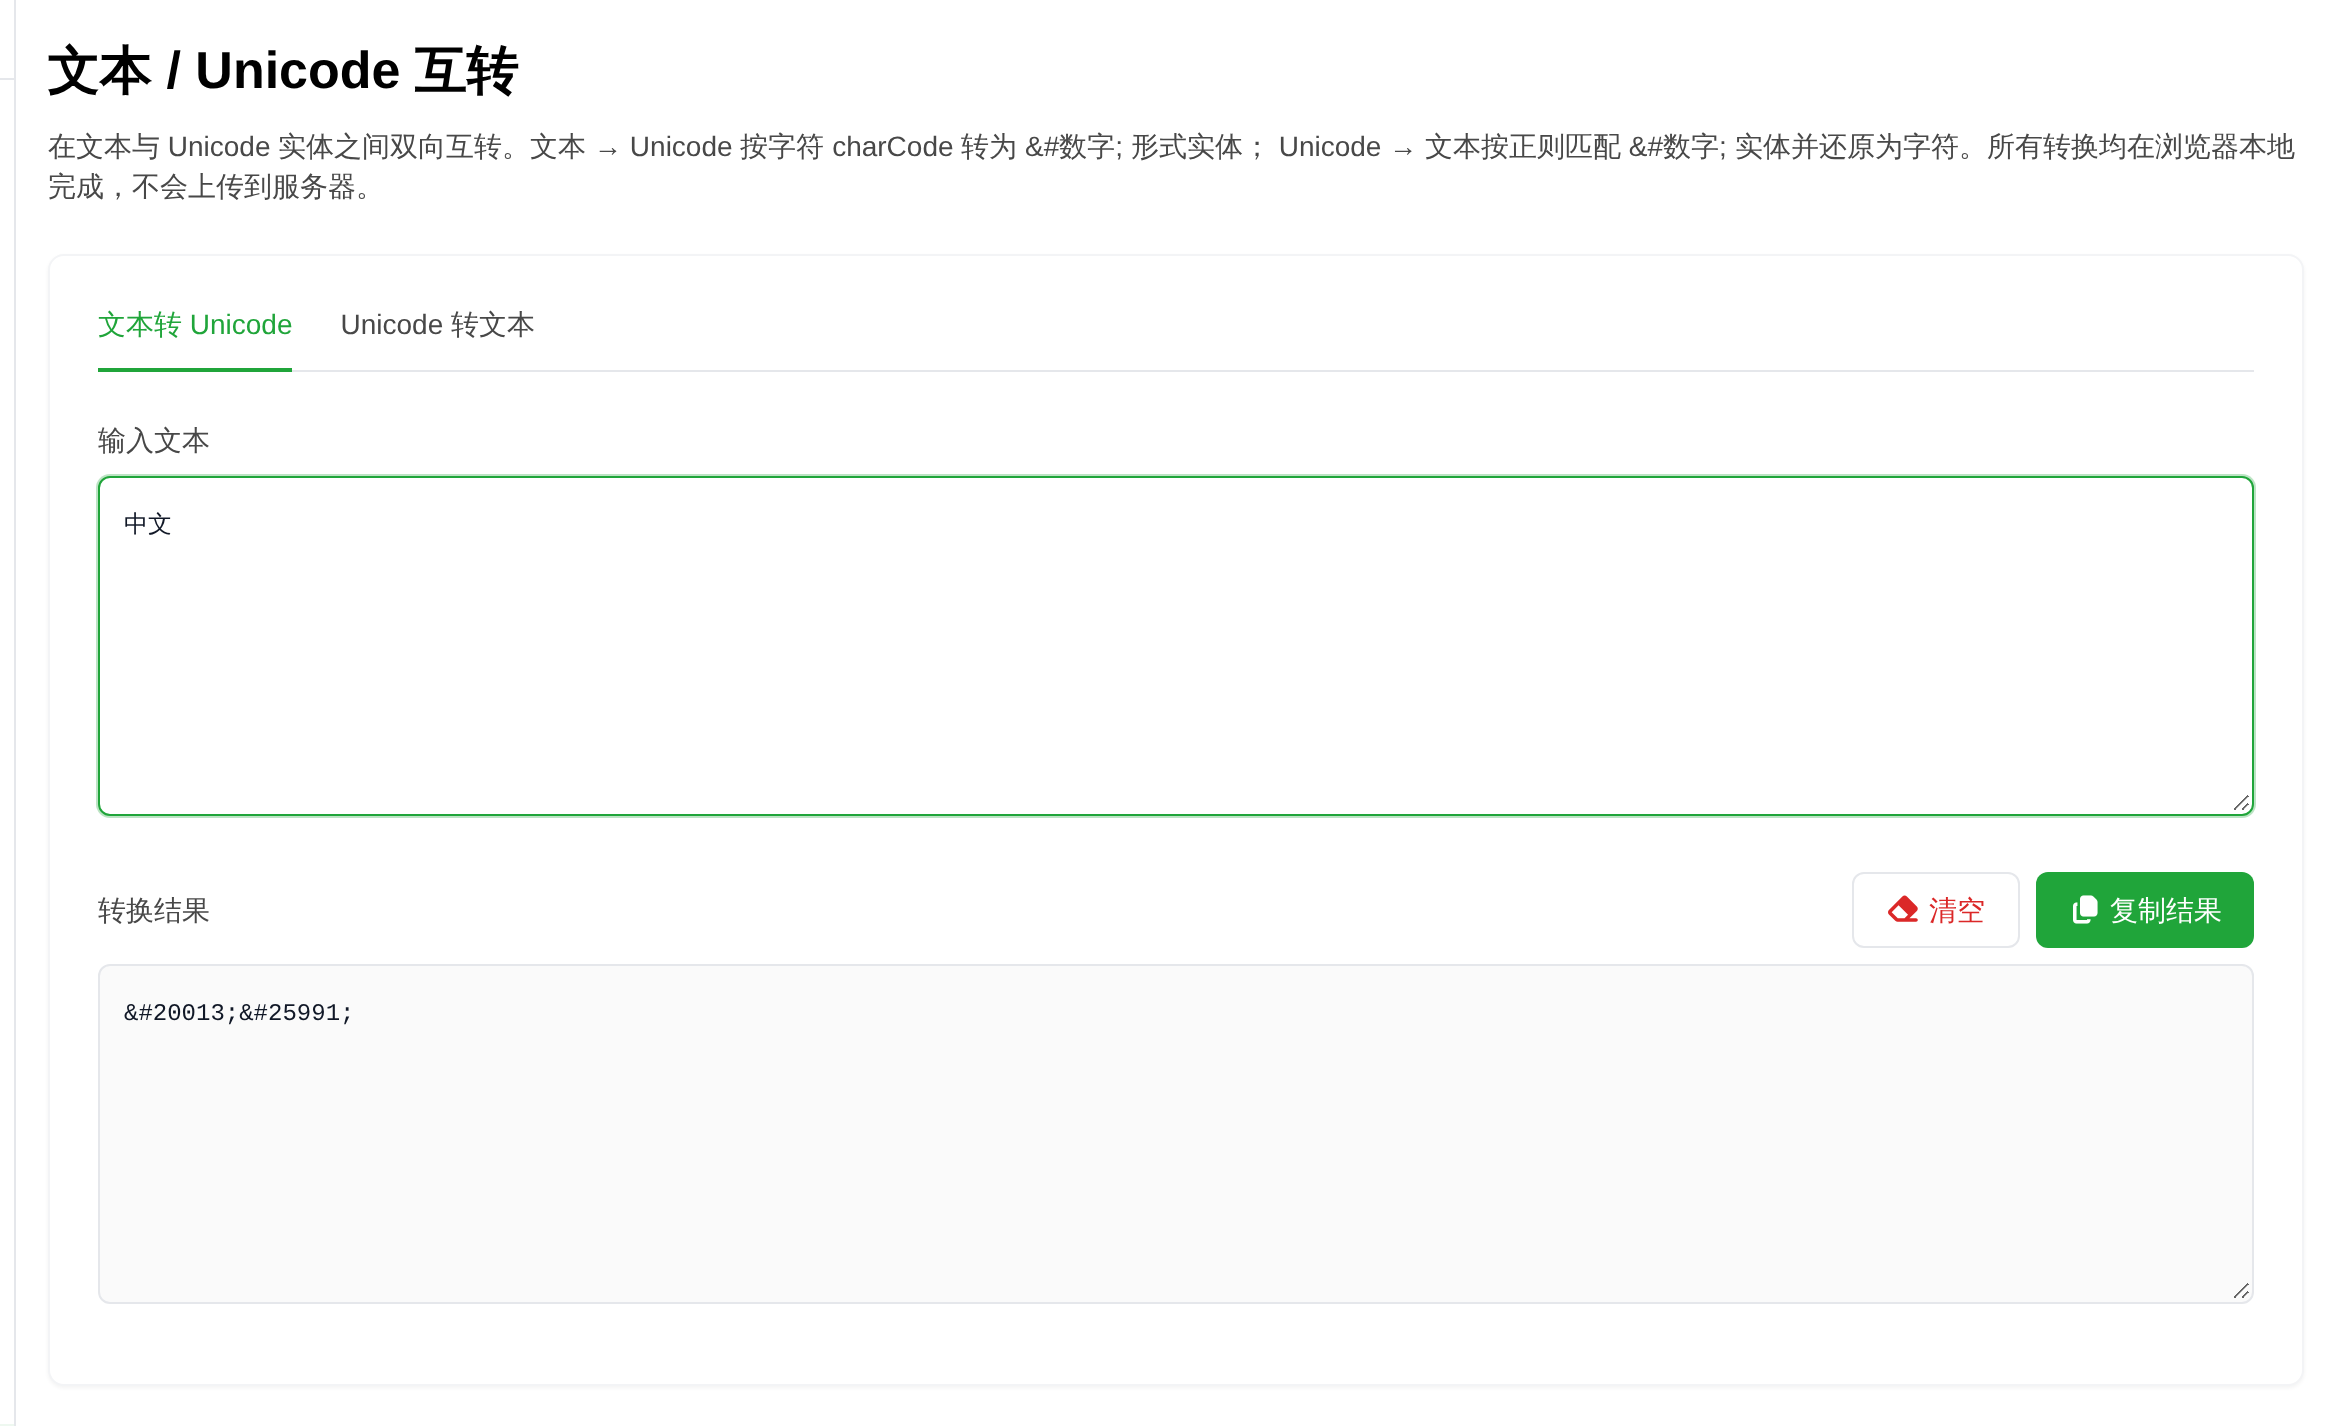
宝塔的文本 / Unicode 互转工具页面上写着「文本 → Unicode 按字符 charCode 转为 &#数字; 形式实体」。也就是说,它出的是 HTML 的十进制字符引用,不是很多人以为的 \u4e2d 那种十六进制转义。实测输入「中文」,结果框是 中文。
这两种写法表示的是同一个字符,但用在不同的地方,混着用就会卡住:把 \u4e2d\u6587 粘进它的反解框,直接报「未识别到合法的 Unicode 实体(形如 A)」。
下面每个输入输出都来自 2026-11-09 11:36 前后的同一次运行,截图与正文数字同源,转换在浏览器本地完成、不上传服务器。
同一个字,几种写法
「中」这个字符有多个身份,先分清再用工具,后面大部分坑都从这里来:
| 形式 | 写法 | 用在哪 | 本质 |
|---|---|---|---|
| 字符本体 | 中 | HTML 正文、源码、数据库 | 一个 Unicode 字符 |
| 十进制实体 | 中 |
HTML / XML 正文 | 码点 20013 的十进制 |
| 十六进制实体 | 中 |
HTML / XML 正文 | 码点 0x4E2D |
| 十六进制转义 | \u4e2d | JavaScript 字符串、JSON、CSS 的 \4e2d | 码点 0x4E2D |
| 百分号编码 | %E4%B8%AD | URL、表单 | UTF-8 三个字节,不是码点 |
关键区别在于「码点」和「字节」:除最后一行外,前几行说的都是码点 U+4E2D 的不同记法,只是进制和包装语法不同;最后一行 %E4%B8%AD 是 UTF-8 编码后的字节序列,跟码点不是一回事(「中」在 UTF-8 下占 3 个字节,所以是 9 个字符)。
U+4E2D 的十进制是 20013,所以 中 和 中 指的是同一个字符。浏览器两种都认,但这个工具只认十进制那一半。
实测:中文转出来是 中文
在「文本转 Unicode」标签页输入「中文」,结果框立刻出现:
中文
两个字符换两个实体,每个实体一个分号结尾,中间没有空格。再看一个混排的例子,输入 BT 中文 ✅,输出是:
BT 中文 ✅
可以对照出来:B 是 B、T 是 T、空格是  、✅(U+2705)是 ✅。这个工具不分字符类型,ASCII 字母、空格、中文、emoji 全部换成实体,这一点和 HTML 实体工具只编 5 个字符的设计正好相反。
顺带说清一处:输出里的 & 没有被二次转义,结果就是 中 这几个字符,不是 中。工具只做一件事——把每个码元换成「& + # + 十进制数字 + 分号」。
反解只认 &#数字;:\u4e2d 和 中 都会报错
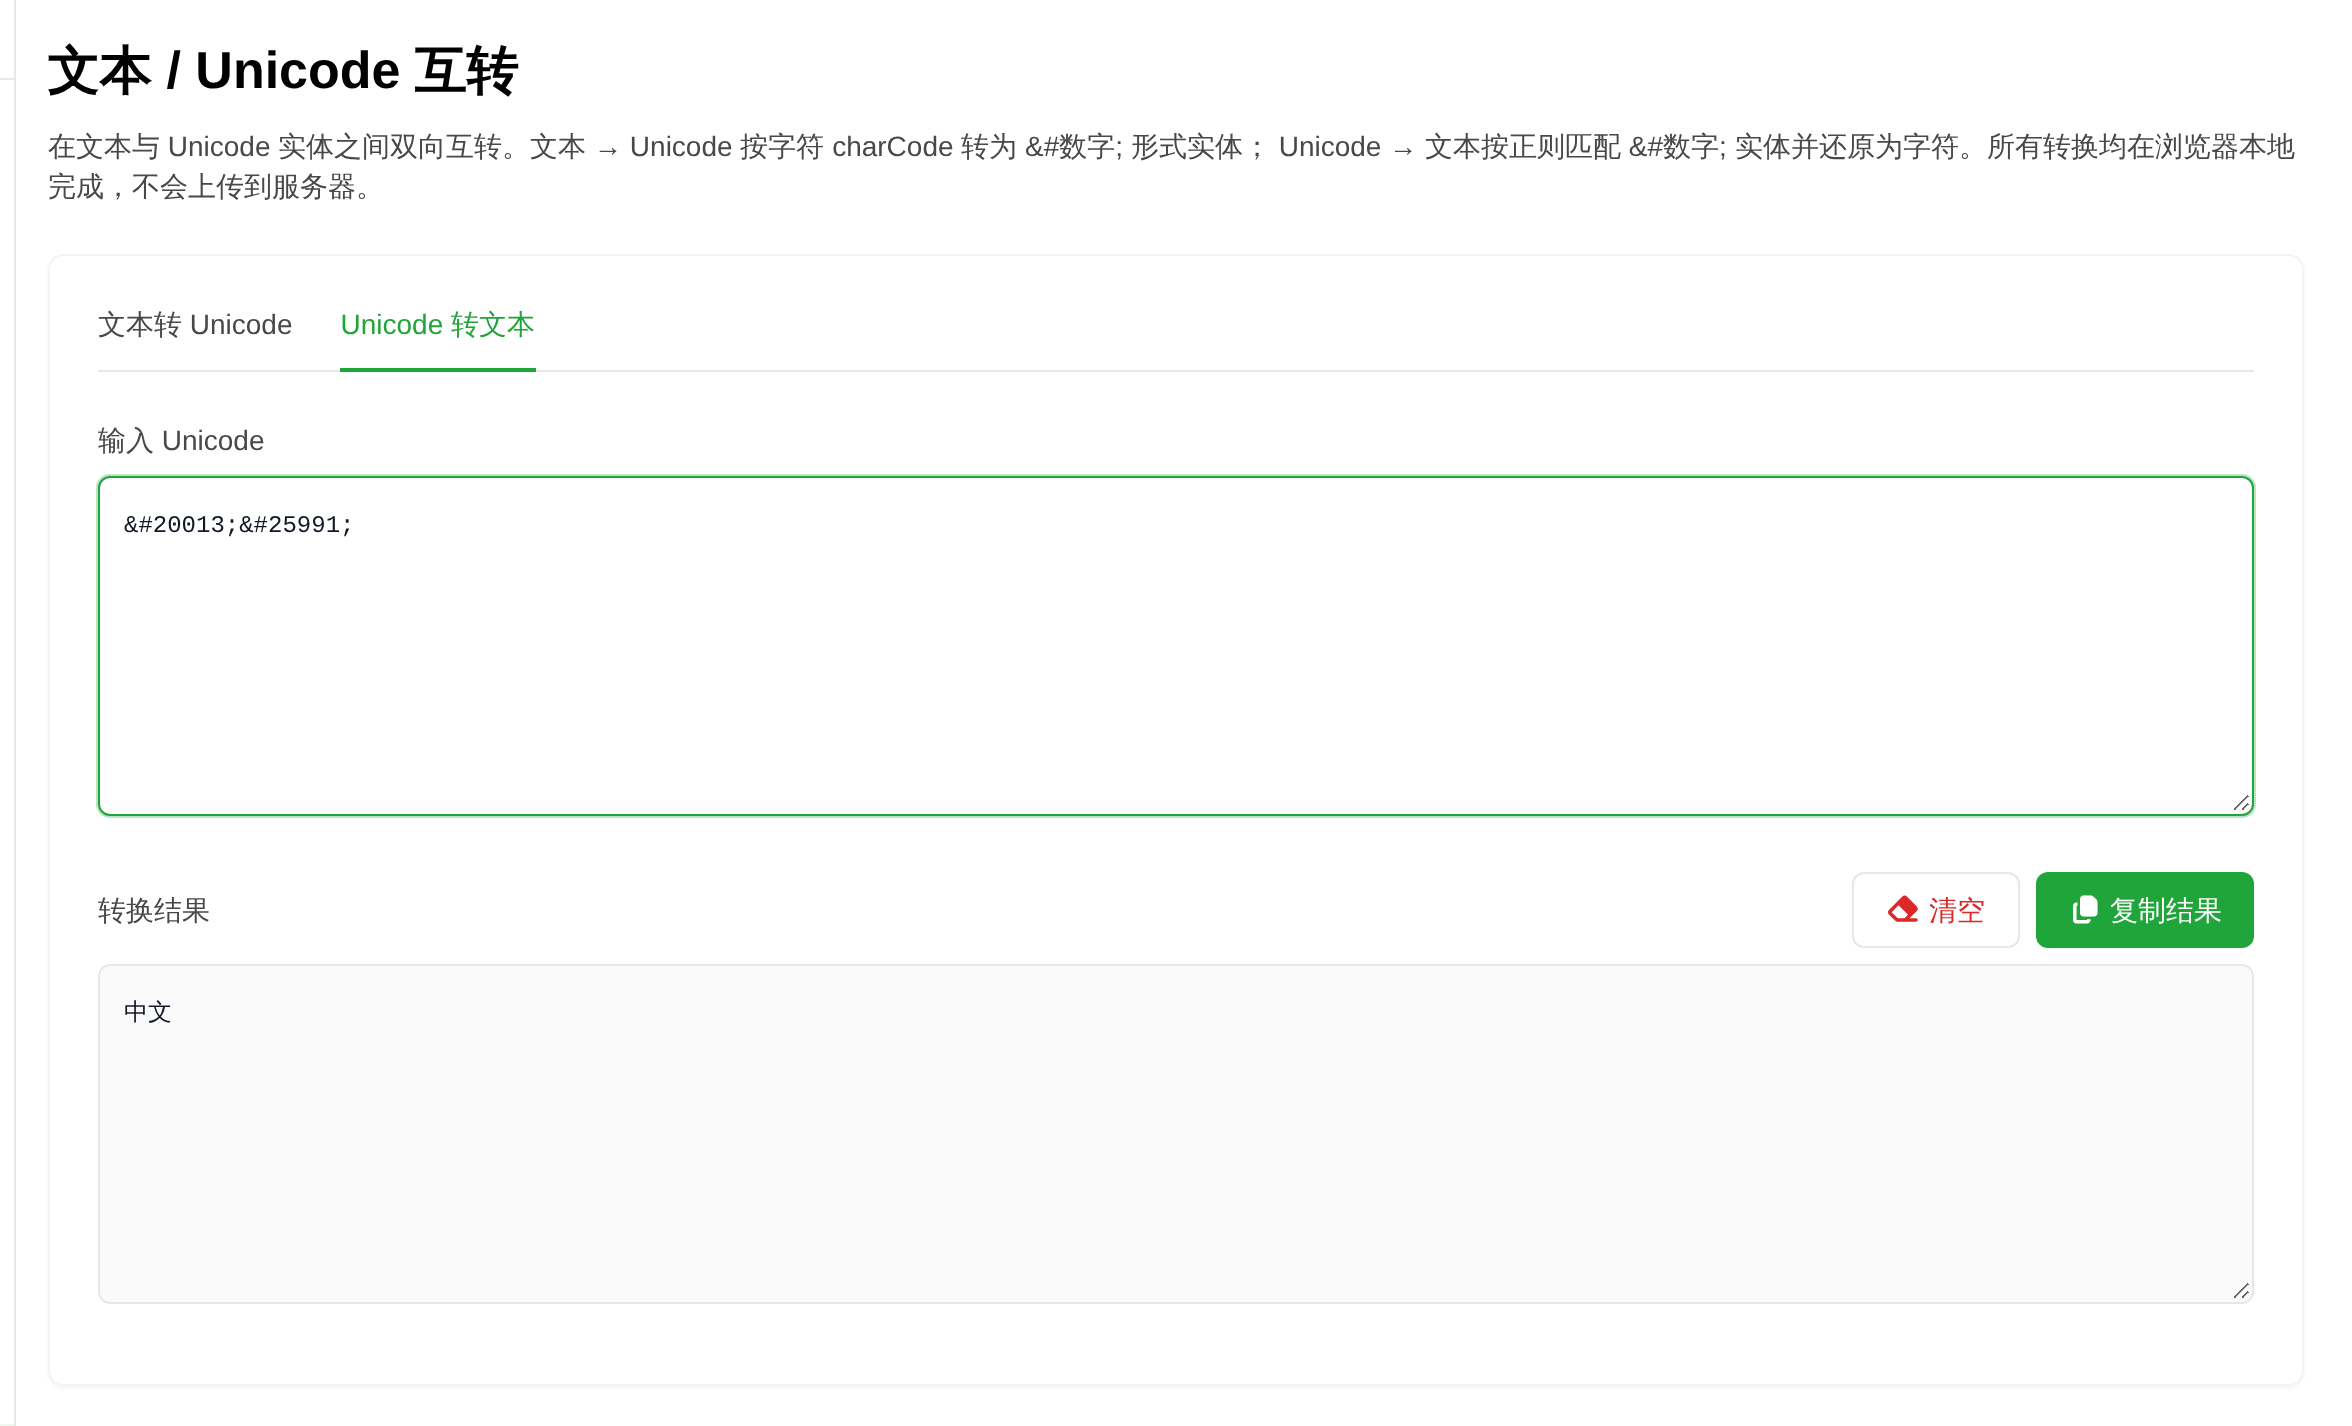
切到「Unicode 转文本」,输入 中文,输出是「中文」,一切正常。
换成 JavaScript 和 JSON 里常见的形式 \u4e2d\u6587,输出框是空的,下面出现红字:
未识别到合法的 Unicode 实体(形如
A)
换成十六进制实体 中文,报的还是同一句。
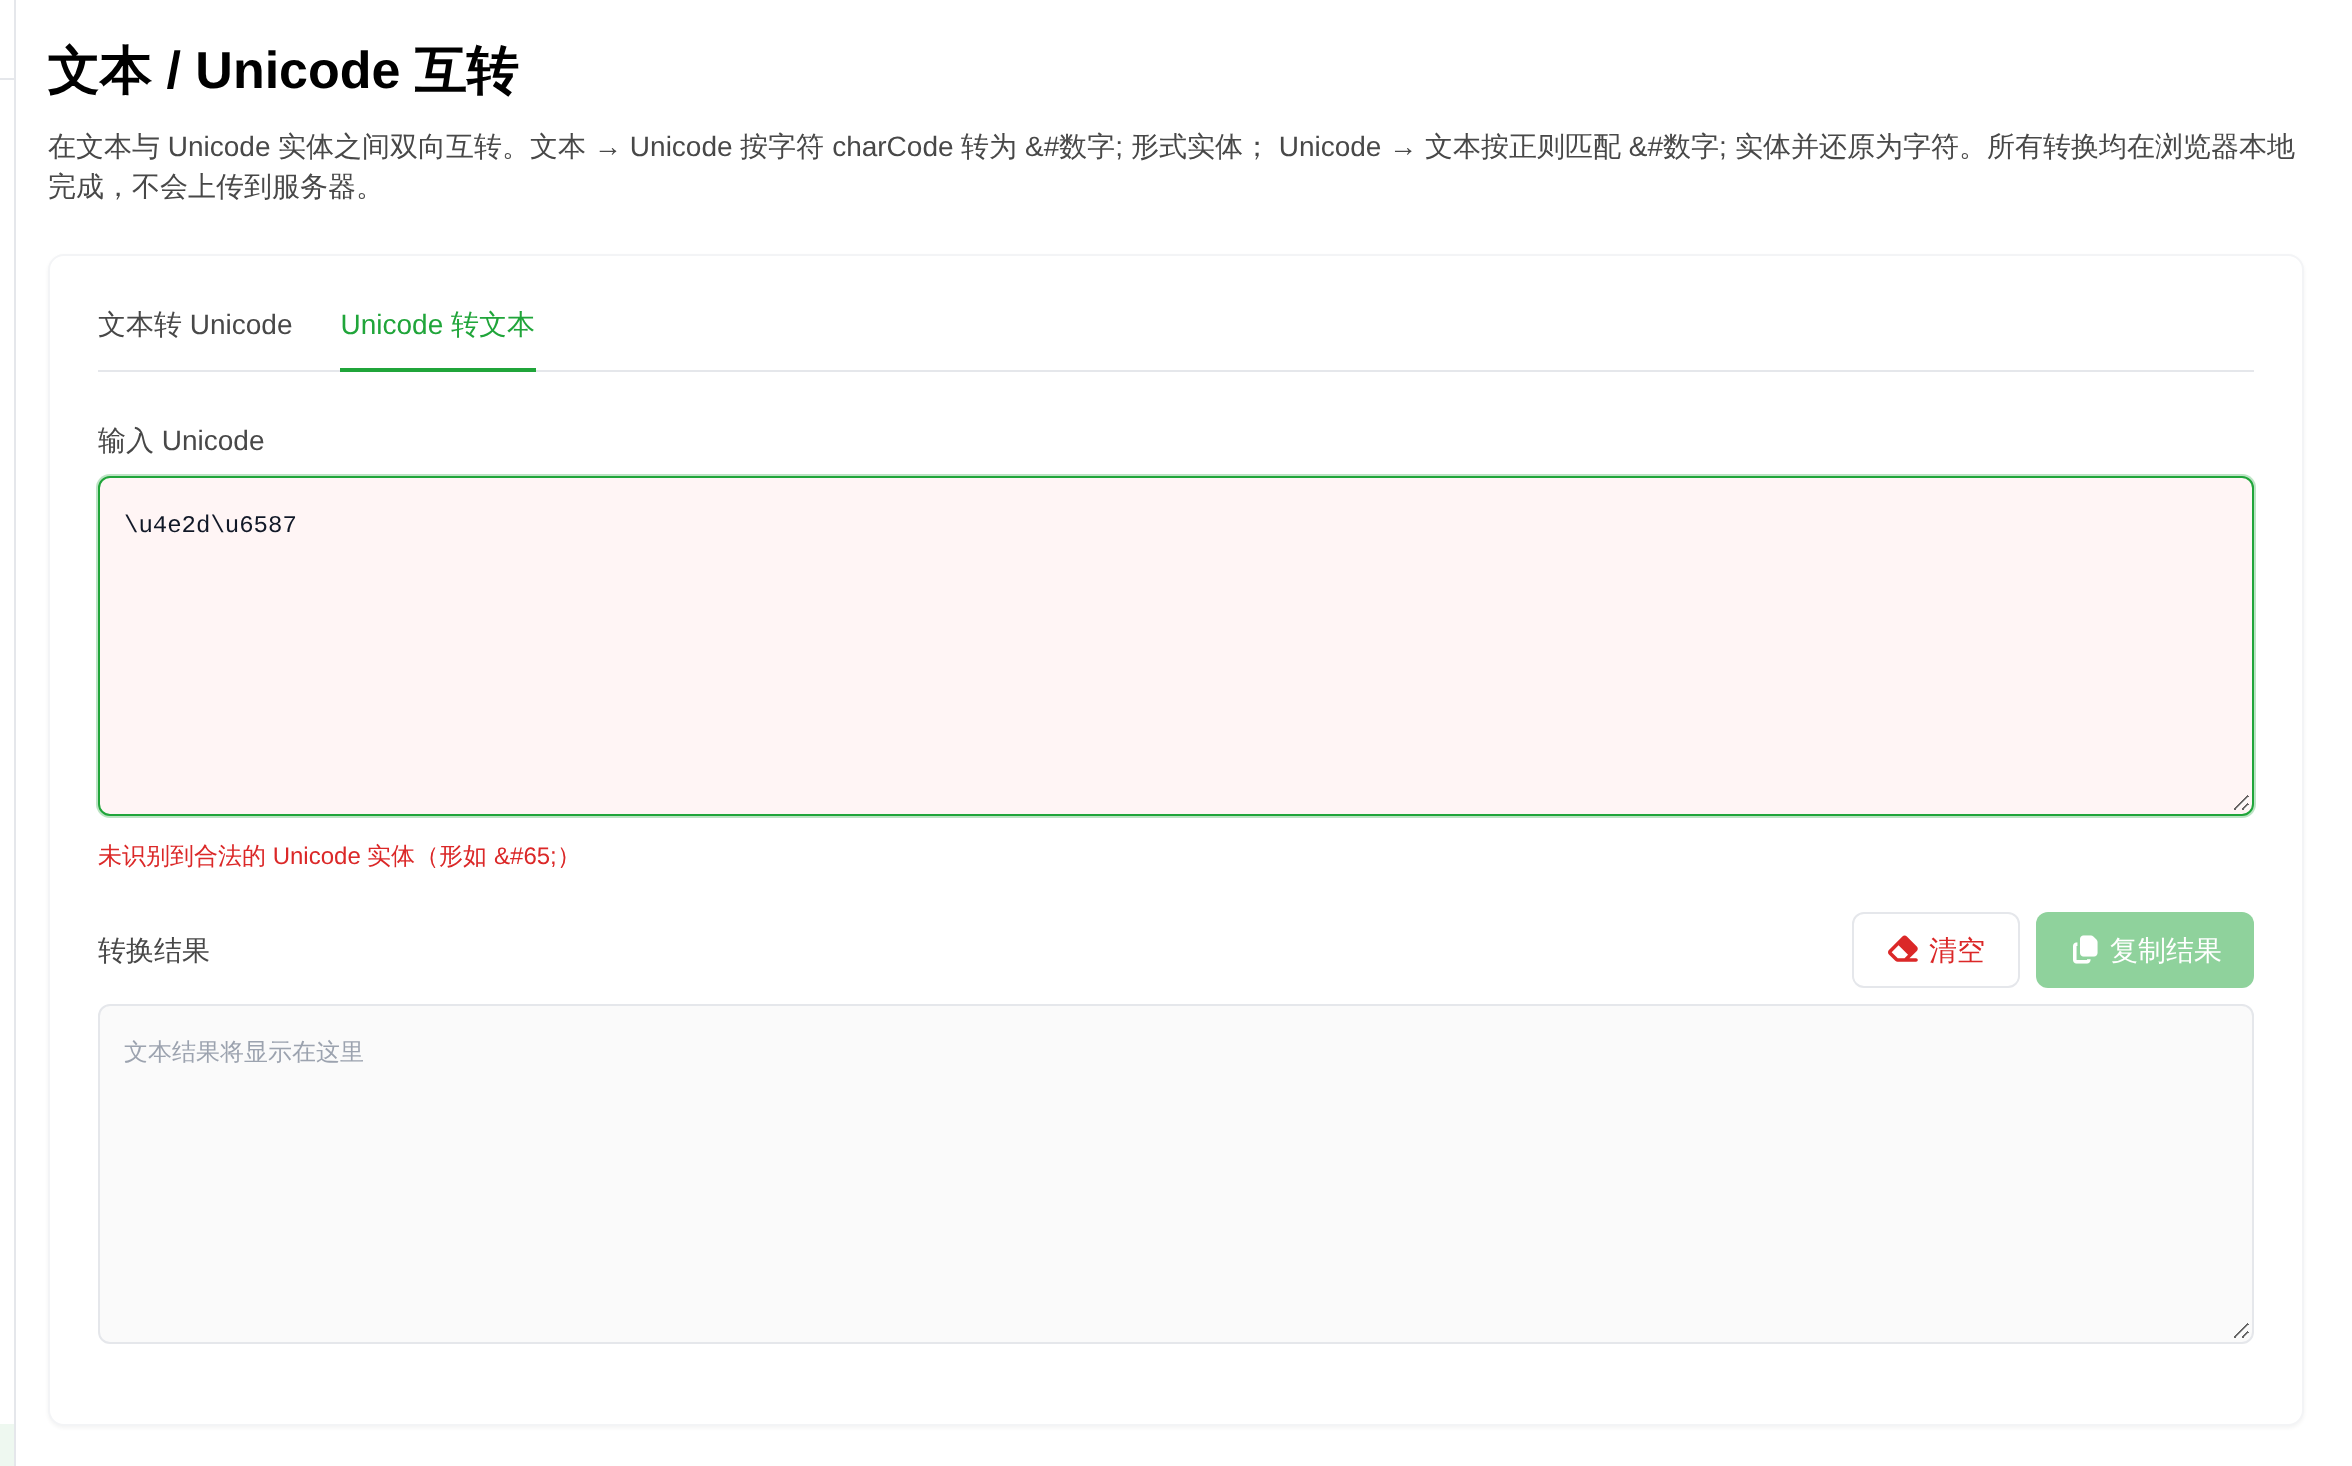
这解释了一个很常见的困惑:从 JSON 接口里拿到 \u4e2d 形式的中文,或者从别人给的 HTML 源码里拿到 中,粘到这个工具都还原不了。不是格式坏了,是它的匹配规则只写了十进制那一种——页面说明也写明「Unicode → 文本按正则匹配 &#数字; 实体并还原为字符」。
要读接口返回的 \uXXXX,用 JSON 在线解析与格式化工具 里的「Unicode 转中文」;要处理命名实体和十六进制实体,用 HTML 实体编码工具。三个工具的适用边界不一样,粘错地方就会得出「工具坏了」的结论。
分号也不能省。实测输入 中(少了结尾分号),同样报「未识别到合法的 Unicode 实体(形如 A)」,输出为空。
文本中间的实体可以混着解。输入 A 中 B,输出是 A 中 B:实体段被替换,前后的普通字符原样保留,空格也照旧。
emoji 转出来是两个代理码元,贴进网页会变乱码
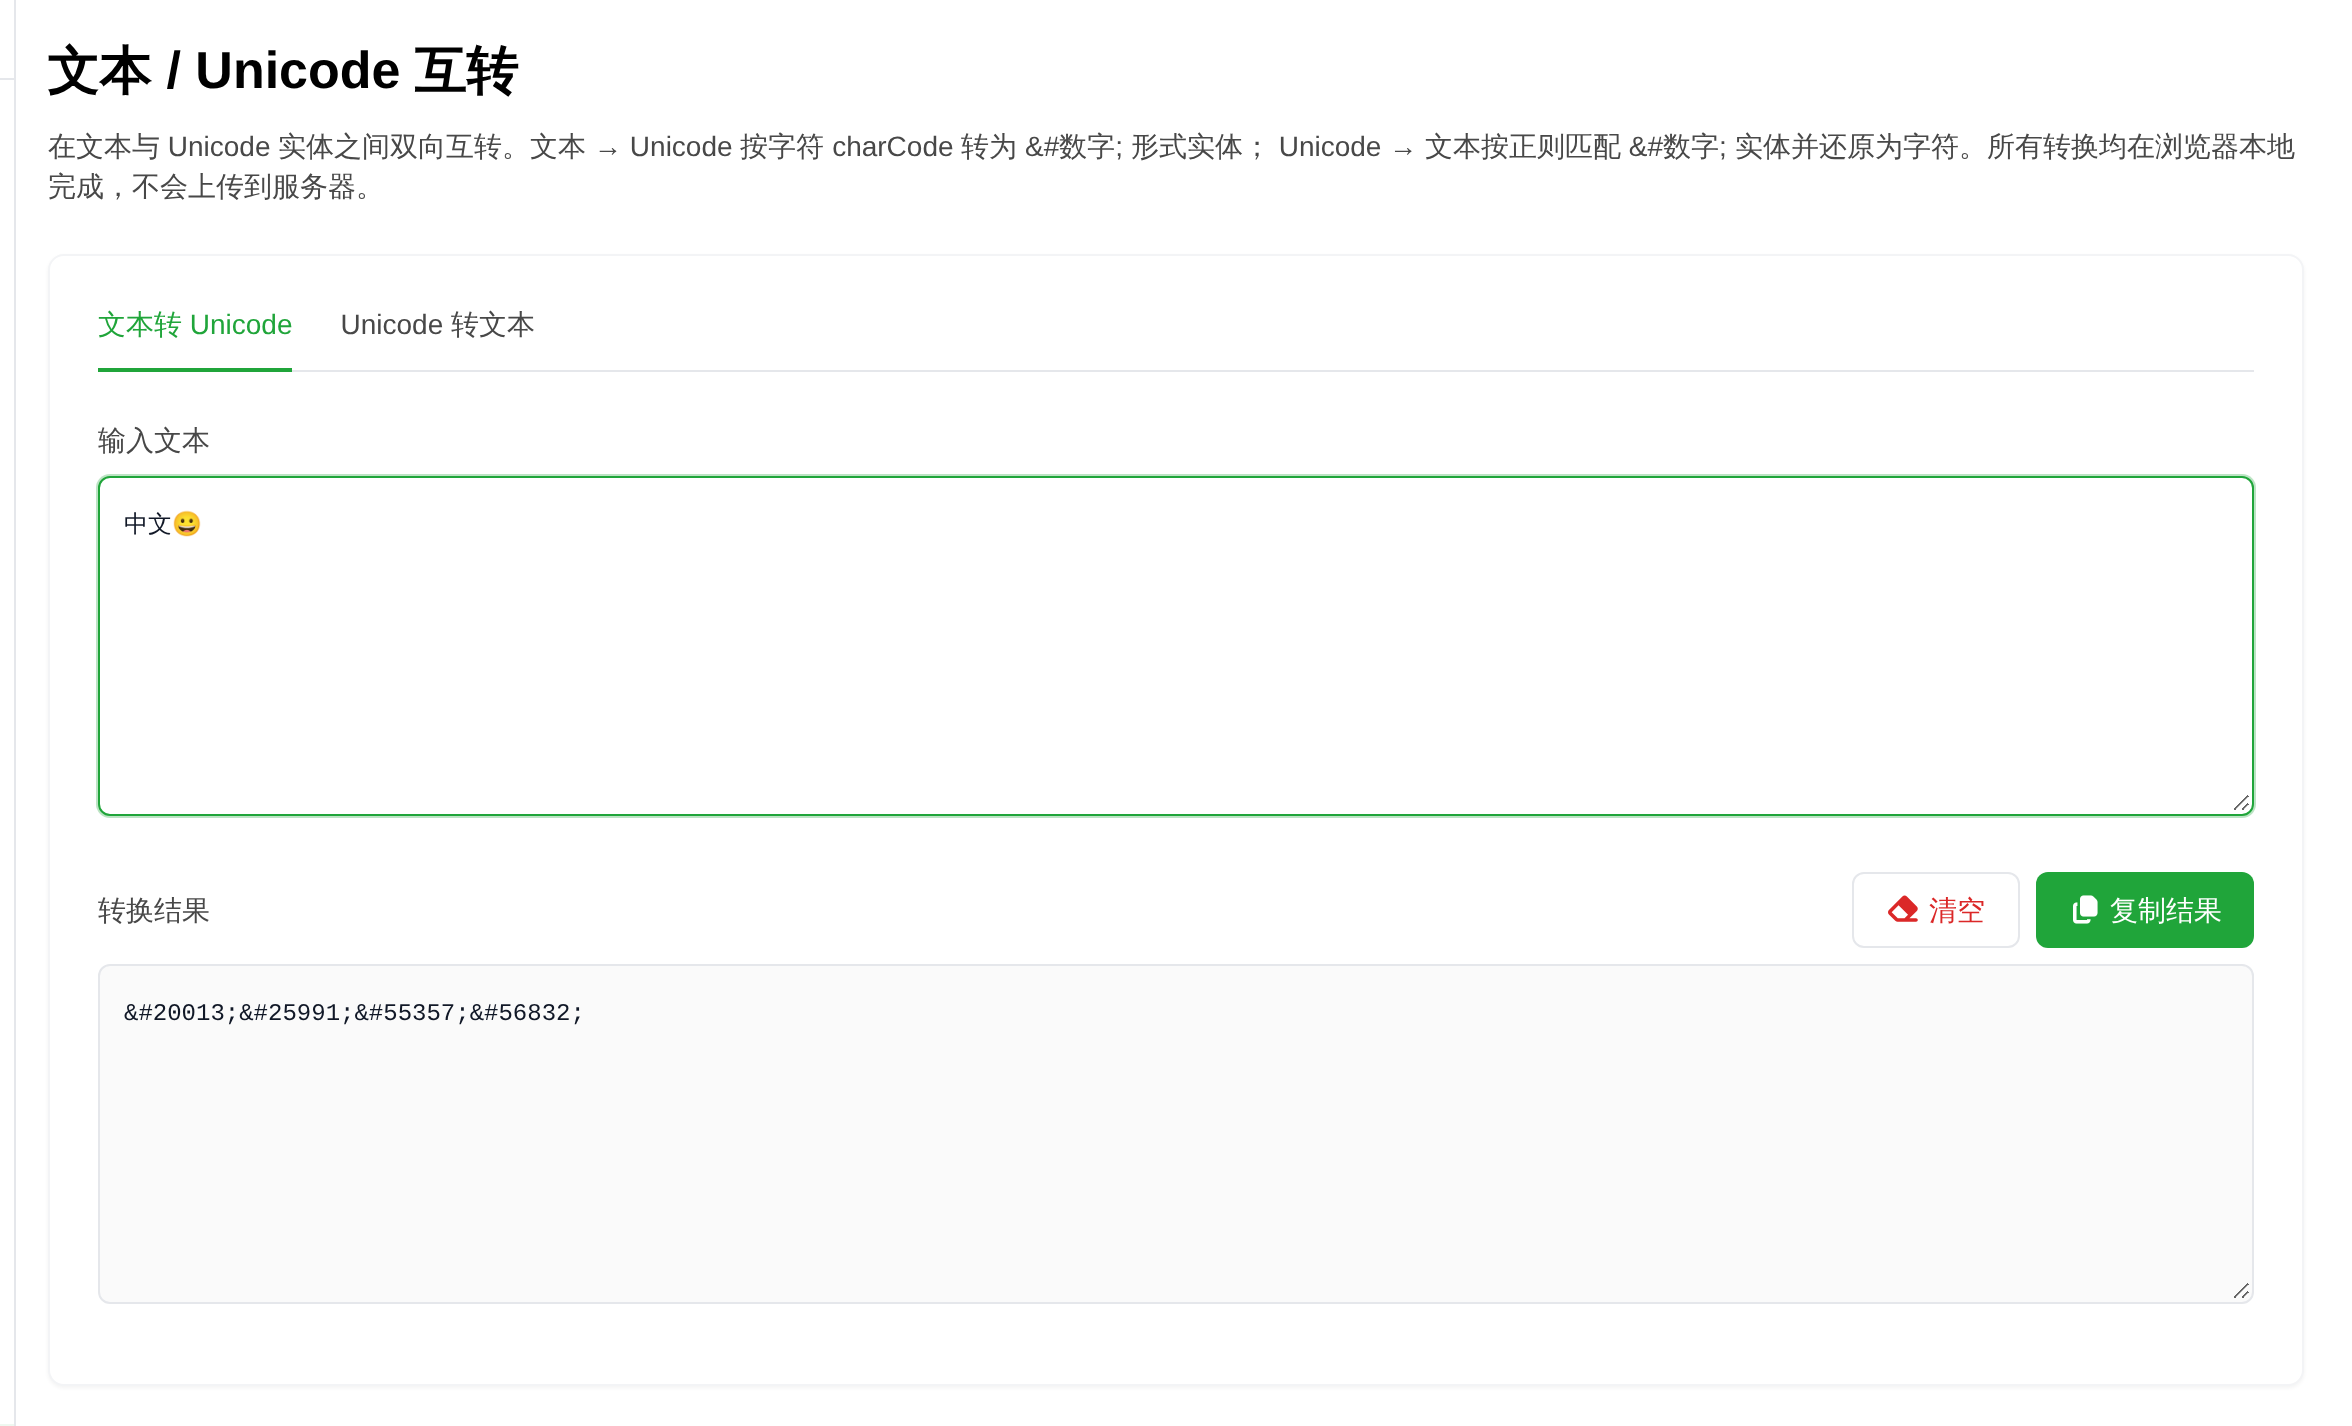
这是这个工具最需要注意的一处。输入 中文😀,输出是:
中文��
😀 的码点是 U+1F600,十进制 128512。但工具取的是 UTF-16 码元,不是码点:一个 16 位码元装不下 128512,这个字符在 UTF-16 里被拆成 0xD83D 和 0xDE00 两个码元,换算成十进制就是 55357 和 56832。
按 HTML 规范,字符引用里出现代理码点属于解析错误,浏览器会把每个代理码元换成 U+FFFD 替换字符。实测把这串输出原样放进页面,渲染结果如下:
| 页面里写的 | 实际渲染 | 渲染出的码点 |
|---|---|---|
中文�� |
中文�� | U+4E2D U+6587 U+FFFD U+FFFD |
😀 |
😀 | U+1F600 |
同一段文字,正确写法是 😀 一个实体,工具给的是两个代理码元,贴到网页上就成了两个乱码字符。
有意思的是,把这串 �� 粘回它的反解框,输出就是 😀:码点 U+1F600,码元 0xD83D 与 0xDE00,两个代理码元拼回了一个字符。反解用的是逐码元 fromCharCode,所以工具自己往返是对的,换到浏览器解析就不对了——这类「工具内部自洽、出圈就错」的结果,只有真的把输出贴进页面才会发现。
反方向也有一个要留意的:如果手上拿到的是正确写法 😀,粘进这个工具的反解框,得到的字符码点是 U+F600,不是 U+1F600。超出 U+FFFF 的值被截断了。所以还原 emoji 这类字符,别指望一次粘贴,要看输出的码点核对,不能只看字形。
网页上显示 中 是怎么回事
标题里这个问题,通常不是编码出了错,而是这串字符根本没被当成 HTML 字符引用解析。按出现位置分两类:
第一类:值被写进了不解析实体的地方。
- 用 textContent / innerText 赋值,值按原样写入,
中就是几个可见字符; - 用 setAttribute 设置属性值,同理;
- 放在 script、style 里,这两个元素内的文本不做字符引用替换;
- 在 JSON 响应里,实体串只是一个普通字符串,前端取出来直接显示就带着 &#。
第二类:被编码了两次。 页面源码里出现 中 时,浏览器解一层得到 中,再显示成字面串。这种情况要把源头那一次多余的转义去掉,而不是继续在页面上加解码。
还有一个容易混的现象:如果整页中文都成了乱码(比如「涓枃」这种),那不是实体问题,是字符集声明和实际字节不一致,跟 中 无关,别往这个工具上找原因。
什么时候该用哪种写法
页面本身是 UTF-8 时,正文直接写中文最稳,不需要任何转义。真正需要转的场景是「通道只允许 ASCII」:
- HTML / XML 正文:用
中或中都行,浏览器按规范解析。宝塔这个工具给的就是十进制形式,可以直接用; - JavaScript 字符串、JSON:用 \u4e2d 或直接写 UTF-8 中文;
中在 JSON 字符串里不会被解析,只会原样显示; - CSS:用 \4e2d 形式(反斜杠加十六进制,必要时后面跟一个空格隔开),CSS 里没有 &# 这种用法;
- URL 参数:用 %E4%B8%AD,这是 UTF-8 字节的百分号编码,不是码点,别把
中塞进 URL; - 邮件主题、短信、只吃 ASCII 的老系统:用十进制实体
中,这类通道对 \u 转义通常不认。
反过来判断也简单:输入框里是 &# 开头,用这个工具;是 \u 开头,用 JSON 工具;是 < & © 这类带名字的,用 HTML 实体工具。
这个工具适合什么
按实测行为,它适合三件事:把中文或任意文本转成十进制 HTML 实体,用于只接受 ASCII 的通道;把从网页源码里抠出来的 &#数字; 串还原成可读文字;核对某个字符码点的十进制值(中 去掉前缀和分号就是 20013)。
它不适合两件事:还原 \uXXXX 转义(会报错),以及处理 emoji 这类超出 U+FFFF 的字符(编码输出代理码元、解码会截断)。这两类去用对应的工具,别在这里反复试。
常见问题
中文转 Unicode 为什么得到 中 而不是 \u4e2d?
因为这两种写法属于两套不同的标记语言。中 是 HTML 的十进制字符引用,后面的数字 20013 就是「中」的码点;\u4e2d 是 JavaScript 与 JSON 的十六进制转义,同一个码点写作 0x4E2D。宝塔这个工具只做前者,页面说明写的就是「文本 → Unicode 按字符 charCode 转为 &#数字; 形式实体」,实测输入「中文」输出 中文。
把 \u4e2d\u6587 粘进「Unicode 转文本」为什么报错?
因为这个工具的反向只匹配 &#数字; 这一种形式。实测输入 \u4e2d\u6587,输出框为空,提示「未识别到合法的 Unicode 实体(形如 A)」;输入十六进制实体 中文 也报同一句。它不认反斜杠转义,也不认 &#x 前缀。
中 和 中 有什么区别?
同一个码点的两种写法:中 是十进制,后面的数字是 20013;中 是十六进制,x 表示后面按 16 进制读,4E2D 等于十进制的 20013。浏览器两种都认,但宝塔这个工具只认十进制,粘十六进制会报「未识别到合法的 Unicode 实体」。
为什么 emoji 转出来是 �� 而不是 😀?
工具按 UTF-16 码元逐个取值,不按码点。😀 的码点是 U+1F600,十进制 128512,超出单个 16 位码元能表示的范围,在 UTF-16 里拆成两个码元 0xD83D 和 0xDE00,十进制就是 55357 和 56832。正确写法应该是 😀 一个实体,而不是两个代理码元。
工具转出来的 emoji 实体贴到网页上为什么变成两个替换字符?
因为 � 这类值落在代理码点区间,HTML 解析时属于解析错误,规范要求换成 U+FFFD 替换字符(不同字体下显示为问号、方框或黑菱形)。实测把 中文�� 放进页面,渲染出来是「中文」加两个 U+FFFD;同一页面里写 😀 则正常渲染成 😀。工具自己粘回去能还原,是因为它的反向用 fromCharCode 逐码元拼回,恰好凑成代理对。
网页上直接显示 中 这一串,是什么原因?
说明这串字符没有被当成 HTML 字符引用解析。两种常见情况:一是它被写进了 textContent、value 或 setAttribute,这些接口按原样赋值;二是它在 script、style 这类不解析字符引用的元素里。另外,内容被编码两次时会显示成 &#20013;,那是另一个问题。
什么时候真的需要把中文转成实体?
页面本身是 UTF-8 时不需要,直接写中文最省事。需要转的场景是通道只允许 ASCII:邮件主题、部分短信网关、只接受 ASCII 的老系统表单。这时优先用 中 这种十进制实体,别用 \u 转义——后者只有 JavaScript 字符串和 JSON 里才有意义,写进 HTML 正文会原样显示成 \u4e2d。