文本转二进制后中文解不回来?charCode 到 15 位、8 位分组对不上
宝塔的文本 / 二进制互转工具只做一件事:把字符的 charCode 写成二进制,再把 8 位一组的二进制还原成字符。它按 UTF-16 码元逐个字符转换,不是按 UTF-8 字节。所以 ASCII 文本能干净地往返,中文不行——实测「中文」转出两组 15 位,粘回反解框直接报「无效的二进制字符串:必须是 8 位分组的二进制」。
下面每个输入输出都来自 2026-11-08 在同一次运行里的记录,截图与正文数字同源。页面说明写的是「文本 → 二进制按字符 charCode 转为 8 位二进制,空格分隔;二进制 → 文本按 8 位分组还原为字符」,转换在浏览器本地完成、不上传服务器。
ASCII 是 9 个字符换 9 组 8 位
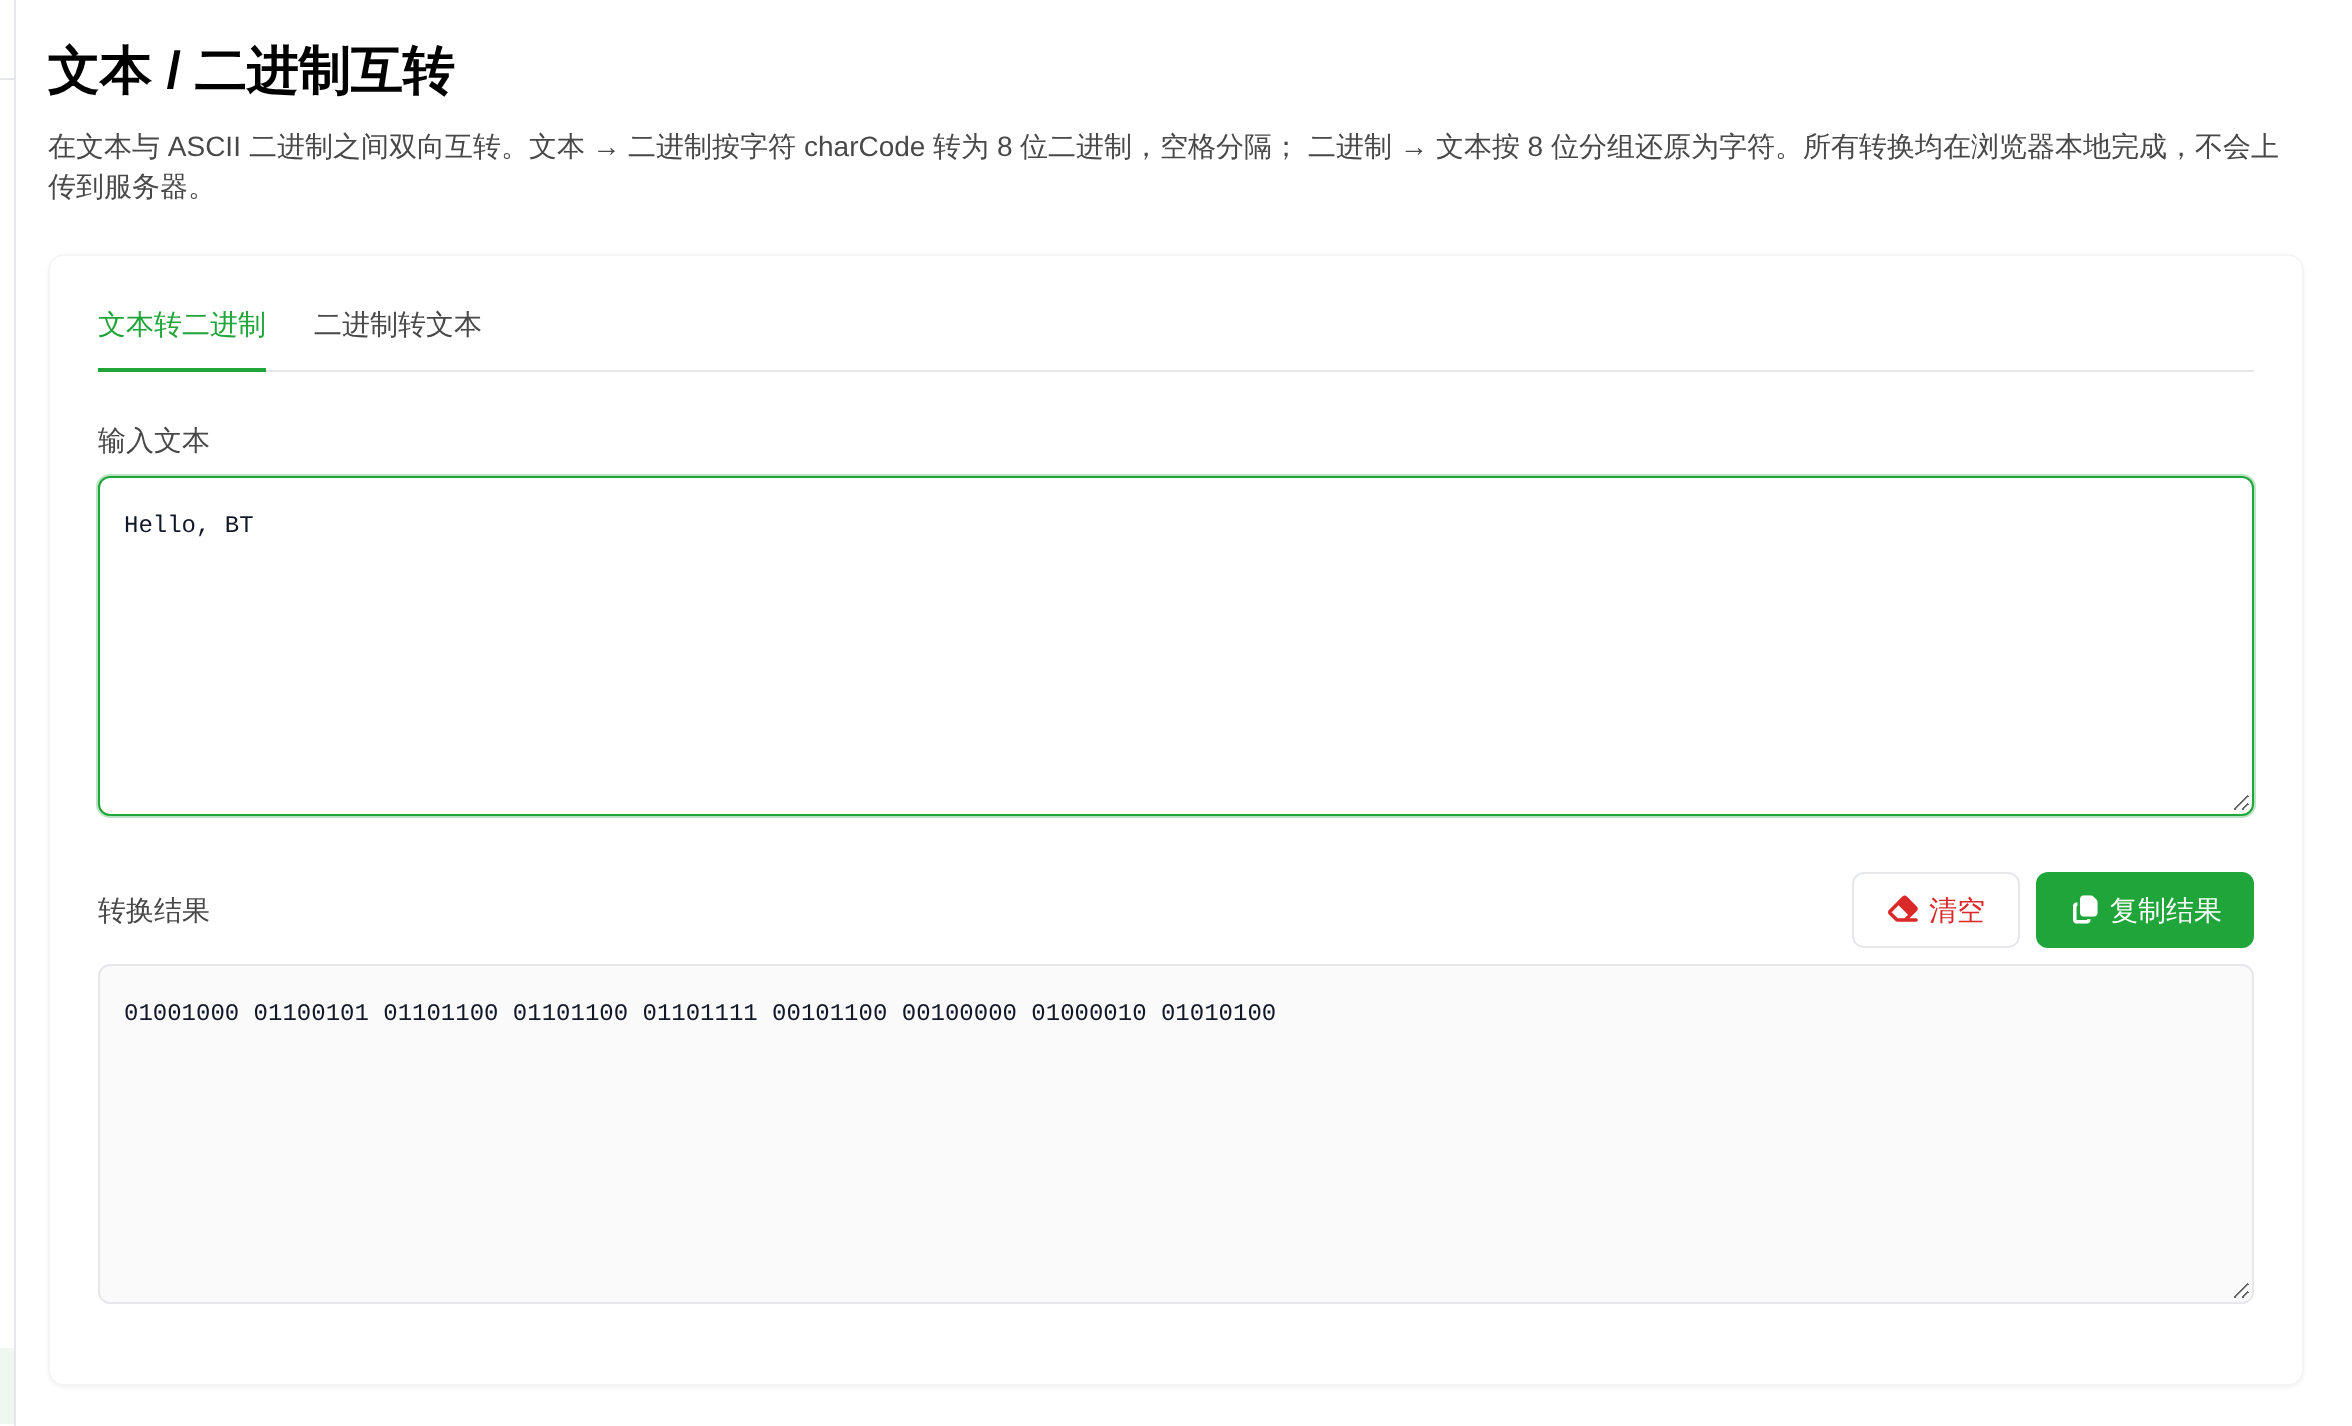
输入 Hello, BT,输出:
01001000 01100101 01101100 01101100 01101111 00101100 00100000 01000010 01010100
9 个字符全部命中,逗号和空格也算在内:H 的码位是 72,写成 8 位是 01001000;空格的码位是 32,写成 00100000。ASCII 范围内 charCode 就等于字节值,所以这一程两个方向都对得上。
中文不是 8 位:码位到了 15 位,补零补不出 8 位
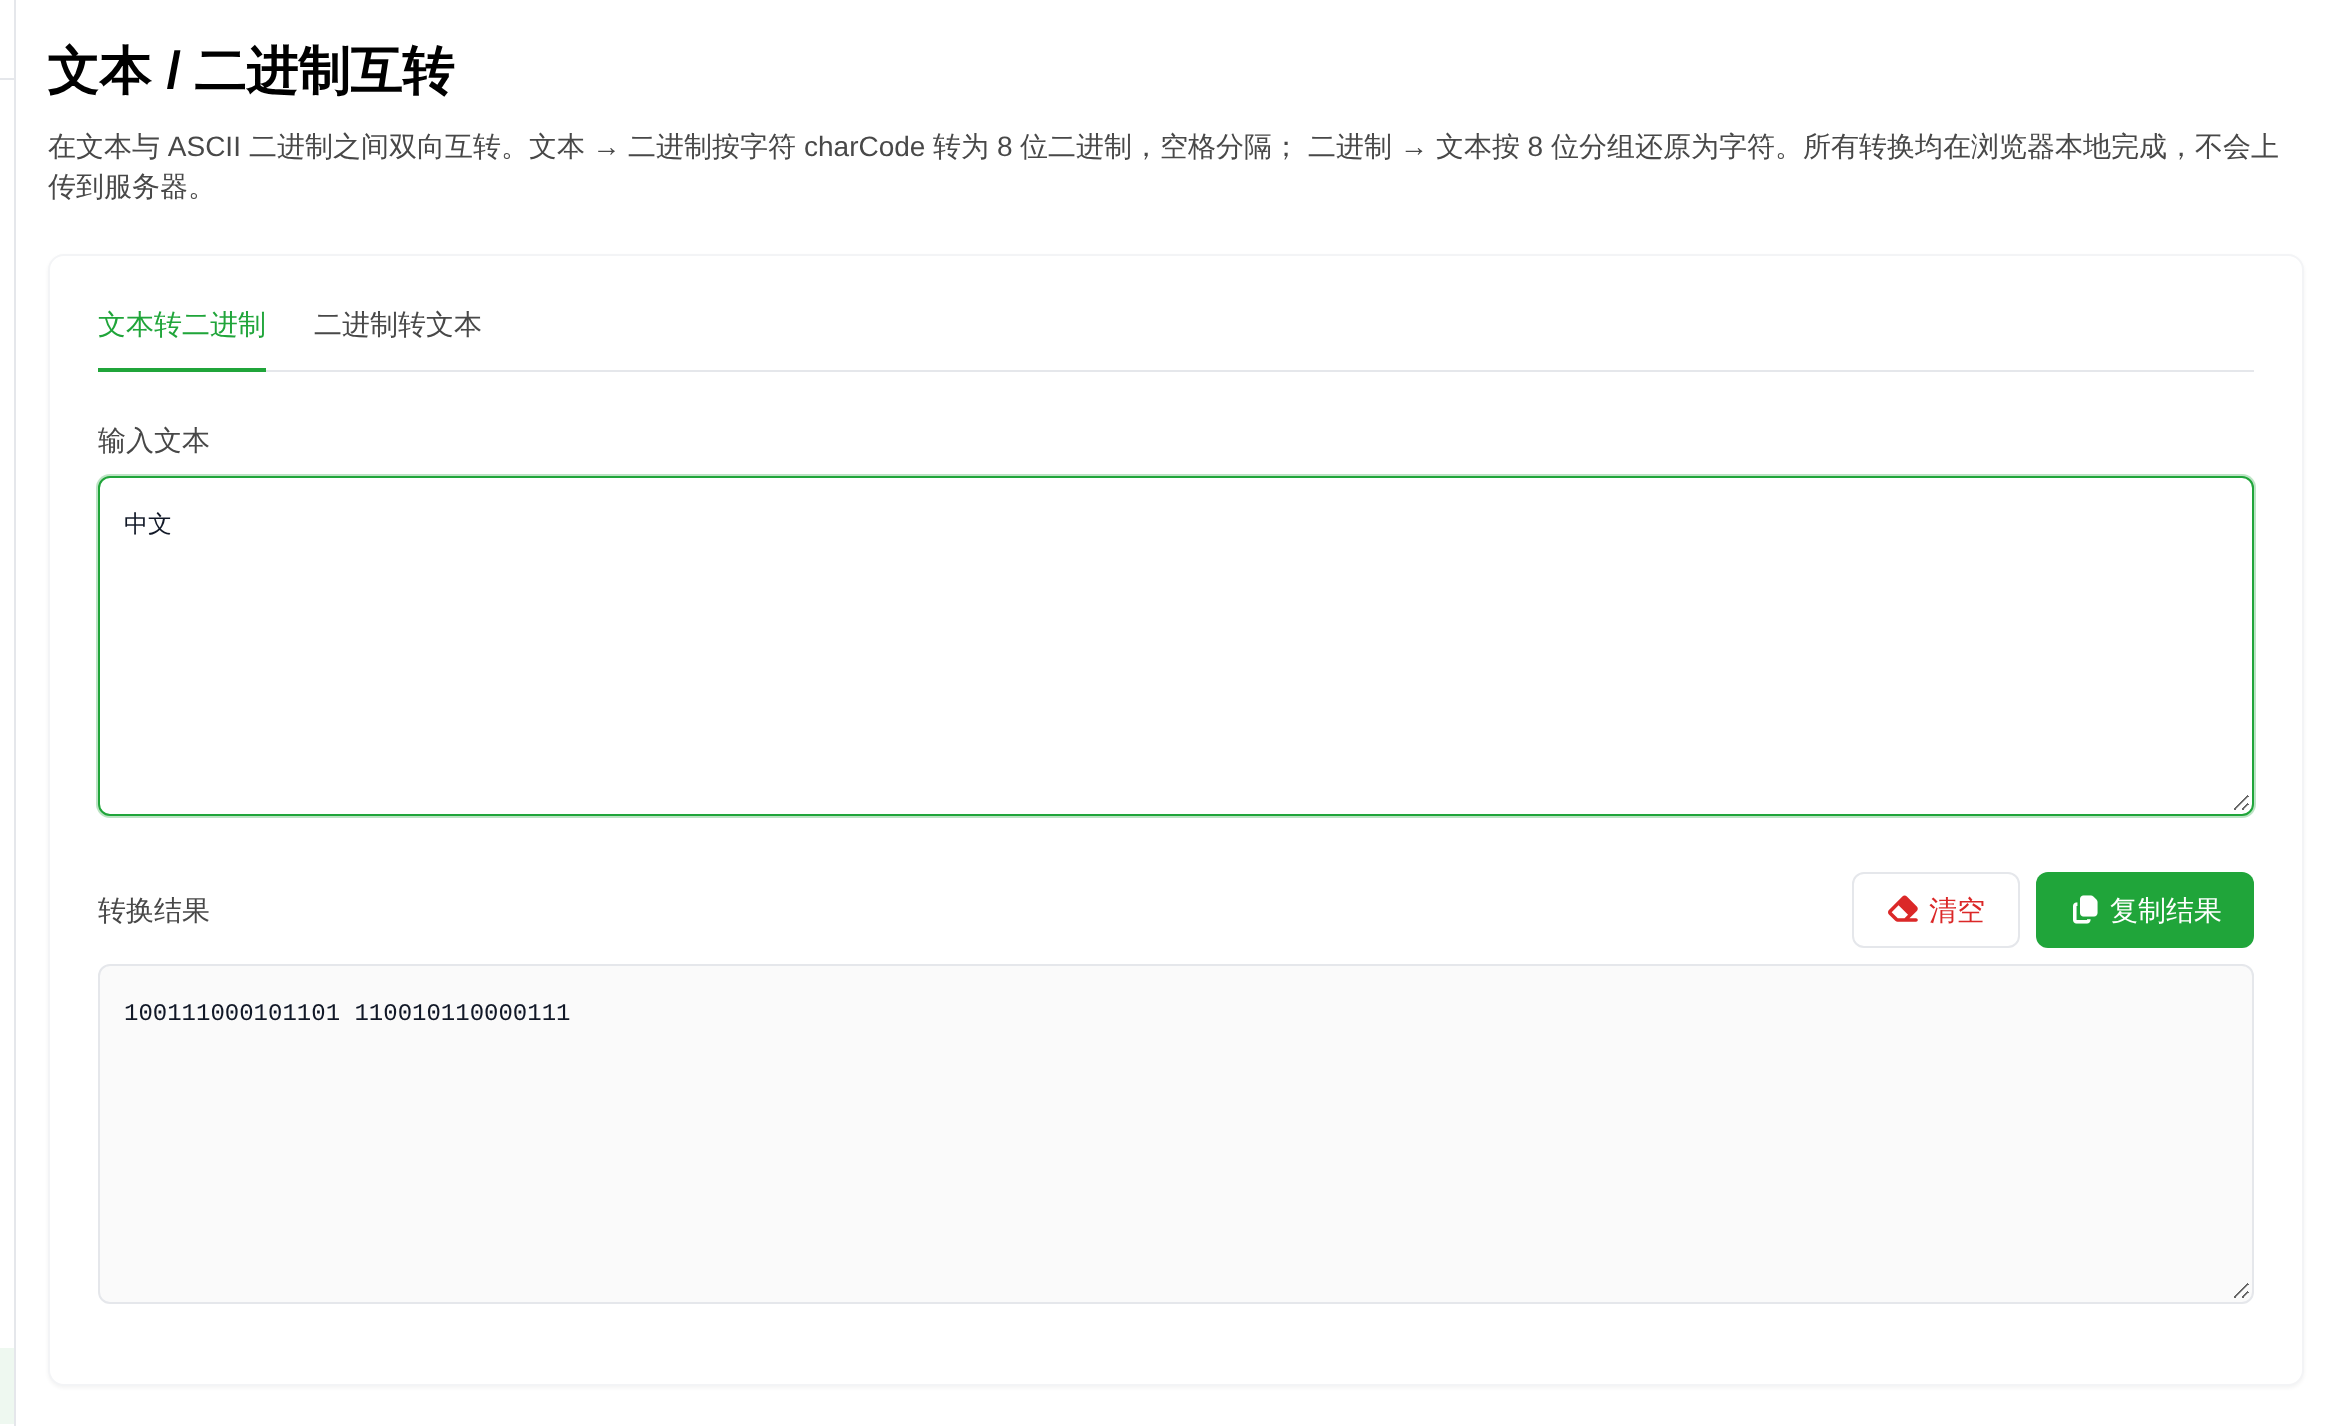
同样在这一页输入 中文,输出是:
100111000101101 110010110000111
两组,每组 15 位。「中」的码位是 U+4E2D,十进制 20013;「文」是 U+6587,十进制 25991。这两个数都超过 255,8 位装不下,转出来自然不是 8 位。
注意分组还是照旧用空格隔开,所以看起来像「8 位一组」的格式,实际每组 15 位。这也是最容易误判的地方:扫一眼是空格分隔的二进制串,就以为能直接粘回去。
页面定位是「在文本与 ASCII 二进制之间双向互转」,8 位这个说法在 ASCII 范围内成立;落差出现在输入框提示写「支持中英文」——中文的码位装不进 8 位,实测输出就是 15 位。写中文二进制串时,位数要按实际码位核对,不能按 8 位一组去切。
反解报错的原因:位数不是 8 的倍数
把上面那串 30 位粘进「二进制转文本」,输出框是空的,下面红字提示「无效的二进制字符串:必须是 8 位分组的二进制」。
工具的反解规则是:先删掉所有非 0/1 的字符,再看剩下的位数能不能被 8 整除。30 除以 8 余 6,不满足,直接报错。同样的规则下,只输 7 位 0100100 也会报同一句话——校验的是分组长度,不是内容是否符合某种编码。
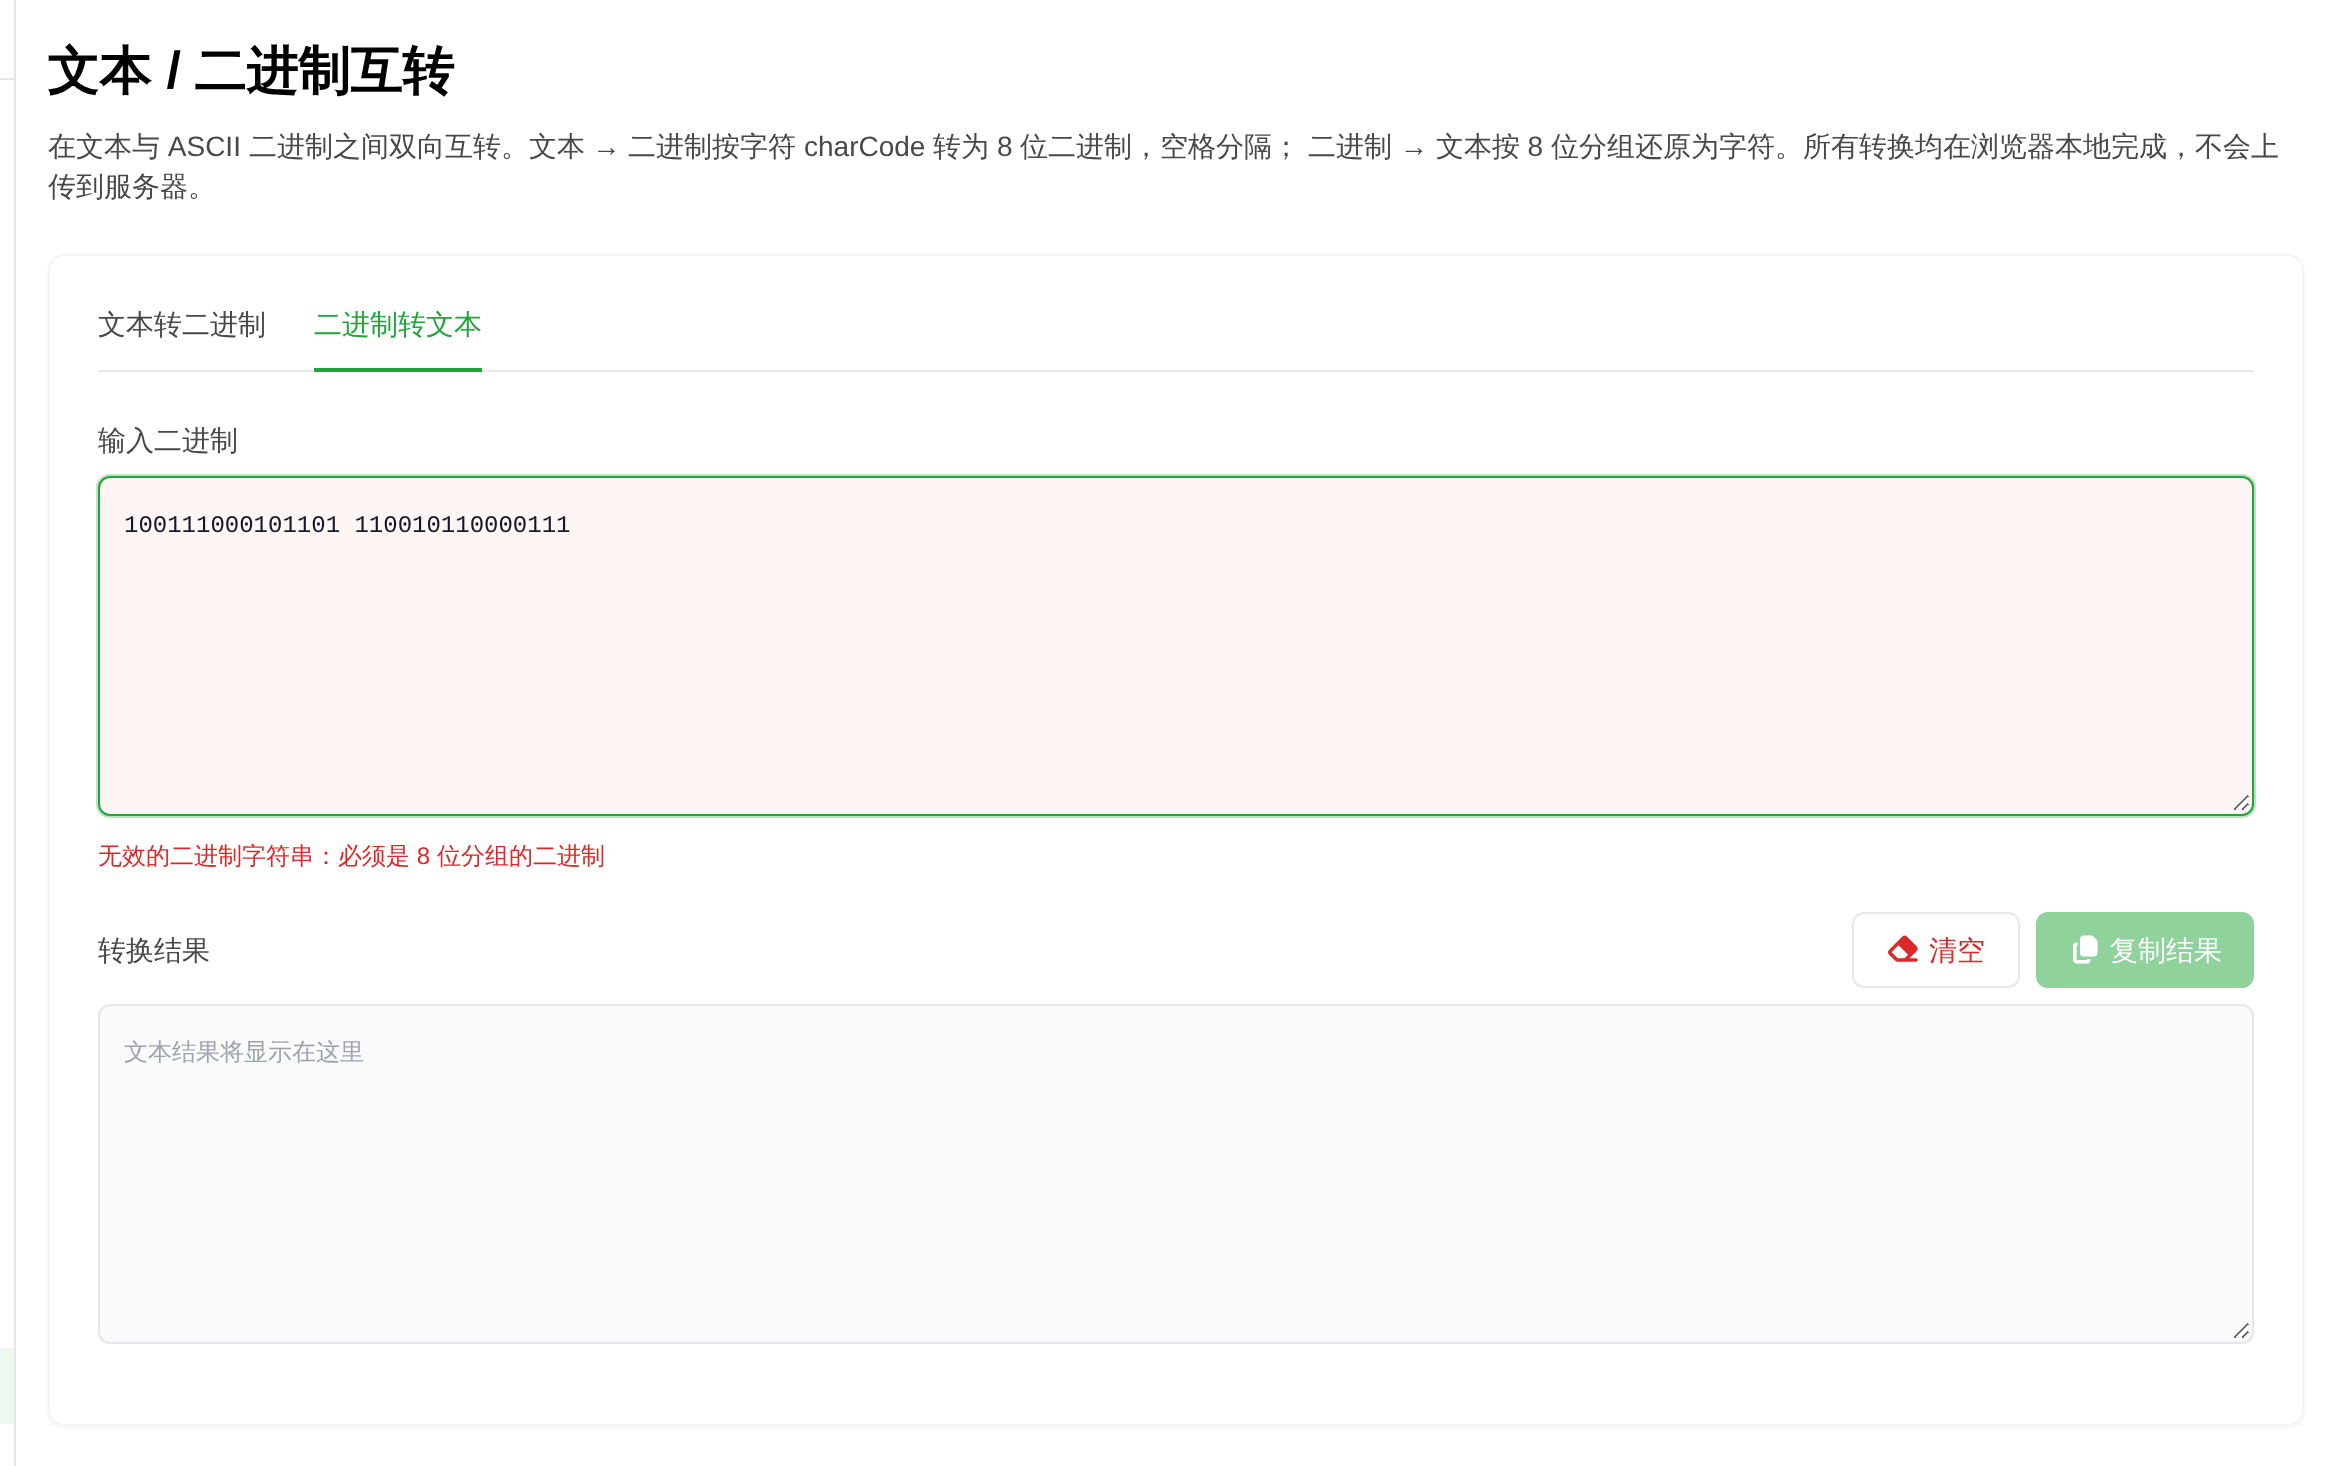
所以「中文解不回来」不是少粘了字符,也不是换行影响了结果:15 位就是这两个汉字的真实码位长度。想让它通过长度校验,只能把位数凑成 8 的倍数,但那样改的是数值,解出来是另一个字符。
粘 UTF-8 字节得到 ä¸:反解按码元还原,不做 UTF-8 解码
既然按 charCode 转不行,很多人会想「那就先转成 UTF-8 字节,再转二进制」。方向没错,但把结果粘回这个工具会看到另一幕。
「中」的 UTF-8 字节是 E4 B8 AD,写成二进制是 11100100 10111000 10101101。粘进反解框,输出是三个字符,码位分别是 228、184、173——也就是十六进制的 E4、B8、AD,显示出来是 ä¸。第三个字符是 U+00AD 软连字符,在页面上默认不可见,所以看起来只有两个字符。
原因在反解的还原方式:每 8 位取一个数值,直接当成一个 UTF-16 码元还原。228、184、173 都在 Latin-1 范围,各自变成一个字符,于是三个字节变成三个字符。UTF-8 是变长编码,一个汉字要三个字节拼起来才是一个字符;按字节逐个还原,拿到的只能是乱码。
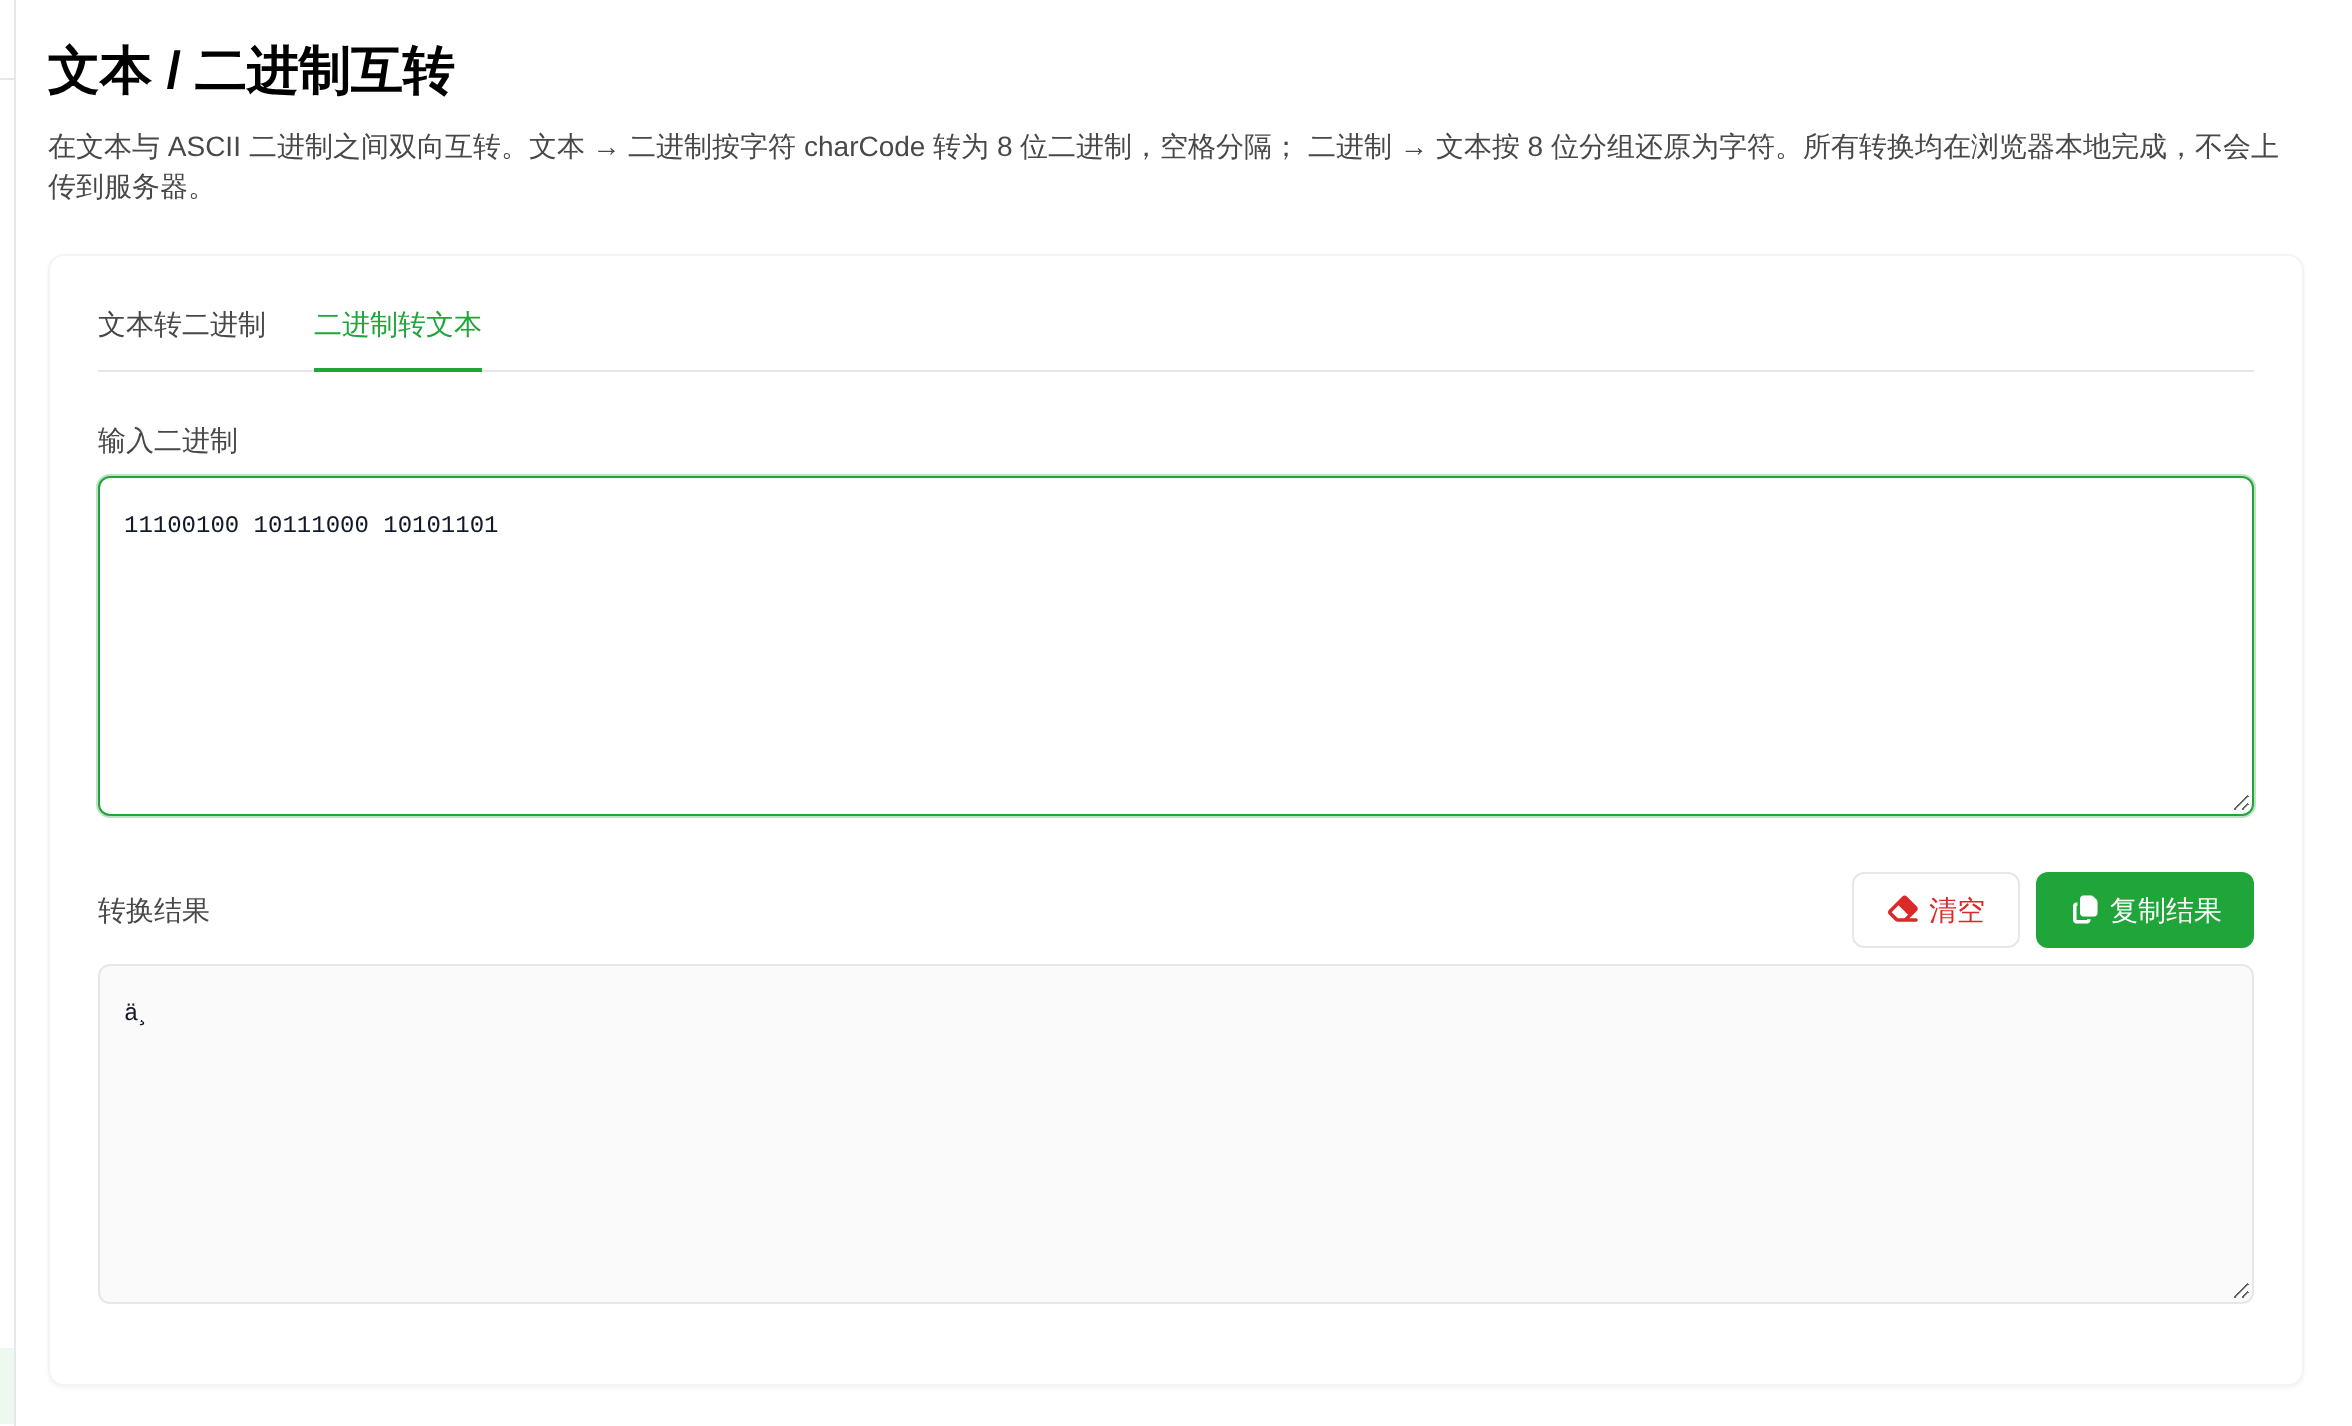
这也说明这个工具不是 UTF-8 解码器:它能过长度校验,但不会把多字节序列拼成字符。要按 UTF-8 还原,得用专门的解码器,而不是这个 8 位分组还原框。
空格可省,混进来的其他字符会被静默删掉
反解不依赖空格。实测输入 0100100001101001(16 位连写)解出 Hi;输入 01001000x01101001 也解出 Hi,中间的 x 被删掉了,没有报错。
方便的地方是复制粘贴时不用清理格式;风险也在同一处——任何非 0/1 字符都会被静默删除,不报错。粘进来的如果是十六进制(例如 48 69),四个字符里没有 0 或 1,会被全部删掉;如果恰好含 0 和 1,留下的位也和原来的字节值无关。粘之前先确认来源是二进制串,不是十六进制或十进制。
emoji 是代理对:一个字符两组 16 位
输入 A😀,输出:
01000001 1101100000111101 1101111000000000
A 是 8 位,😀 的码位是 U+1F600,UTF-16 里用两个码元(0xD83D、0xDE00)表示,各 16 位。所以含 emoji 的文本,组数和字符数对不上,总位数也几乎不可能是 8 的倍数。要判断一串二进制能不能被这个工具还原,先数位数,再数它是否按 8 位对齐——不要按「几个字符」估算。
要真正的字节二进制,先编码再转
如果目标是把一段文本变成「字节的二进制表示」,正确顺序是先编码成字节,再逐字节转二进制。在 Node.js 里可以直接跑:
node -e 'const b=Buffer.from("中文","utf8"); console.log([...b].map(x=>x.toString(2).padStart(8,"0")).join(" "))'
输出是 11100100 10111000 10101101 11100110 10010110 10000111,6 个字节,对应十六进制 e4 b8 ad e6 96 87。这才是「中文」在 UTF-8 下的字节,和工具按码位转出来的两组 15 位不是一回事。
要还原成文字,也要按 UTF-8 解码:把字节交给 TextDecoder 或 Buffer.toString("utf8")。二进制串本身不携带「这是 UTF-8」的信息,同一个字节序列按 Latin-1 读是乱码、按 UTF-8 读才是汉字——这正是上面 ä¸ 那次结果的来源。
这个工具适合什么
按实测行为,它适合三类事:把纯 ASCII 文本变成 0/1(协议字段、教学演示、给孩子讲二进制);查某个字符的 charCode 数值;把一段已经是 8 位分组的二进制还原成 ASCII 文本。转换在浏览器本地完成,页面说明写明不上传服务器。
不适合两类事:中文、emoji 的往返(位数不是 8 的倍数,反解会报错或错位);把 UTF-8 字节当文本还原(只会得到 Latin-1 乱码)。要做编码转换,用对应的工具:Base64 编码解码处理的是字节到可打印字符的转换,URL 编码解码处理 %HH,HTML 实体编码处理标签转义——三个各管一个上下文,都不负责「码位转二进制」这件事。
常见问题
中文转成二进制为什么不是 8 位一组?
因为这个工具按字符的 charCode 转换,而一个汉字的码位超过 255。实测输入「中文」,输出是 100111000101101 110010110000111,两组各 15 位:中的码位 U+4E2D 等于 20013,文的码位 U+6587 等于 25991,都装不进 8 位。8 位二进制最大只能表示 255,ASCII 字符正好在范围内,所以只有 ASCII 能凑成 8 位一组。
把中文的转换结果粘回二进制转文本,为什么直接报错?
工具反解时会先去掉所有非 0/1 字符,再要求剩下的位数是 8 的倍数。实测两个汉字转出的 30 位,30 除以 8 余 6,于是输出框为空并提示「无效的二进制字符串:必须是 8 位分组的二进制」。这不是中文被过滤掉了,而是这串二进制本身就不是按 8 位分组的格式。
把 UTF-8 的 11100100 10111000 10101101 粘进去,为什么显示成 ä¸?
因为反解把每 8 位当成一个 UTF-16 码元直接还原,不做 UTF-8 解码。实测这三个字节得到的三个字符码位是 228、184、173,也就是十六进制的 E4、B8、AD,落在 Latin-1 范围内,显示出来就是 ä¸。UTF-8 里一个汉字是三个字节组合成一个字符,拆开逐个还原只能是乱码。
二进制之间不加空格可以吗?
可以。工具反解不依赖空格分隔,实测 0100100001101001 解出 Hi,夹一个字母写成 01001000x01101001 也解出 Hi,x 被直接剥掉。反过来要注意:任何非 0/1 字符都会被静默删除、不报错,所以把十六进制(比如 48 69,四个字符里没有 0 或 1)粘进来会被整段删空;含 0 和 1 的其他格式则会留下与原值无关的位。
emoji 转出来为什么是 16 位?
emoji 在 UTF-16 里由代理对表示,一个字符占两个码元。实测输入 A😀,输出是 01000001 1101100000111101 1101111000000000,后两组各 16 位,分别对应 😀 的两个码元。所以含 emoji 的文本不仅总位数不是 8 的倍数,组数也会比字符数多。
那要怎么得到真正的 UTF-8 字节二进制?
先用编码器把字符串变成字节,再逐字节转二进制。在 Node.js 里跑 Buffer.from(中文, utf8) 得到 6 个字节,转成二进制是 11100100 10111000 10101101 11100110 10010110 10000111。注意这段粘回本工具的反解框仍然是 6 个 Latin-1 字符,要还原成文字得按 UTF-8 解码(TextDecoder),工具只负责码元还原。