XML 转 JSON 后属性和 CDATA 去哪了?_attributes、_text 与「单个节点不是数组」一次讲清
把一段 XML 粘进转换工具,点「转换为 JSON」,第一眼通常会觉得结构怎么这么怪:属性跑到 _attributes 里,文本跑到 _text 里,同一个标签只出现一次时是对象、出现两次就变数组。这既不是转换出错,也不是工具偷懒,而是 XML 和 JSON 两套数据模型对不上时,必须有人做取舍。下面所有输入输出,都来自 宝塔 XML/JSON 互转工具 的一次真实运行,截图和内容取自同一次操作。
一段带属性的 XML,转出来是什么样
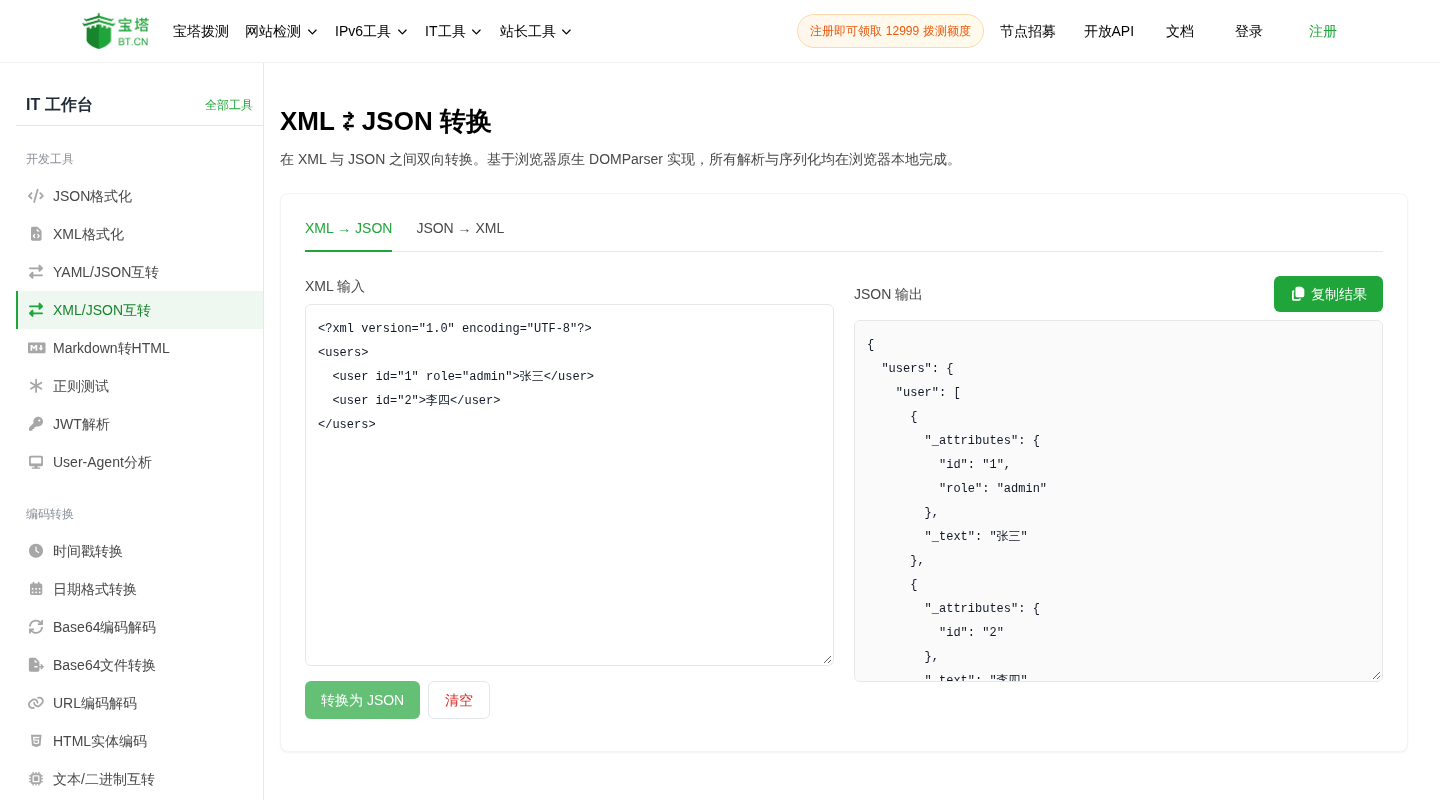
输入:
<?xml version="1.0" encoding="UTF-8"?>
<users>
  <user id="1" role="admin">张三</user>
  <user id="2">李四</user>
</users>
输出:
{
  "users": {
    "user": [
      {
        "_attributes": {
          "id": "1",
          "role": "admin"
        },
        "_text": "张三"
      },
      {
        "_attributes": {
          "id": "2"
        },
        "_text": "李四"
      }
    ]
  }
}
四条规则一次看全:根元素变成 JSON 唯一的顶层键;元素上的属性收进 _attributes;元素里的文本收进 _text;同名子元素有两个,所以 user 是数组。
属性为什么要单独装一层,不能直接当键
<user id="1"> 里的 id 在 XML 里是属性,JSON 没有属性的概念,只能变成键值对。但直接平铺会撞车:<user id="1"><id>2</id></user> 里属性和子元素都叫 id,平铺之后一个会盖掉另一个。所以工具把所有属性统一收进名为 _attributes 的对象,正文内容收进 _text,两者和子元素各占一层。
代价是取值路径变长:原来是 user.id,转成 JSON 后要写 user._attributes.id。更要紧的是这个前缀只是本工具的约定——它不属于 XML 规范,也不属于 JSON 规范(RFC 8259)。换一个解析库,键名可能变成别的形式,同一个 XML 出来的结构就不一样了。所以拿在线工具看一眼结构很合适,真要接进程序,还是用固定版本的库并把这层映射写进代码里。
另外注意:属性值一律是字符串。<rss version="2.0"> 转出来是 "version": "2.0",不会被当成数字,这一点和 YAML 转 JSON 的口径相反,不会出现「2.0 变 2」这类改写。
一个子元素是对象、两个子元素是数组
同一份数据,多一条记录,类型就变。实测两种输入:
<list><item>a</item></list>输出 {"list": {"item": {"_text": "a"}}} —— item 是对象。
<list><item>a</item><item>b</item></list>输出 {"list": {"item": [{"_text": "a"}, {"_text": "b"}]}} —— item 变成数组。
XML 里没有「数组」这个东西,解析器只能靠同名标签出现几次来猜。出现一次时不敢当成数组,因为绝大多数元素本来就是单例,全部包成数组反而没人用。取这个折中的结果是:消费端必须自己归一化。
Node.js 里常见写法:
const items = [].concat(data.list.item ?? []);Python:
items = data["list"]["item"]
if isinstance(items, dict):
items = [items]写采集脚本时,第一版基本都在这里翻车:接口今天返回一条记录是对象,明天返回两条就是数组,for (const it of data.list.item) 直接把对象当可迭代对象用,报错还看不出原因。
这四类内容,转过去就没了
- 注释。
<!-- 部署配置 -->不会出现在 JSON 里。JSON 标准(RFC 8259)没有注释语法,浏览器 DOM 里注释也是独立节点类型,转换只处理元素节点和文本节点。 - CDATA。
<name><![CDATA[a & b]]></name>实测输出"name": {},整段内容消失。CDATA 是 XML 里「这段字符原样保留、不解析实体」的写法,在 DOM 里是独立的 CDATA 段节点,不是文本节点,所以被跳过。 - 混排文本的顺序和空格。
<desc>价格 <b>100</b> 元</desc>转成{"desc": {"b": {"_text": "100"}, "_text": "价格元"}}:两段文本被拼在一起,「价格」和「元」中间的空格没了,而「元」原本在<b>后面,这个位置信息已经丢了。 - 空白与空元素。
<empty/>转成{};只含空白字符的文本节点被丢弃。
这四条都属于格式表达能力的差异,不是 bug,但决定了 XML 转 JSON 只能当「取值」用,不能当「备份」。带注释的配置文件、把富文本存在 CDATA 里的接口、正文夹标签的 RSS 描述,转成 JSON 都会缺内容。要校验格式本身对不对,用 XML 格式化工具 的校验更直接。
JSON 转 XML:只认第一个顶层键
反向转换的第一个坑不在写法上,在结构上。输入:
{"server":{"host":"api.example.com","port":80,"tls":false,"tags":["a","b"],"limit":null},"client":{"timeout":5}}输出:
<?xml version="1.0" encoding="UTF-8"?>
<server>
  <host>api.example.com</host>
  <port>80</port>
  <tls>false</tls>
  <tags>a</tags>
  <tags>b</tags>
  <limit />
</server>
client 整段不见了,也没有任何提示。因为 XML 只能有一个根元素,工具取 JSON 的第一个顶层键当根标签,其余顶层键直接不参与输出。贴 JSON 之前先确认它只有一个顶层键,否则手动包一层 {"root": {…}}。
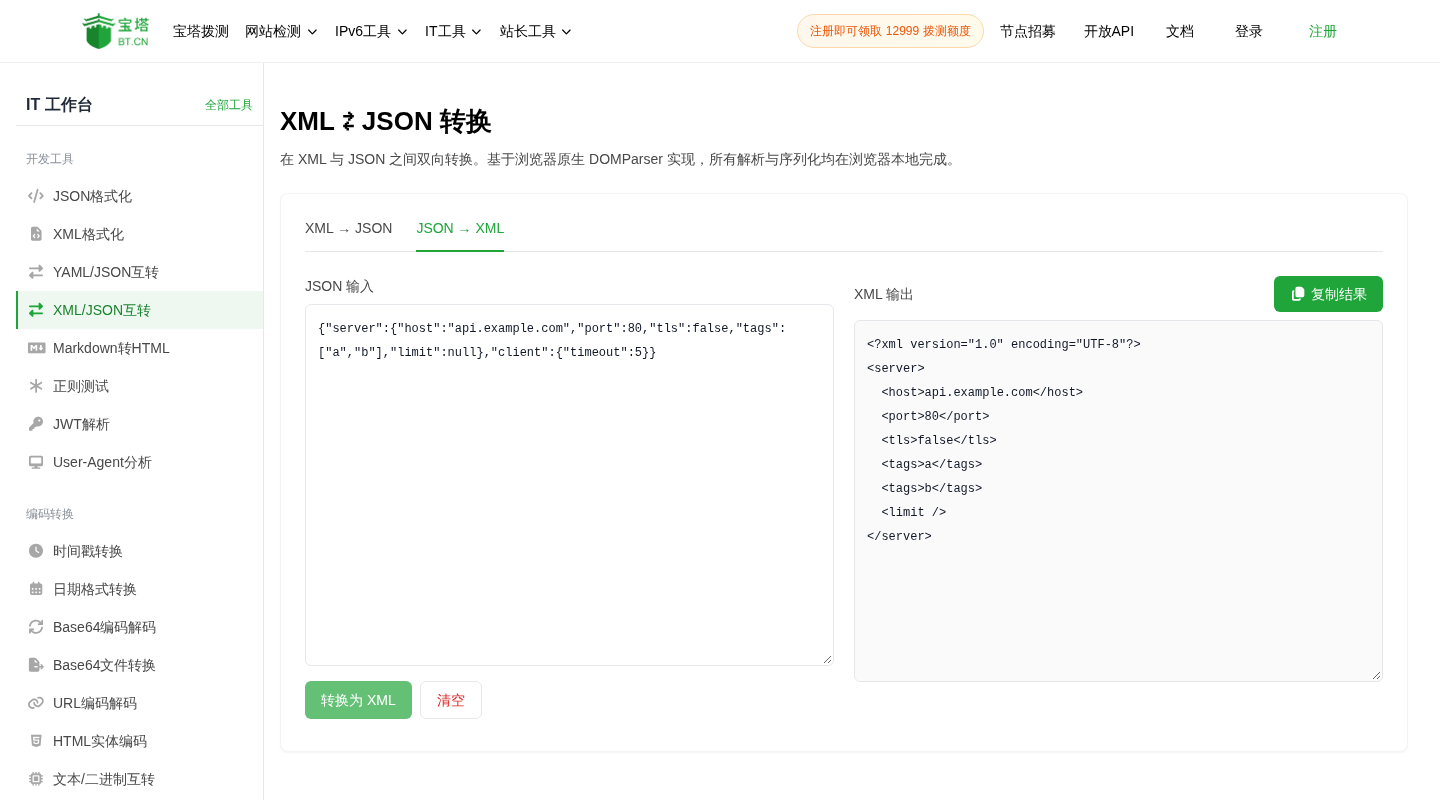
这段输出同时演示了三条类型规则:
- 数字
80写成<port>80</port>,布尔false写成<tls>false</tls>——XML 里没有类型,落到标签里都是文本,程序读回来要自己转。 null写成自闭合的<limit />。- 数组写成同名标签重复出现:
["a","b"]变成两个<tags>。
还有两个更容易忽略的:
_text和子节点并存时,_text被丢弃。{"name": {"_text": "内联", "child": "x"}}输出的是<name><child>x</child></name>,「内联」两个字没了。往回转的时候不要同时给_text和子元素。- 不合法的标签名照样输出,不报错。
"bad key"、"3rd"会生成<bad key>、<3rd>,而 XML 规定名字不能含空格、不能以数字开头。工具只管拼字符串,不校验名称合法性,等这份 XML 被别的程序读取时才报错——而且那时已经很难想到是键名的问题。
转回去能还原到什么程度
把第一段 JSON 输出原样贴回 JSON → XML,得到:
<?xml version="1.0" encoding="UTF-8"?>
<users>
  <user id="1" role="admin">张三</user>
  <user id="2">李四</user>
</users>
属性、文本、中文、顺序都对得上,实体也被正确转义:输入 JSON 里 note 的值是 a & b "q"、文本是 x < y(JSON 字符串里就是裸的 & 和 <),转成 XML 后变成 note="a & b "q""、<v>x < y</v>,可以正常解析。这一圈属于可信的部分。
回不去的是数组标记:{"list": {"item": [{"_text": "a"}]}} 只有一个元素,转成 <list><item>a</item></list>,再转回 JSON 就变成 {"list": {"item": {"_text": "a"}}} —— 数组没了。所以「XML → JSON → XML → JSON」不能保证结构一致,往返转换适合人工核对字段,不适合当数据管线。
报错里的行列号,藏在英文长句中间
输入一份标签没闭合的 XML:
<root>
  <a>1</a>
  <b>2</root>
点转换后,工具在下方输出:
This page contains the following errors:error on line 3 at column 13: Unexpected closing tag: root != bBelow is a rendering of the page up to the first error.这段是浏览器内置的 XML 解析器(DOMParser)的原文,工具只是把它原样转出来,所以是英文、前后还夹着两句样板句。有用的只有中间那截 error on line 3 at column 13: Unexpected closing tag: root != b:第 3 行第 13 列,遇到了结束标签 root,可当时还开着的是 b —— 也就是 <b> 没闭合就写了 </root>。行列号从 1 开始数,不是下标。
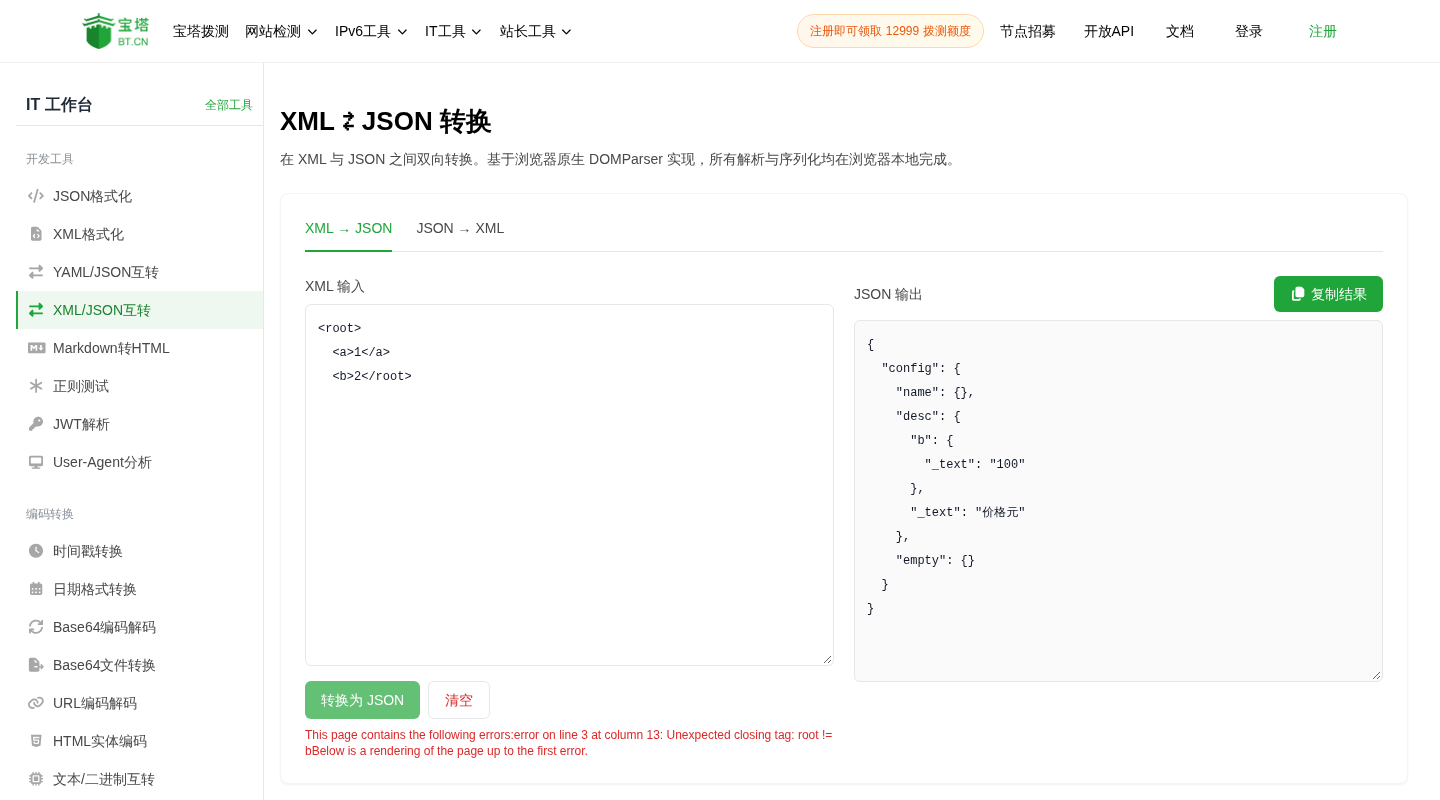
这张图里还有一个容易误判的细节:报错时右侧输出框不会被清空,还留着上一次成功的结果。图里左边是刚输入的 <root>,右边却是上一条的 config,看着像「转换成功了」,实际是上一次的残留。看到红色报错就以报错为准,别拿右边的旧内容当结果。
JSON 方向的报错来自 JSON.parse,同样是英文但格式不同,例如 Expected double-quoted property name in JSON at position 7 (line 1 column 8):position 是字符下标(从 0 开始),后面括号里才是行列号。多一个逗号、少一个引号,基本都在这条报错里指出来了。
命名空间和编码:能过,但只是当字符串过
带前缀的 RSS 片段:
<rss xmlns:dc="http://purl.org/dc/elements/1.1/" version="2.0">…<dc:title>T</dc:title></rss>转出来 xmlns:dc 和 version 都在 _attributes 里,dc:title 原样成为键名 —— 前缀被当成名字的一部分,工具不做命名空间解析。也就是说,改掉前缀、或者让同一个前缀在不同位置指向不同 URI,转出来的 JSON 完全看不出区别。靠命名空间区分来源的跨系统交换(SOAP、多规范混用的订阅源),别指望这层语义在 JSON 里还留着。
编码方面,输出的 XML 声明固定写 encoding="UTF-8"。原文件如果是 GBK,把结果复制回去要按 UTF-8 保存,否则字节是 GBK、声明写 UTF-8,别的程序打开就乱码。
什么时候别用在线工具
- 看一眼结构、贴工单、确认字段落在哪一层:这类场景用工具更直接。页面写明基于浏览器原生 DOMParser 实现、所有解析与序列化均在浏览器本地完成,据此内容不会上传到服务器。
- 批量转换、进 CI、要固定映射规则:用命令或库,比如 Python 的
xmltodict,属性前缀、文本键名都能自己指定。关键是规则可复现,不会因为换了个页面就变一套键名。 - 要保留注释、CDATA、混合内容顺序:别转 JSON,JSON 没有这些概念。要么继续用 XML,要么在转换前把关键内容挪进普通元素并转义好实体。
- 含账号、密钥、内网地址的配置:先脱敏。在浏览器本地跑,不等于可以随手粘。
一句话总结:属性进 _attributes、文本进 _text、单节点不是数组、注释和 CDATA 一定丢、JSON 转 XML 只认第一个顶层键。看结构够用,接程序就换规则可控的解析库。
常见问题
XML 转 JSON 后属性变成 _attributes,这个前缀是哪来的?
是工具的约定,不是 XML 也不是 JSON 的标准。属性在 JSON 里没有对应结构,只能变成键值对,但又不能直接和子元素平铺——<user id="1"><id>2</id></user> 里属性和子元素同名就撞车了。所以工具把属性统一收进 _attributes 对象、正文文本收进 _text。换成别的解析库,这两个键名会不同(常见的是 @ 前缀),代码要跟着改。
为什么只有一个 item 时是对象,两个就变成数组?
XML 本身没有数组概念,解析器只能按同名标签出现的次数推断。实测 <list><item>a</item></list> 输出 "item": {"_text": "a"},而两个 item 输出的是数组。出现一次不敢当数组,因为绝大多数元素本来就是单例。消费端要先归一化:Node.js 用 [].concat(data.list.item ?? []),Python 用 isinstance 判断,否则遍历时会报错。
CDATA 里的内容转 JSON 后变成空对象,能救回来吗?
不能靠转换救。CDATA 段在浏览器 DOM 里是独立的节点类型,转换只处理元素节点和文本节点,所以 <name><![CDATA[a & b]]></name> 实测输出 "name": {},整段内容被跳过。要保留内容,只能把 CDATA 改写成普通文本并手动转义实体(& 写成 &、< 写成 <),或者干脆不转 JSON。
JSON 转 XML 后少了几个字段,是工具吃数据了吗?
是只取了第一个顶层键。XML 只能有一个根元素,工具用 JSON 的第一个顶层键当根,其余顶层键静默丢弃。实测 {"server":{…},"client":{"timeout":5}} 转出来只有 server,client 整段不见且没有提示。贴之前先确认只有一个顶层键,或者手动包一层 {"root": {…}}。
转出来的 XML 和原文不完全一样,是工具改坏了吗?
多数是格式上的正常差异:属性顺序、空白、注释、编码声明都可能变,XML 规范里属性顺序本身没有语义,注释也不会进 JSON。真正要注意的是四类内容丢失:注释、CDATA、混排文本的顺序与空格、纯空白节点。要逐字复原原始文件,别用 JSON 当中转,直接保留 XML。
报错里的 line 3 at column 13 是从 0 开始数的吗?
从 1 开始。实测 <root> 下 <b>2</root> 这种标签没闭合的输入,报错是 error on line 3 at column 13: Unexpected closing tag: root != b,指第 3 行第 13 列遇到结束标签 root,但当时打开的是 b。这句报错来自浏览器内置的 XML 解析器,是英文原文,前后还夹着两句样板文字,看中间那截就够。