Ping结果怎么读?多节点拨测先分清是网络还是服务器
只看平均延迟,我放过了一次抖动
有个站点用户说「时快时慢」,我 ping 了一轮,平均值不高,就回了句「延迟正常」。用户又发来一段录屏,卡顿很明显。
后来我把最快和最慢的数值摆在一起看,差距很大。问题不在平均,在波动。平均数把最差的那几秒藏起来了。
平均值的局限
平均值是中间水平,它不告诉你分布。
延迟稳定的线路,平均和最快最慢都很接近;抖动大的线路,平均值可能仍然好看,但用户体验是一阵一阵地卡。
举个直观的例子:两次请求,一次很快、一次卡住,平均下来可能仍然正常,但用户记住的是卡住那次。
所以看 ping 结果,第一件事是把平均值和最快、最慢放在一起。
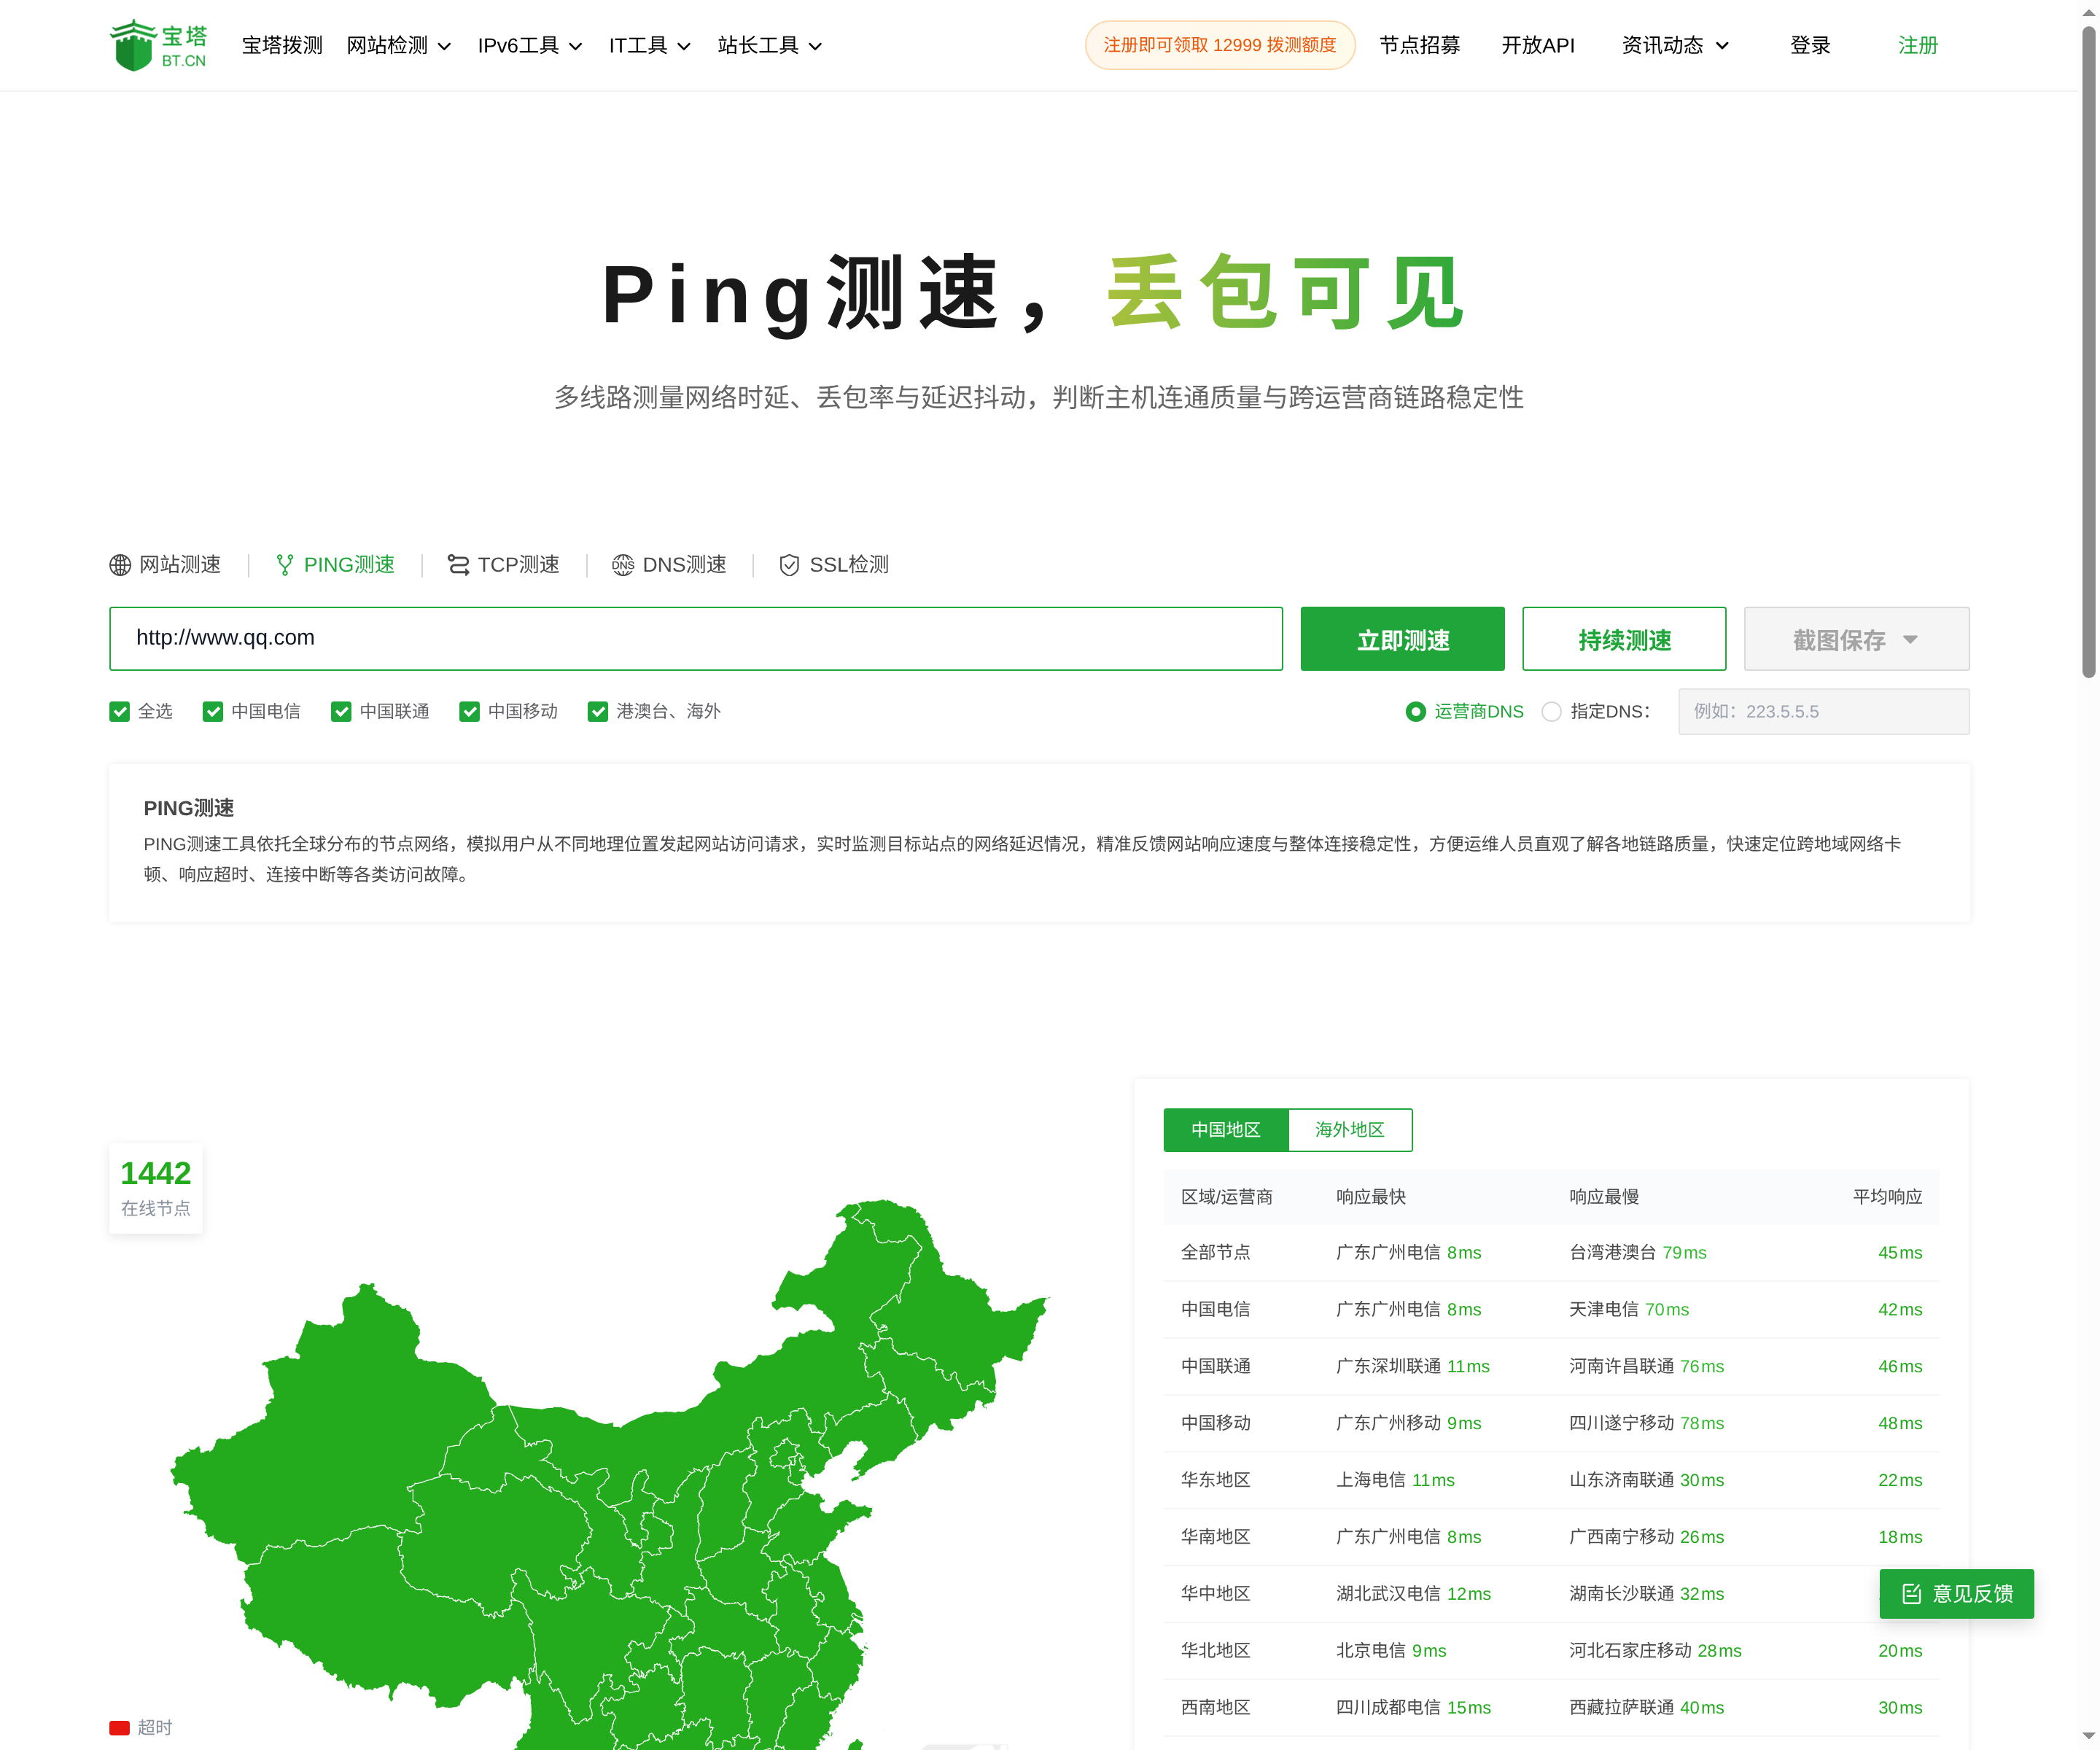
PING 测速:多节点延迟与丢包一览
差距代表抖动
最快和最慢差多少,直接反映链路稳不稳。
差距小,说明这条路线质量稳定;差距大,说明中间有排队、绕行,或者设备处理不过来。
用宝塔拨测的 PING 测速看结果时,最快和最慢会并排列出来,差距一眼可见。
抖动对交互式应用的影响比平均延迟更大。网页加载、SSH、游戏,都怕这种忽快忽慢。
未响应比例要小心解读
丢包率是最容易被误读的数字。
少量包丢一两个,百分比看起来很吓人,但可能只是瞬时拥塞。反过来,一些网络对 ICMP 限速甚至丢弃,ping 显示丢包,TCP 业务却完全正常。
判断方法:看丢包是否连续、是否集中在某个运营商,再用 TCP 探测交叉验证一次。
整片节点都丢包,更像是目标侧对 ICMP 做了限速;零散节点丢包,才更像链路问题。
三个数组合起来看
平均低、差距小、无丢包:链路健康,问题不在这里。
平均低、差距大、偶发丢包:典型抖动,查线路质量和拥塞。
平均高、差距小、无丢包:链路稳定但距离远,属于物理限制。
平均高、差距大、持续丢包:链路确实有问题,或者目标在限速。
这些组合只是起点,真正原因还要结合业务类型判断。平均高但差距小,跨省访问本来就是常态,不必过度优化,只有抖动才值得动线路。
多节点和复测
跑多地区多运营商节点,先看分组,再看每一组的这三个数。
只有一组异常,查那条互联;所有组都异常,查目标侧。
连测两三次,看结果是否稳定。固定节点、固定时间,结果才有可比性。单次只能当线索,稳定复现才值得动手。记录里带上时间和运营商。这些数字不是用来证明谁对,而是用来把排查范围一点点缩小。
