Ping延迟高或有丢失时怎样排查?多节点拨测先分清是网络还是服务器
延迟一高就想换机房
看到 ping 延迟上去,我最早的处置是换机房。折腾一圈,新机房照样高,因为问题本来就不在服务器。
Ping 的数字只说明路况,不说明谁该负责。所以排查的第一步不是改配置,是确认这个数字靠不靠谱。
先确认样本
几个包的结果很可能是偶然。先看测了多少次、持续了多久。只发四个包,丢一个就是四分之一,这个数字本身没有统计意义。
再看是不是同一时段。高峰期和凌晨的延迟本来就不一样,拿两个时段的数据对比,结论一定错。
目标也要确认。同一个域名在不同节点可能解析到不同 IP,你以为在测同一台机器,其实测了好几台。
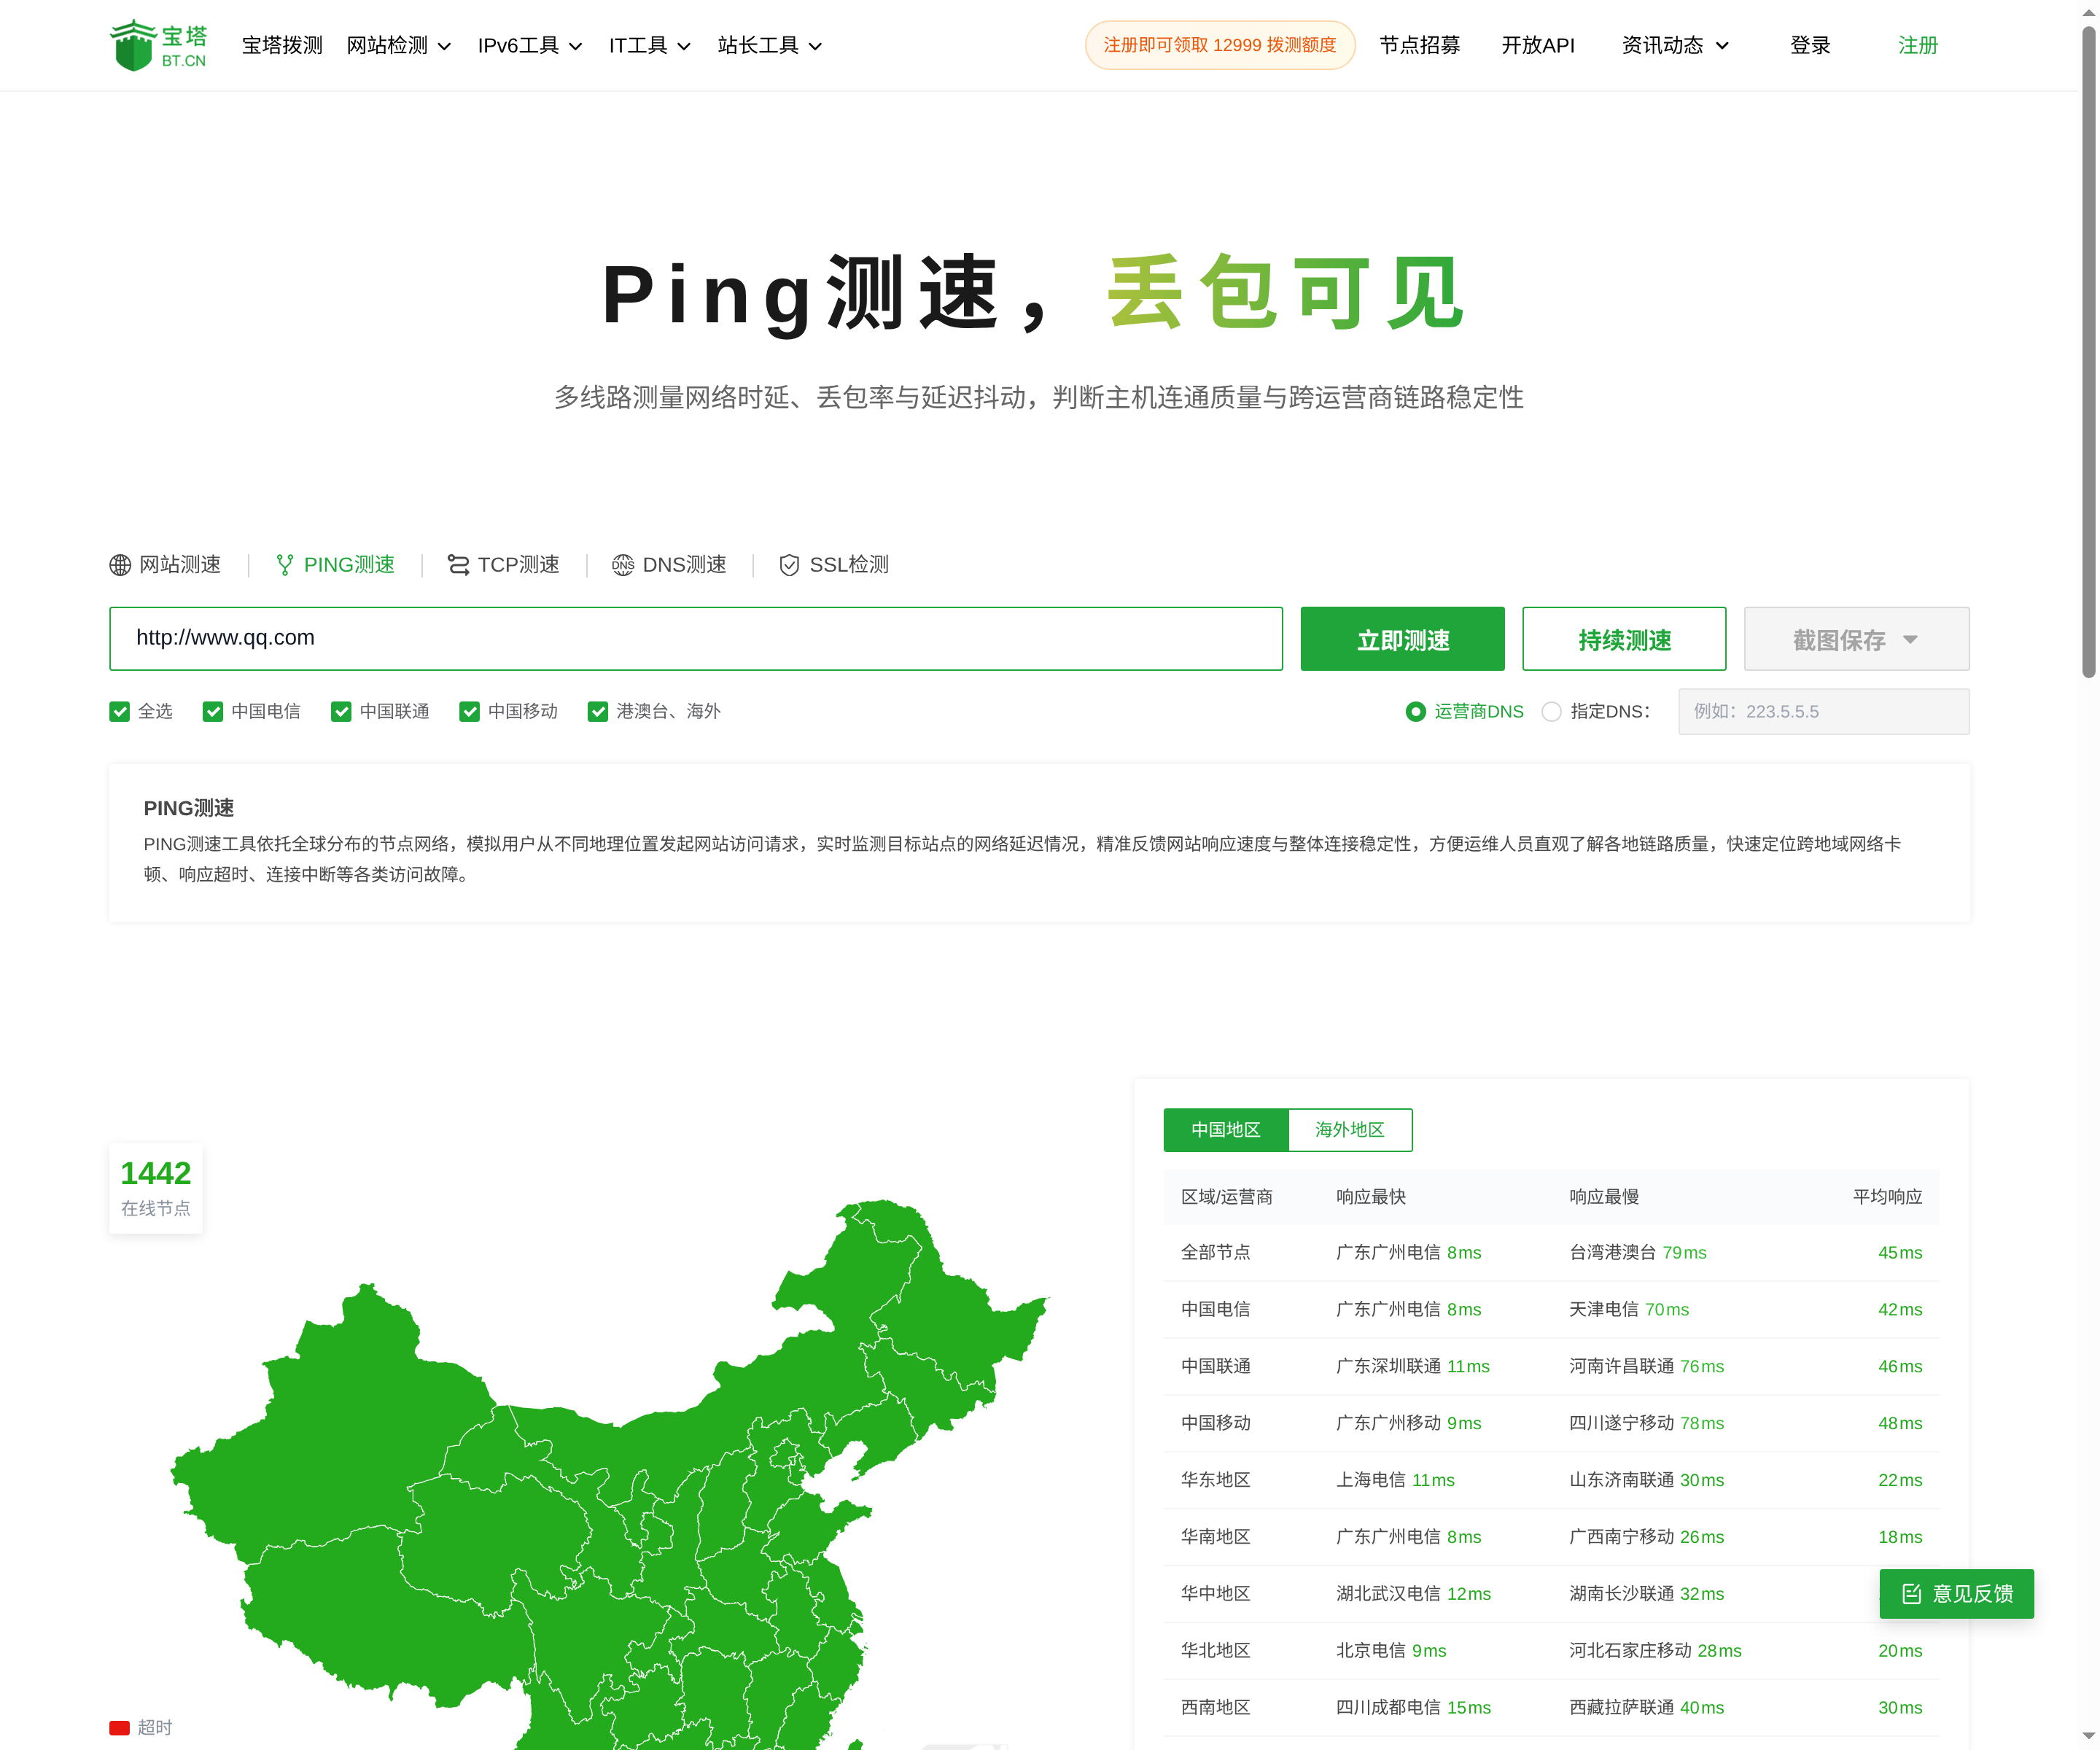
PING 测速:多节点延迟与丢包一览
找范围,比找原因重要
用宝塔拨测的 PING 测速跑多地区多运营商节点,先看哪些组异常。
只有一家运营商高,偏互联和那家的接入;只有某个地区高,偏区域路由;全国都高,才轮到机房出口和目标侧;海外高、国内正常,多半是跨境链路。
某一家运营商的所有节点都高、另一家全正常,基本可以把问题锁在那条互联上。
范围确定了,责任方基本也就确定了。这一步做对,后面能少走很多弯路。
再分方向
如果是单个地区高,可以看延迟是「一路高」还是「到了末端才高」。
本地入口就高,问题在自己这一侧的网络;中途正常、接近目标才高,偏目标的接入或者对端限速。延迟高但抖动很小,通常是路径长;延迟高且抖动大,通常是拥塞。
丢包也一样:全程零星丢,链路质量;靠近目标集中丢,目标侧策略或容量。路由追踪能帮忙看每一跳,但要结合时间点看。
目标限速和 ICMP 降级
有些服务器或防护设备对 ICMP 限速,ping 显示高延迟和丢包,但 TCP 业务完全正常。
判断方法:用 TCP 探测同一目标同一端口,对比结果。TCP 正常,就别再追着 ping 调网络了。不少云厂商的防护默认会限制 ICMP 频率,这不代表业务有问题。
这一条能省掉很多无效工作。
记录和复测
连测三次,记下时间、节点、运营商、延迟和丢包。稳定复现的结论,才能拿去和运营商或者机房沟通。沟通时给出具体节点和数值,比说「很慢」有效得多。
改完之后用同一批节点复测,看同一组的数据有没有回落。复测时固定节点,否则数据不可比。这一套走完,多数高延迟都能定位到某一段。
排查高延迟,靠的是范围,不是猜。范围对了,方向自然就对了。
