HTML 实体怎样编码和解码?页面显示与源码有什么区别?
文章里想展示一段 <p> 代码,发布后却只剩文字;或者源码中满是 <、&,不知道该不该还原。这两类情况都要先分清:你需要的是浏览器显示出来的文字,还是准备交给 HTML 解析的源码。
宝塔拨测的“HTML 实体编码 / 解码”工具可以转换常见特殊字符。它的结果区是文本框,适合核对原始字符串,不会把解码后的标签直接渲染成网页。
把代码片段变成实体
打开工具,选择“HTML 编码”,粘贴以下公开示例:
<p title="演示">宝塔 & 文档'示例</p>
输入后,转换结果会自动更新。本次得到:
<p title="演示">宝塔 & 文档'示例</p>
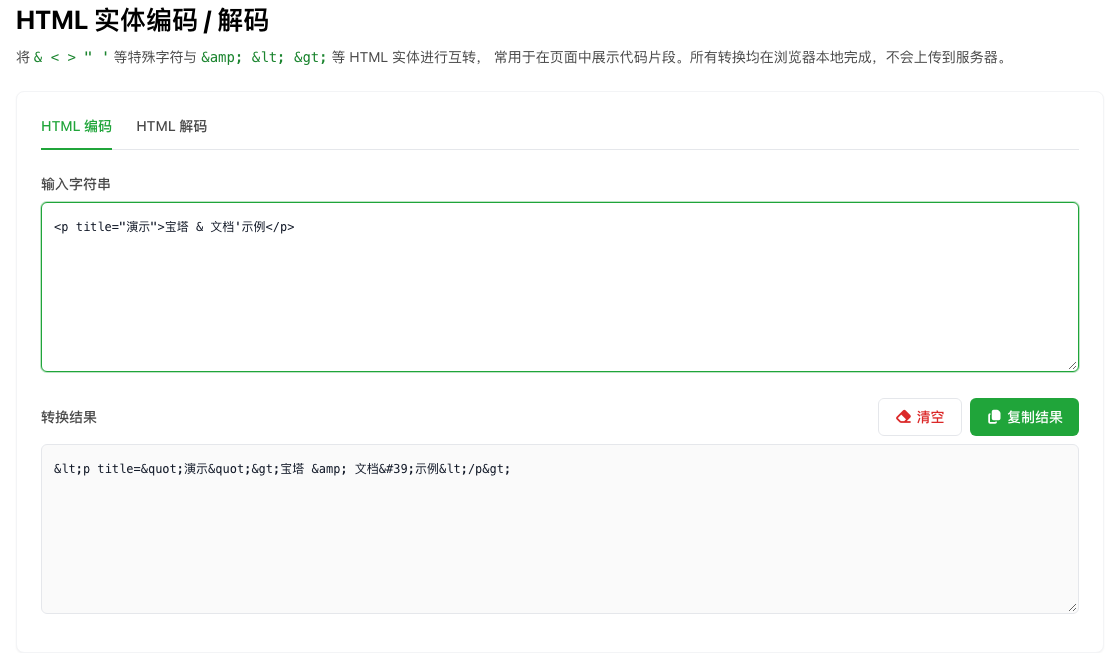
对照这段结果,< 变成 <,> 变成 >,双引号变成 ",与号变成 &,单引号变成 '。这次中文没有变成一串数字,说明该操作关注的是这些特殊字符,并非把所有文字都做数值编码。
点击“复制结果”可以取走编码后的文本。准备放进普通 HTML 文本位置展示代码时,实体让尖括号作为文字出现,不再被当成开始标签和结束标签。比如源码写 <p>,页面文本位置显示的就是 <p>。
如果使用的是带“代码块”按钮的编辑器,可以先让编辑器处理展示,再查看发布预览。某些编辑器会自动转义,先手工编码后又被编辑器处理,反而可能多出一层实体。要不要先转换,应看最终插入位置与编辑器的处理方式。
解码后为什么还能看到标签
切换到“HTML 解码”,把上一步的完整结果粘贴进去。下方会还原为最初的字符串,包括标签、中文、与号和引号。
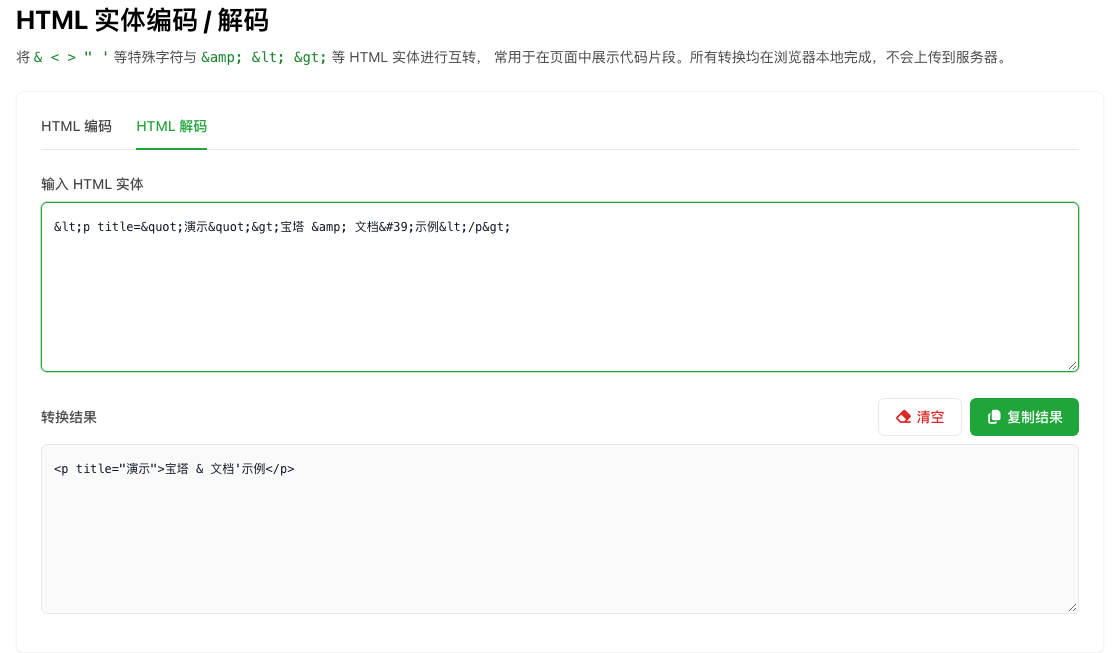
这里看到 <p title="演示"> 是正常的。解码工具给出的是源码文本,并不会把 title 变成鼠标提示,也不会把标签对应的内容展示成一段已经排版好的文章。
复制结果前,先确定下一步打算放在哪里。想检查模板或接口里的原文,可以看解码文本;想在教程中展示代码,需要保留可见的标签;想让网页真正产生段落,则涉及目标页面对 HTML 的解析。仅仅点击“解码”,不会替你完成后面的编辑器插入或页面发布。
多出一层 amp,先只还原一层
拿到这样的内容时,不要直接把所有 & 批量删除:
&lt;p&gt;演示&lt;/p&gt;
把它放进“HTML 解码”,本次结果为:
<p>演示</p>
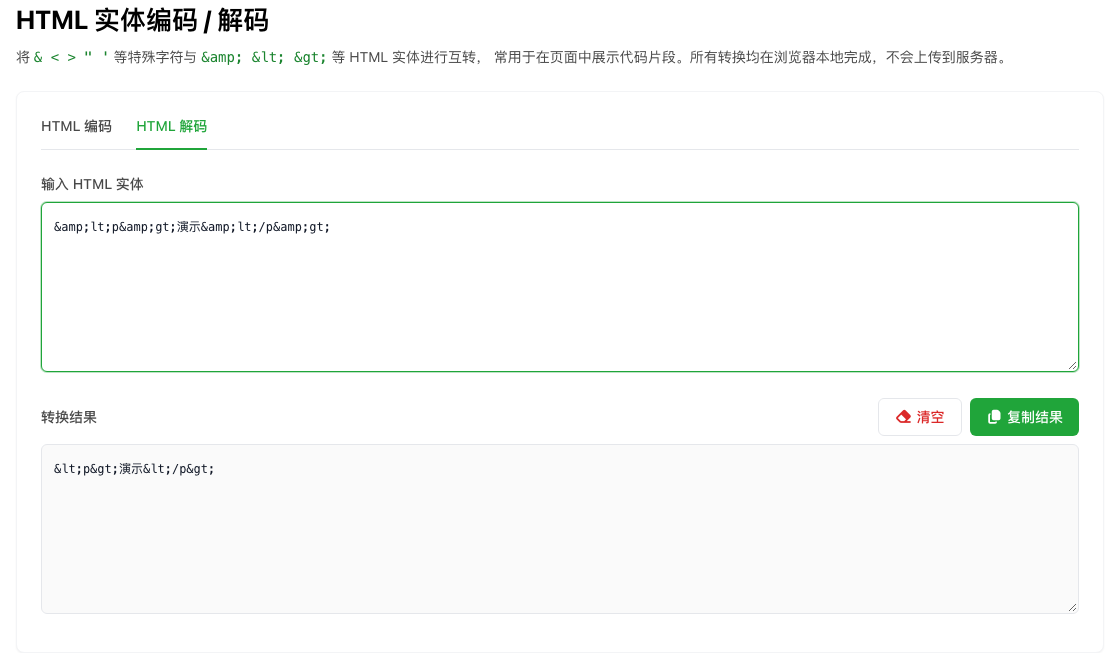
这表明一次操作只还原了一层:原先表示 & 的 & 被解开,露出了里面的 < 和 >。如果目标确实是恢复 <p>演示</p>,可以把这一轮结果再放回解码输入框处理;如果目标是让别人看到 < 这种写法,这一层反而可能正是需要保留的内容。
“解到看不见实体为止”并不是固定规则。先保留原始文本,再按目标显示效果逐层核对,能避免把本来要展示的字符变成实际标签。发现编码不对时,也要回到输入来源检查:是接口已经转义、模板又转义一次,还是编辑器在粘贴时处理了一遍。
复制长片段后,最后看一次输入和输出是否齐全,特别是两端的标签、引号和分号。工具完成的是字符串转换;最终页面的显示效果仍要到实际使用的预览里确认。
