Unicode 转换怎么用?中文实体、反斜杠写法与表情符号怎样区分?
中、中 和 \u4E2D 都可能用来表示“中”,但它们属于不同的写法,不能看到 Unicode 就直接放进同一个解码框。
宝塔拨测的“文本 / Unicode 互转”工具当前使用 &#数字; 形式。普通中文可以转换和还原;遇到表情符号,还要注意它按 UTF-16 码元处理的边界。下面分别用中文和一个 emoji 操作,避免把工具能往返的结果误当成所有场景都通用的实体。
中文怎样转成十进制形式
打开工具,选择“文本转 Unicode”,输入:
宝塔A
下方自动生成:
宝塔A
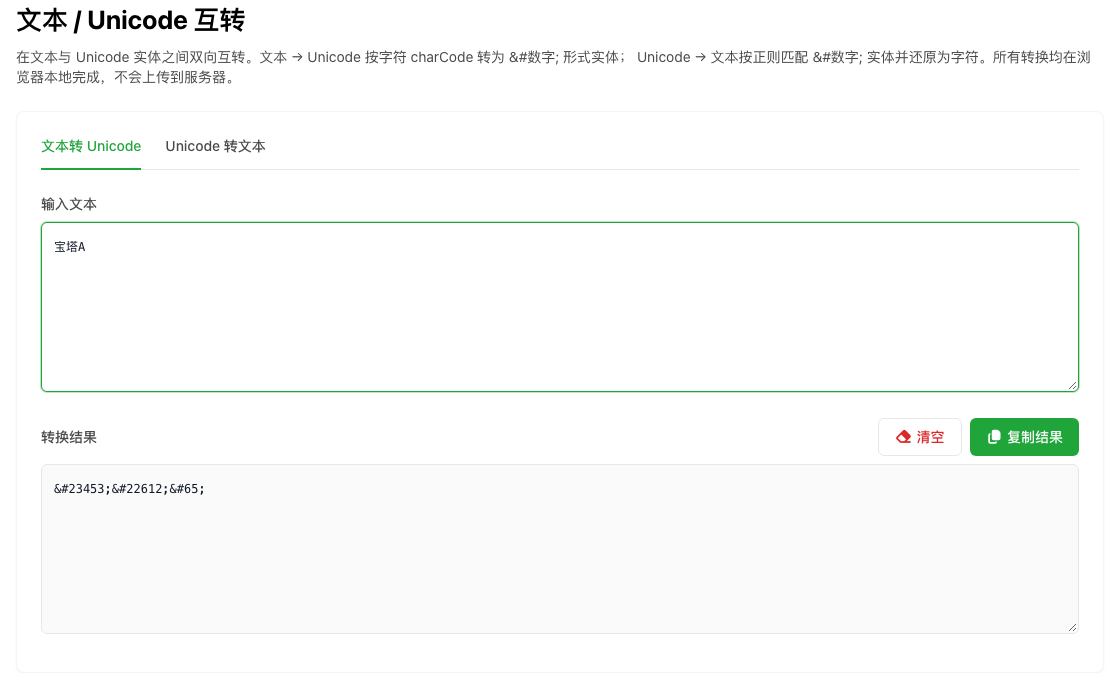
结果中每段都以 &# 开头、以分号结束,中间是十进制数字。这里的字母 A 也变成了 A,并不是只转换中文。需要使用结果时,点击“复制结果”,保留完整的前缀和分号,不要只摘出数字。
反向转换时,切换“Unicode 转文本”,把完整结果放到输入框。工具会在下方还原文本;要处理另一段内容,可以替换输入,或使用“清空”。本工具的转换在输入后更新,不需要另点一次转换按钮。
一个 emoji 为什么对应两段数字
把正向输入改为:
中文😀
本次结果为:
中文��
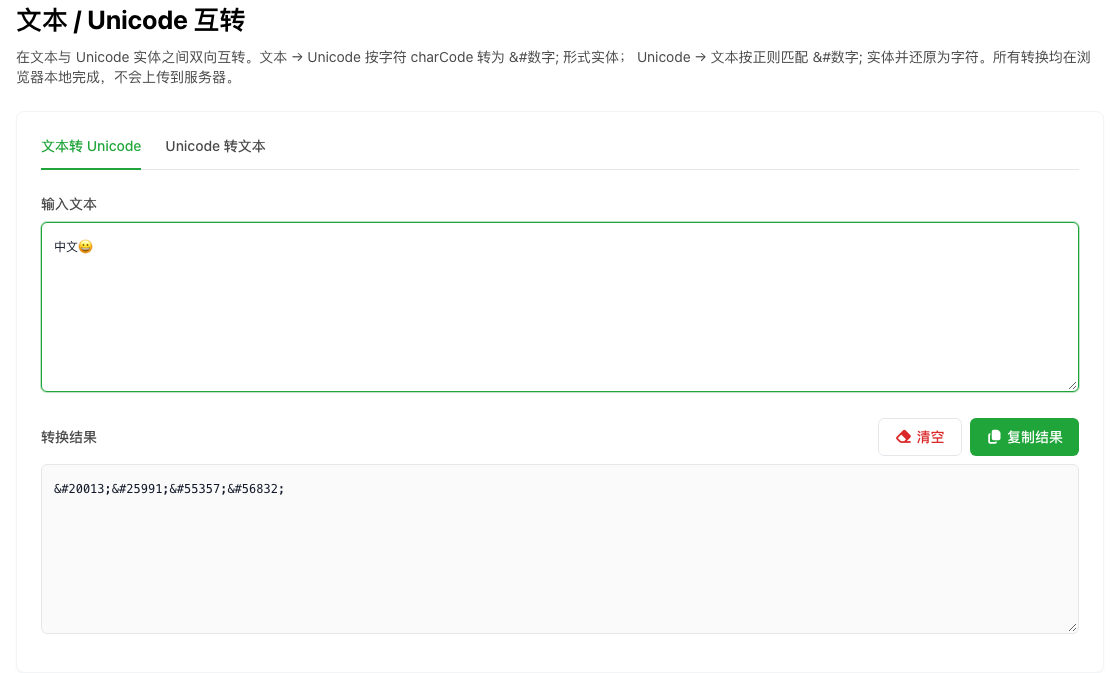
前两段分别对应“中”和“文”;后两段共同对应这个表情。原因在于工具说明采用字符的 charCode,实际结果也与 UTF-16 码元一致:这个表情在 UTF-16 中由一对代理码元表示,十进制值分别是 55357 和 56832。它的完整 Unicode 码点则是 U+1F600,十进制为 128512,两者不是同一层级的数字。
切到“Unicode 转文本”,把上面四段结果完整粘贴进去,本次能够还原为 中文😀。
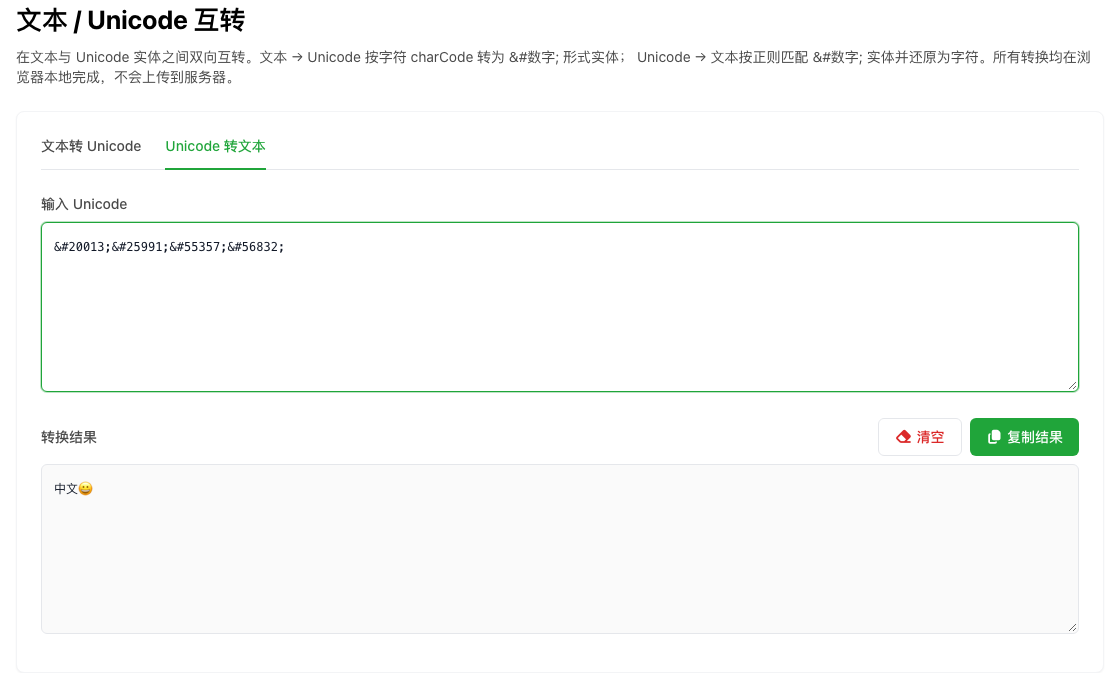
这说明本次样例可以在本工具中往返。使用时不要把代理对拆开、漏掉其中一段或交换顺序。但这并不表示 �� 可以当成通用 HTML 表情实体;HTML 数字字符引用按码点解释,代理码元引用会被当作错误处理。按标准 HTML 解析,这两段会得到替换字符,而标准码点引用 😀 才表示这个表情。
因此,需要把内容放进真实网页时,不要仅凭本工具能还原就直接采用这种 emoji 输出。应使用符合目标格式的表示,并在实际页面里检查显示结果。
完整码点、十六进制和反斜杠写法的实测
在“Unicode 转文本”输入下面这组对照:
😀 | 😀 | \u4E2D
本次结果中,第一项没有得到 😀,而是得到 U+F600 字符,界面可能显示为方框;后面的 😀 和 \u4E2D 都原样保留。
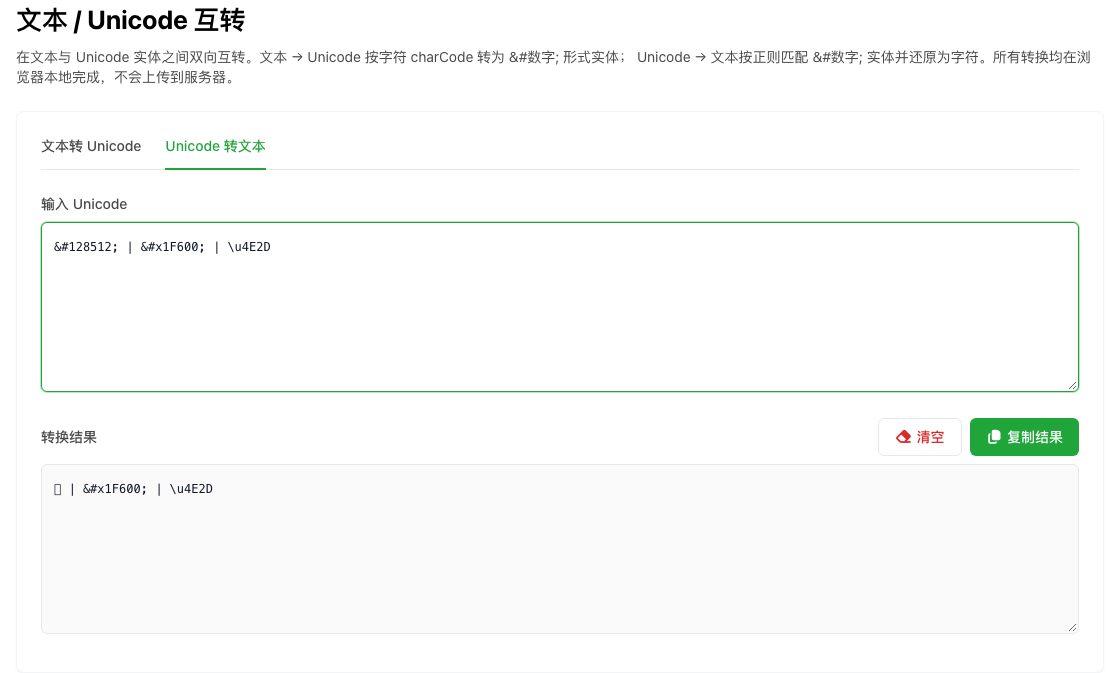
这组结果给出了当前可执行的边界:工具并不是通用 Unicode 转义解析器,不能用它来解码任意 JSON 或 JavaScript 的 \u 转义;它也没有在这次操作中识别十六进制实体。即便输入符合 &#数字; 的外形,超出单个 UTF-16 码元范围的完整码点也不能据此判断已经正确还原。
处理中文十进制结果时,可以用原文和反向结果直接对照;处理 emoji 或生僻字时,应额外检查目标格式使用完整码点还是 UTF-16 代理对。两者写法不同,不能靠手工把数字前缀换一下就认定转换完成。
如果数据来自 JSON,先按 JSON 格式解析;来自 HTML,就按 HTML 字符引用规则处理。本工具适合本篇已经验证的十进制码元转换,遇到其他写法应保留原始内容,换用对应格式的处理方式,再核对最终文字。
