文本 MD5 和 SHA-256 怎么计算?中文、换行与输出编码怎么核对
同样四个中文字,两个地方算出来的哈希却不同,先别急着判断算法有问题。字符编码、末尾换行、空格,以及结果用 Hex 还是 Base64 展示,都会影响比较方式。
宝塔拨测的「MD5 / 哈希加密」页面可以一次显示多种文本摘要。下面用公开文字做测试,重点核对 MD5 与 SHA-256,不输入密码、密钥或真实业务内容。
输入中文,先对照两行常用结果
进入「加密工具 → MD5/哈希加密」,在文本框输入 宝塔拨测,末尾不要按回车。输出编码保持 Hexadecimal (base 16),结果会自动刷新。
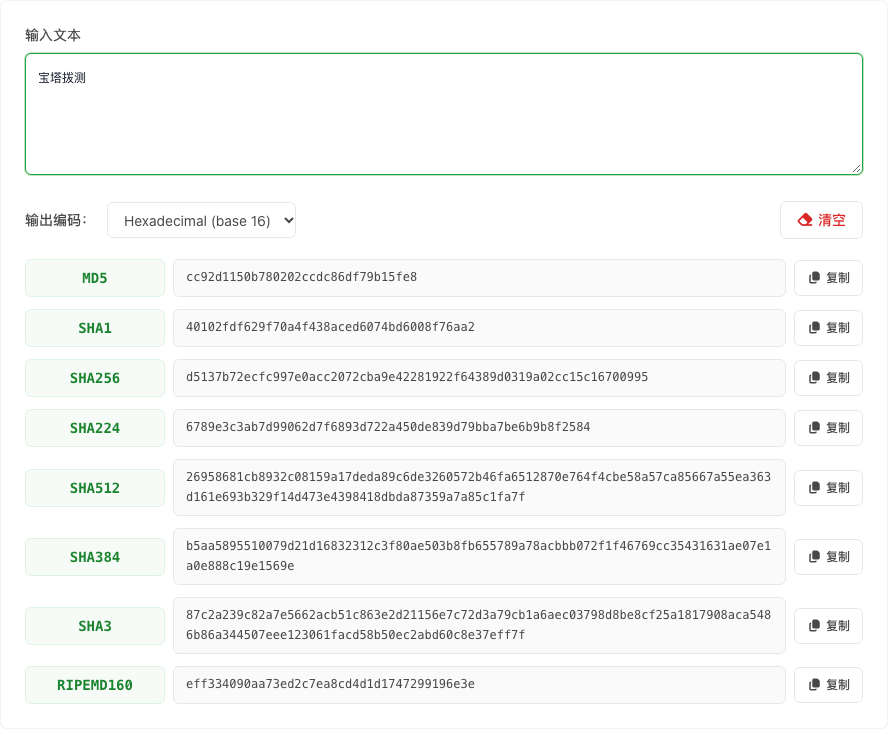
本次 MD5 为:
cc92d1150b780202ccdc86df79b15fe8
SHA-256 为:
d5137b72ecfc997e0acc2072cba9e42281922f64389d0319a02cc15c16700995
使用 UTF-8 编码独立计算后,这两项与页面一致。MD5 的 Hex 结果为 32 个十六进制字符,SHA-256 为 64 个;字符数量不同,不表示哪个结果少算了一部分,它们本来就有不同的摘要长度。
当前页面还显示 SHA1、SHA224、SHA512、SHA384、SHA3、RIPEMD160,共八行结果。本次各行均生成了文本。选择算法时仍要核对接口要求的完整名称和位数:尤其是页面的「SHA3」行,本次用 abc 对照,结果与独立计算的标准 SHA3-512 不一致。若对接要求标准 SHA3,先确认具体变体与测试值,不能只凭这一行标签直接使用。
末尾多一个换行,输入字节就已经不同
在同样的四个字后按一次回车,使输入末尾增加一个换行。本次页面 MD5 变为:
c1143f1df11ae2bca0c874ab907f9d0e
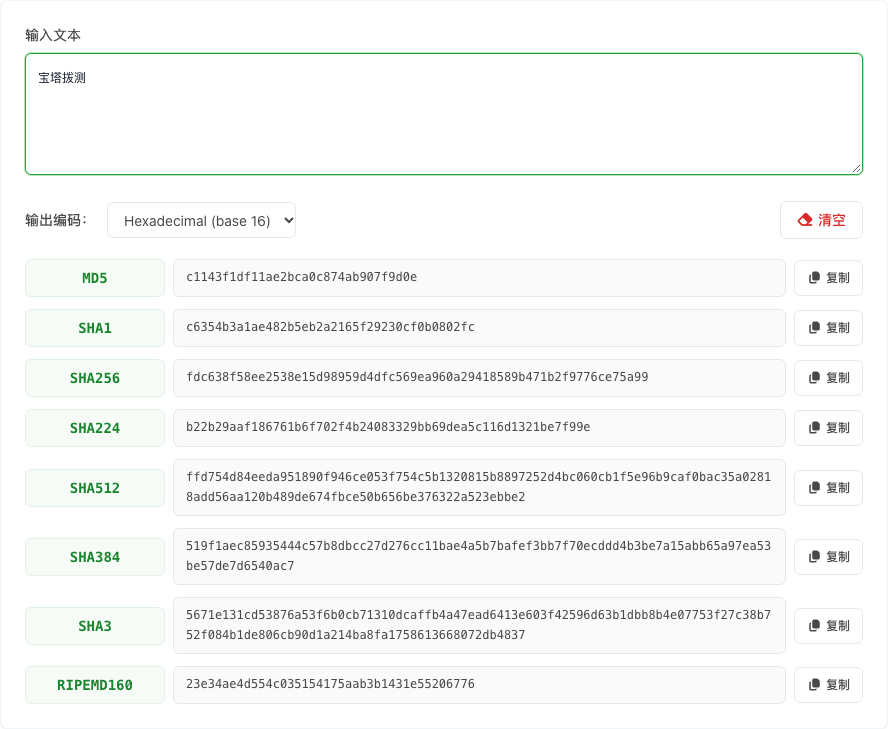
这次换行是 LF,UTF-8 字节值为 0a。原来的四个中文字符共 12 字节,加上换行后变为 13 字节。独立按这 13 个字节计算,结果与页面一致,所以这里的变化有明确的输入差异,并不是页面随机生成。
如果想在本地复核,可以用 Python 明确指定 UTF-8,并分别计算两个字符串:
import hashlib

for text in ["宝塔拨测", "宝塔拨测\n"]:
    data = text.encode("utf-8")
    print(len(data), hashlib.md5(data).hexdigest())
本次对应输出为:
12 cc92d1150b780202ccdc86df79b15fe8
13 c1143f1df11ae2bca0c874ab907f9d0e
排查自己的文本时,先检查末尾回车、前后空格和不可见字符,再确认双方字符编码。还要区分 LF 与 CRLF:它们是不同字节,不能仅靠屏幕上“都换了一行”判断相同。复制自编辑器、终端或网页的文本,要以实际参与计算的字节为准,不要为了让结果相同就随意删减内容。
切换 Base64,只改变摘要的展示形式
删除末尾换行,恢复输入 宝塔拨测,把输出编码改为 Base64 (base 64)。本次 MD5 行显示:
zJLRFQt4AgLM3IbfebFf6A==
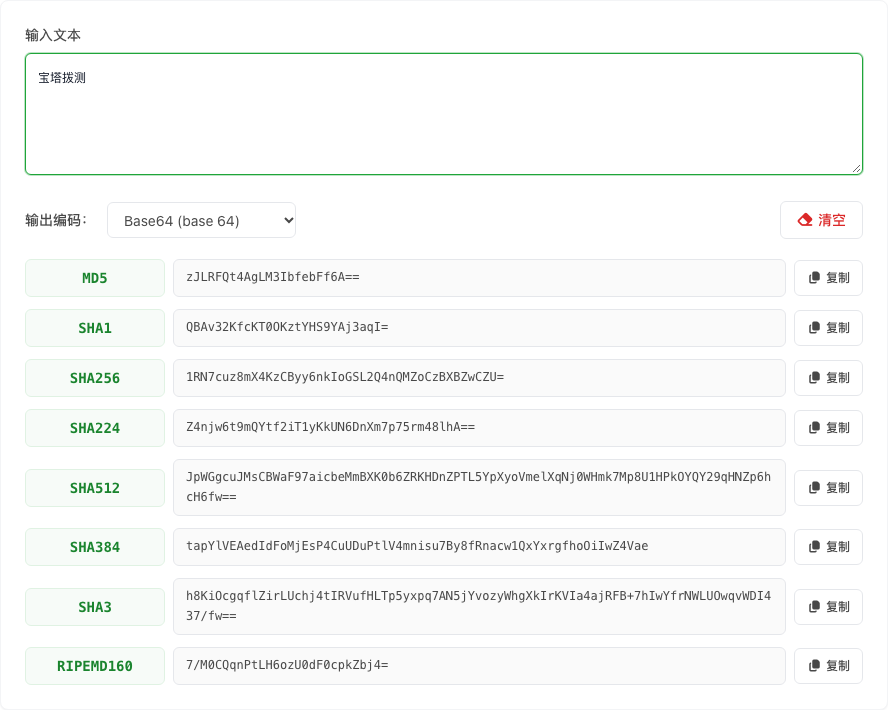
这不是又对文本做了一次“MD5 加密”,而是把同一份 MD5 摘要字节换一种编码展示。把上面的 Base64 解码成字节后,转回 Hex,仍是最初的 cc92...5fe8。
页面还提供 Base64url 和 Binary。本次用 abc 切换这两种选项,也得到了对应结果。实际交给程序前,确认对方要的是 Hex 字符串、Base64 字符串还是原始字节;不要把两种编码直接按文字比较。Base64url 的字符替换与填充处理也应跟接口约定一致。
哈希能帮助比较内容,不能单独证明来源
页面名称里虽然带“加密”,这里得到的是摘要,不是带解密操作的密文。无法通过本工具把 MD5 结果还原成原文,也不能把一个哈希值当成隐藏敏感文本的可靠办法。
如果需要检查两份文本是否与某个预期内容一致,应先固定算法、编码和输入字节,再比较摘要。当前入口处理的是文本;把文件里的可见文字粘进来,不能替代对原始文件全部字节进行校验,文件里的换行、编码标记和其他字节也可能不同。
MD5 已不适合需要抗碰撞性的安全用途。即使用 SHA-256,单独一个校验和也不能证明“文件一定来自官方”:如果内容和校验和都由同一处不可信来源提供,两者仍可能一起被替换。验证来源需要可信渠道提供的摘要,或相应的签名、消息认证机制,不能只凭页面出现了一串哈希就给出来源认证结论。
