文本与二进制互转怎么用:先分清 ASCII、中文和 UTF-8 字节
把 Hi! 转成一串 0 和 1,再转回来,适合检查简单文本的二进制表示。但遇到中文或 emoji,不能只看工具里出现了结果,就把它当成 UTF-8 字节。当前文本/二进制互转工具的两个方向存在一处需要提前了解的边界:编码会输出超过 8 位的分组,解码却要求每组恰好 8 位。
下面用三段公开测试内容说明具体操作。演示不涉及文件上传,也不需要准备真实业务数据。
先用短英文完成一次往返
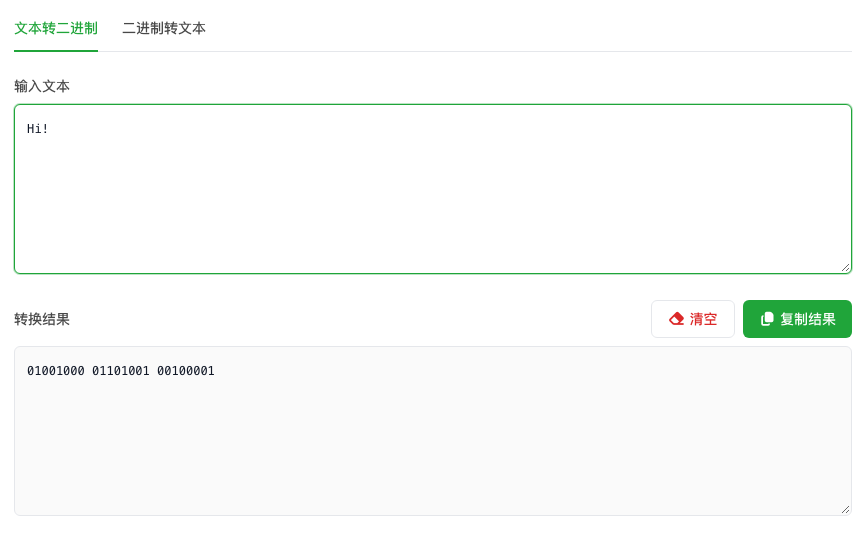
在 IT 工具的编码转换分类中打开“文本/二进制互转”,保留“文本转二进制”标签,在“输入文本”中填写:
Hi!
输入后结果自动更新,无须另点转换按钮。当前得到:
01001000 01101001 00100001
三个分组分别对应 H、i 和感叹号。每组 8 位,分组之间有空格;复制时保留这些分隔符,比较容易逐字核对。输入框里的空格也是正文的一部分,不要为排版随手加进演示文本。
点击“二进制转文本”,把上面的完整结果粘贴到输入框,输出恢复为 Hi!。这一步验证的是这组三字符样例可以在工具中往返,并不代表任意编码的文本都能按同样方式还原。
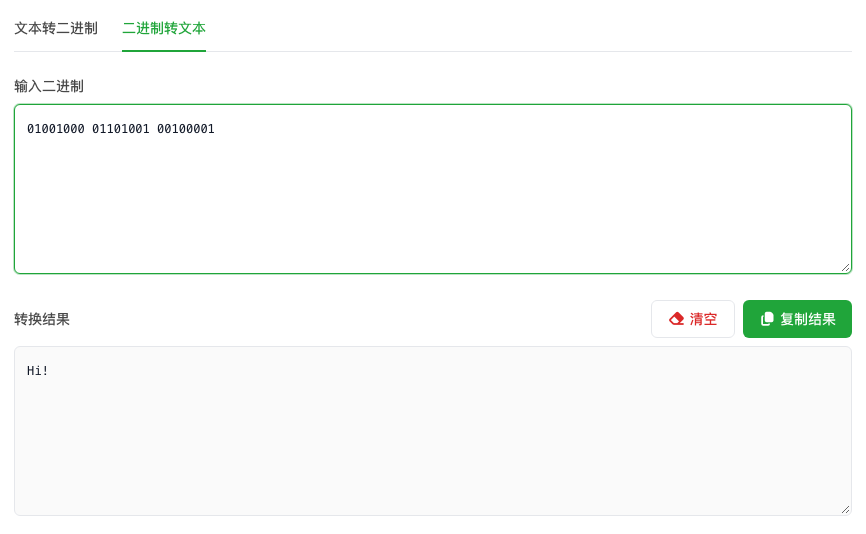
需要保存时,点击当前标签中的“复制结果”。“清空”用于重新开始本方向的测试;切换标签前,先把需要的结果保存到自己的测试记录中,避免把两个方向的输入混在一起。
中文为什么不是三个 UTF-8 字节
回到“文本转二进制”,输入:
A中😀
当前工具输出:
01000001 100111000101101 1101100000111101 1101111000000000
可以直接发现,只有第一组是 8 位,“中”对应的分组是 15 位,emoji 又占了两个 16 位分组。因此,这份结果不能标注为“每个空格分隔一个 UTF-8 字节”。
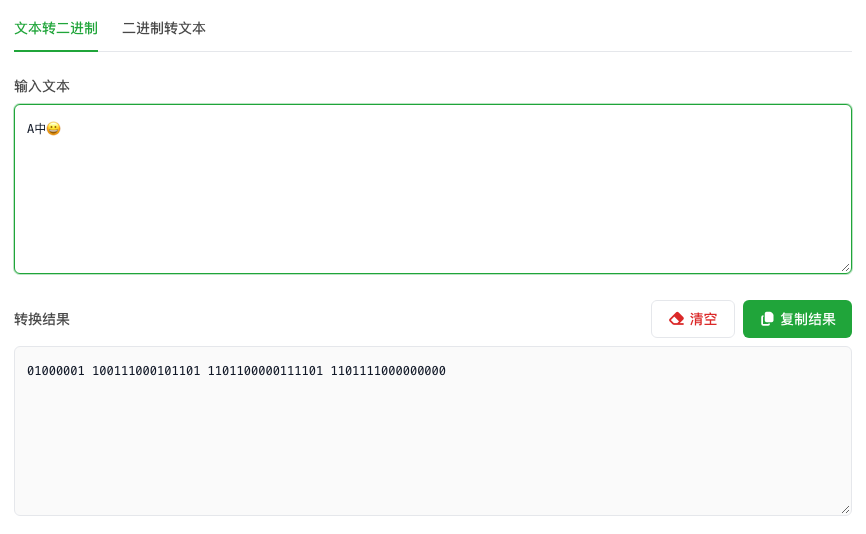
JavaScript 的 charCodeAt 取得的是 UTF-16 代码单元。A 的数值较小,补足到 8 位后刚好符合 ASCII 的常见展示方式;“中”的数值需要更多位;这个 emoji 则由一对代理代码单元组成。当前结果与这种代码单元表示相符。这里的“字符”不能简单理解为屏幕上看到的一个图形,也不能等同于网络传输时的一个字节。
如果你的任务是对照抓包、生成协议报文,或者复现按 UTF-8 字节计算的摘要,需要使用明确支持 UTF-8 字节编码的流程。不要把本页的中文结果直接贴进要求八位字节序列的接口。
编码有结果,不代表解码支持同一份结果
把 A中😀 产生的完整二进制输出原样复制到“二进制转文本”中,本次出现提示:
无效的二进制字符串:必须是 8 位分组的二进制
结果框没有还原文本。提示与输入中存在 15 位、16 位分组相符;这不是复制时漏掉一位造成的,本例回填的就是前一步完整输出。
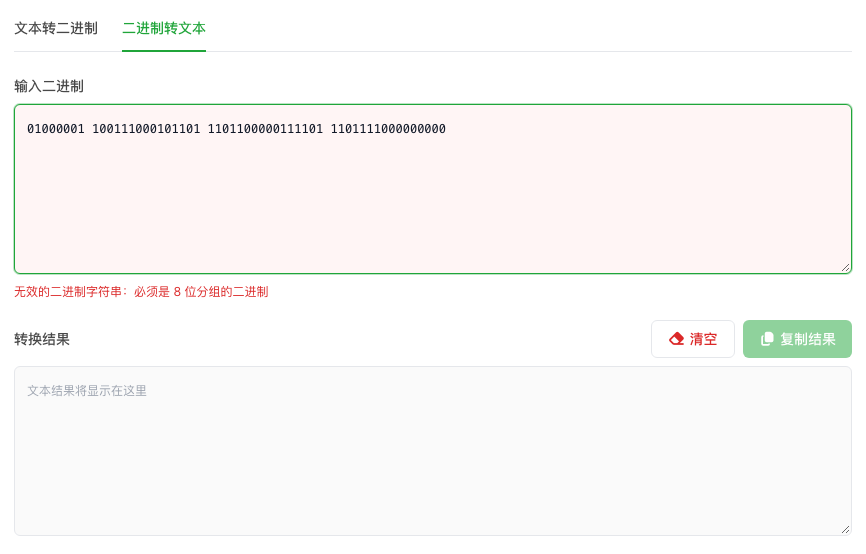
不要为了通过校验,把长分组随意截成 8 位,或者删掉高位。这样会改变原始数值,即使出现了可见字符,也不能据此认定还原正确。把 UTF-8 字节逐组送进一个只按单字节字符还原的流程,也需要另行确认编码解释,不能只凭“没有报错”判断。
当前页面适合先用 ASCII 范围的短文本做表示与往返检查。涉及中文、emoji 或其他非 ASCII 内容时,保留原文,明确记录需要的是 UTF-16 代码单元还是 UTF-8 字节,再选择对应工具。检查转换是否可靠,除了看是否有输出,还要把输出回填,并逐字比对原文。
