JSON 格式化后长整数尾数变了:订单号和 ID 怎样避免精度丢失
收到接口数据时,订单号是 9007199254740993,点一次格式化却变成 9007199254740992,这不是缩进变化。当前 JSON 工具会在格式化过程中处理数值,超过安全整数范围的某些数字可能失去精度,即使页面显示格式正确,也需要另外核对原始值。
下面用虚构 ID 做一个最小对照,分清原文、数值和字符串,再决定能不能把格式化结果继续用于联调。
保留原文,再点格式化
打开“JSON格式化”,先把这段完整文本保存为一份测试原文,再粘贴到编辑器:
{"safe":9007199254740991,"id":9007199254740993,"idText":"9007199254740993"}
其中 safe 是安全整数边界上的数值,id 是待检查的长整数,idText 则用双引号保存相同数字文本。三个字段放在一起,是为了让变化可以直接对照,不涉及真实订单。
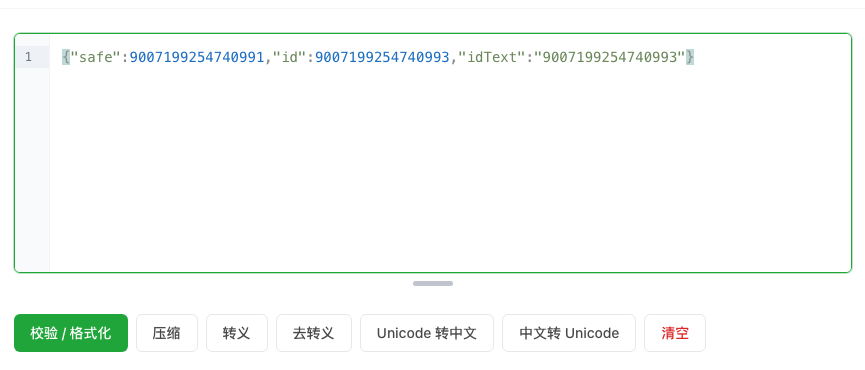
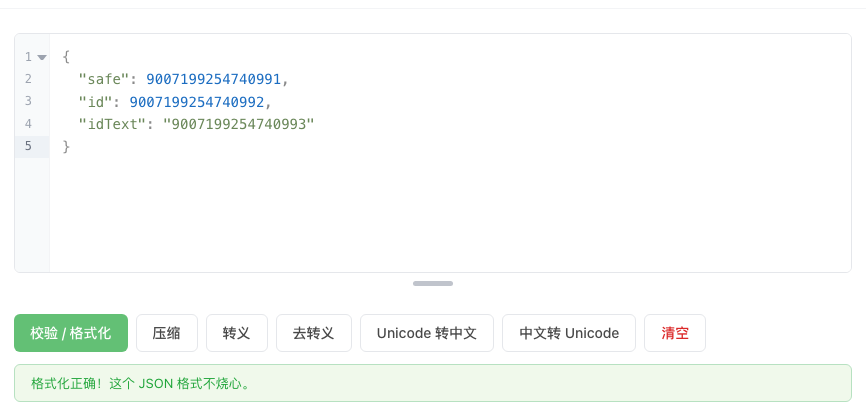
先看清原始文本,再点击“校验 / 格式化”。本次页面显示格式化成功,同时编辑器中的数值字段变为:
{
  "safe": 9007199254740991,
  "id": 9007199254740992,
  "idText": "9007199254740993"
}
safe 保持不变,数值 id 的尾数从 993 变成 992,字符串 idText 则仍是原来的数字文本。绿色成功提示说明这次格式化操作完成,不代表每个业务字段都与输入逐字相同。
为什么同一串数字,加引号就不一样
JavaScript 的普通 Number 使用双精度浮点数,最大安全整数是 2^53-1,也就是 9007199254740991。超过这个范围,并非每个整数都能被精确区分。本例中的 9007199254740993 转换成普通 Number 后出现了舍入。
这不等于 JSON 语法规定“大于这个数字一律错误”,也不等于所有超过边界的数字都会立刻改变。问题在于接收和处理数值的实现具有什么精度。某个后端能精确处理长整数,不代表经过浏览器普通数值处理后仍能保持原值。
加上双引号后,值的类型变成字符串,工具处理的是这些字符本身。本次结果保留了数字文本,但这也改变了接口的数据类型,不能只在一端随手加引号就认定完成修复。发送端、接收端与校验规则需要共同约定。
ID 用字符串,需要从原始值开始
如果字段只是订单号、记录 ID 等标识符,不参与普通加减运算,可以与接口方约定以字符串传递。回到保存的原始文本,把该字段改成:
{"id":"9007199254740993","count":3}
重新粘贴后点击“校验 / 格式化”,本次 id 完整保留,普通计数字段 count 仍然是数值 3。
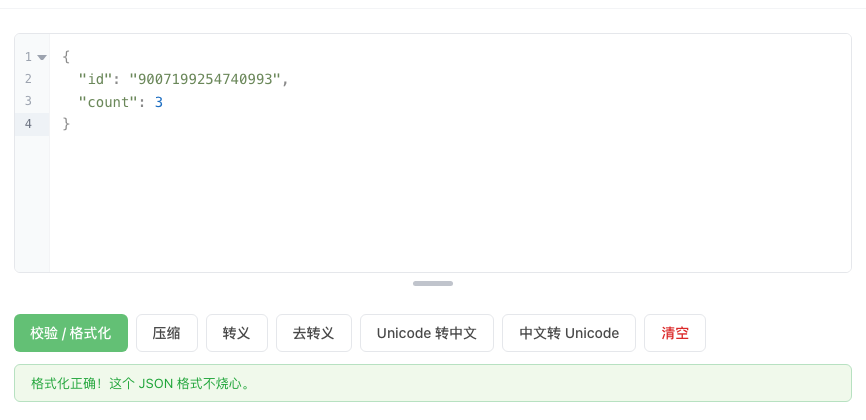
重点是“从原始值开始”。如果已经得到舍入后的 9007199254740992,再给它加双引号,只会把错误数字保存成字符串,不能恢复丢掉的信息。先找回接口原始响应、导出原件或上游记录,再进行类型调整。
如果字段确实需要高精度计算,应在业务代码中采用双方约定的整数或高精度处理方式,并明确序列化规则。当前工具没有提供“大整数无损模式”的选项,本篇也不把它作为高精度运算验证器。
格式检查与数据保真分开验收
处理长整数时,建议保留两份记录:一份是未加工原文,另一份是为阅读生成的格式化文本。核对时优先搜索 ID 字段,对比完整值和类型,尤其不要只比较前面几位数字。
不要把经过本页处理的结果直接覆盖唯一原件,也不要因为缩进整齐、提示成功,就认定数据可直接回传。如果这份文本还要用于签名、账务或其他要求字节与数值准确的流程,应先在相应程序里完成保真检查,再使用已经确认过的产物。
