正则匹配位置遇到 emoji 为什么多一位:读懂 UTF-16 偏移
同样匹配 OK,前面插入一个 emoji,起始位置却增加了 2。正则测试工具的位置详情使用 JavaScript 字符串的索引方式,不能直接当成屏幕上看见的字符数量,也不能当成 UTF-8 文件的字节位置。
本篇只检查一个问题:匹配结果正确时,为什么位置数字与肉眼计数不一致。测试文本均为公开构造,不涉及真实日志。
先记录没有 emoji 的位置
打开“正则测试”,表达式输入 OK,不填写两侧斜杠。只开启 g,关闭 i、m、s,测试文本填写:
AOK 中OK
页面显示 2 个匹配,位置分别是 @1–3 与 @5–7。位置从 0 开始,结束数字指向匹配后的位置,不把该位置的内容包含在内。因此 @1–3 表示从索引 1 开始,覆盖长度为 2 的 OK。
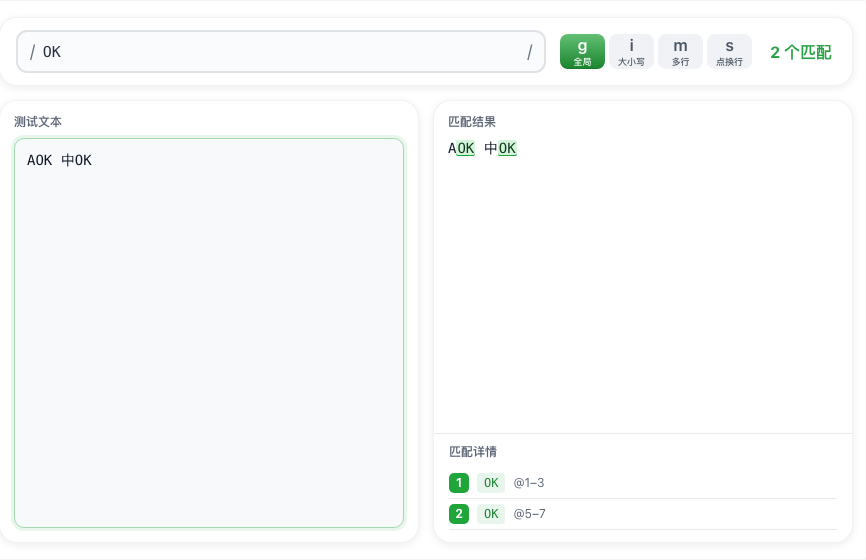
这里包含一个普通空格,“中”在这段测试文本里占一个 UTF-16 代码单元。对照时保持空格和文本完全一致,不要用全角空格替换,也不要在末尾另加换行。
插入一个 emoji,后面的起点增加 2
表达式和选项不变,只把文本改为:
A😀OK 中OK
仍然匹配到 2 个 OK,位置变为 @3–5 与 @7–9。两处起点都比刚才增加了 2,而不是 1。
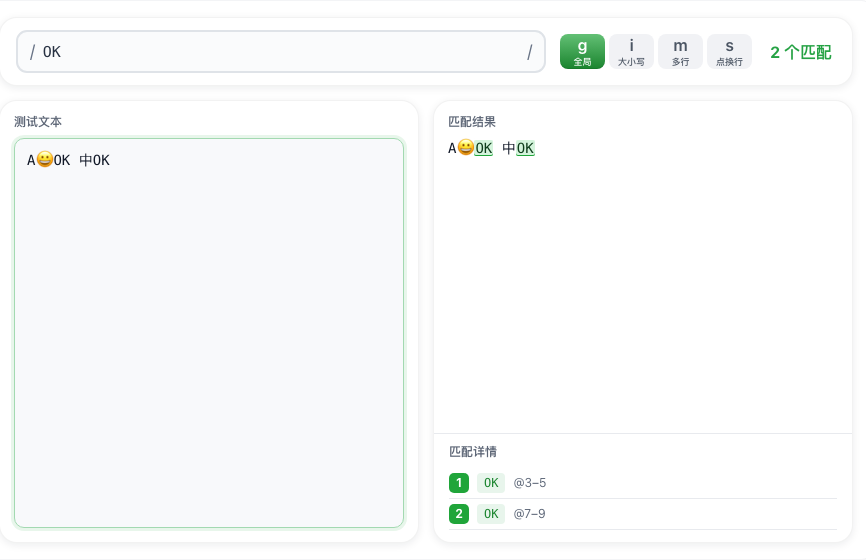
这个 emoji 在 JavaScript 字符串中使用两个 UTF-16 代码单元表示。位置详情记录的是这种索引,屏幕上虽然显示一个表情图形,后面的字符串索引已经向后移动了两个单位。
因此,不要为了让位置与肉眼计数一致,就从结果里机械减去 1。不同文本可能包含不同数量的代理对,也可能包含由多个码点组成的可见图形。先确认调用方要的是字符串索引、码点数量、可见字符数量,还是字节偏移,再决定怎样换算。
直接匹配 emoji,区间跨度仍是 2
保持测试文本不变,把表达式从 OK 改成 😀。本次得到 1 个匹配,显示 @1–3。
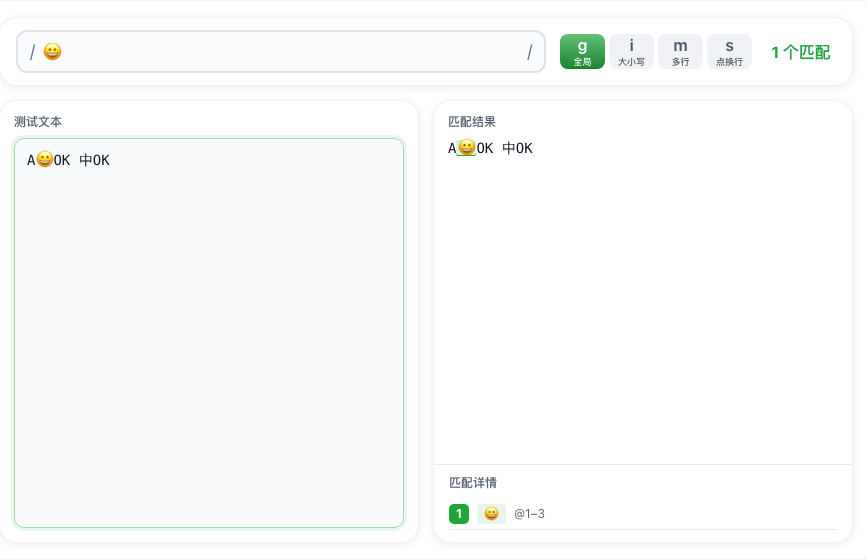
这说明“1 个匹配”与“跨度为 1”是不同概念。一个匹配可以覆盖多个代码单元;它并没有因为区间跨度为 2,就被算成两个匹配。需要在 JavaScript 中截取这次匹配时,应使用同一种字符串索引约定,而不是先按图形个数重新编号。
点号可能把表情拆成两项
把表达式改为 .,测试文本缩短为:
A😀B
仍只开启 g。当前页面显示 4 个匹配:A 为 @0–1,emoji 对应的两个代码单元分别占 @1–2 与 @2–3,B 为 @3–4。结果区里的两个代理半部分显示成了替代图形。
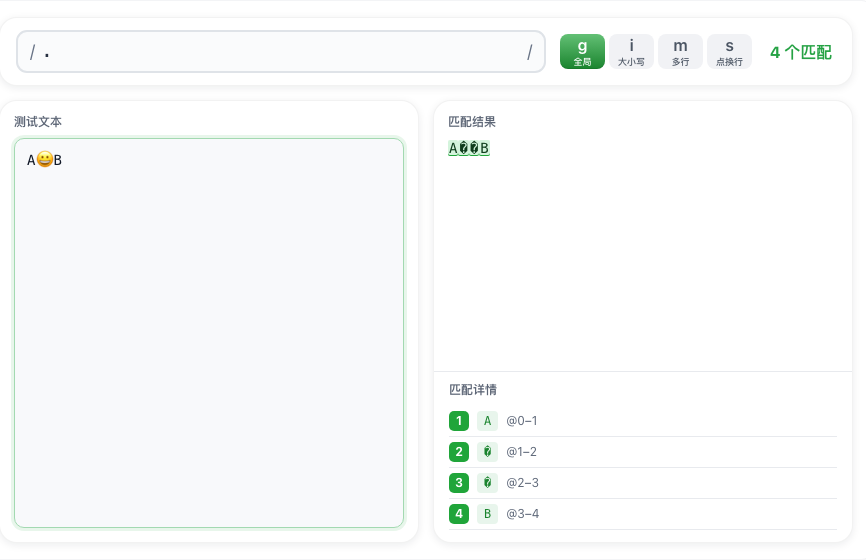
源文本框里的表情仍完整显示,不能看到结果区的替代图形就断定输入文件编码损坏。这里与正则按代码单元匹配有关:当前页面只开放 g / i / m / s,没有 Unicode 模式的 u 选项。打开 s 解决的是点号能否匹配换行,不能用它解决代理对拆分问题。
在支持 Unicode 模式的 JavaScript 程序中,u 可以让此类代理对按完整码点参与匹配。但即使采用该模式,匹配返回的字符串索引仍不能直接当作可见图形序号;例如这个 emoji 的字符串区间依旧可以是 1–3。组合字符的显示计数又是另一层问题。
需要把位置交给前端高亮或字符串截取时,保存原测试文本、表达式、修饰符和索引约定。需要定位到 UTF-8 文件中的字节时,应按文件实际编码重新计算,别直接把这里的 @起点–终点 用作字节范围。
