HTML 实体编码怎么用?< 为什么显示成 <,哪里又防不住 XSS
< 是小于号的实体写法。它出现在源码里、页面上却显示成 <,是因为浏览器解析 HTML 时会先把字符引用还原成字符再渲染;而正文里直接写 <,浏览器会把它当成一个标签的开头。
下面每个输入输出都来自 2026-11-08 在宝塔拨测的 HTML 实体编码 / 解码工具上的一次运行,截图与文字同一次。这个工具分「HTML 编码」和「HTML 解码」两个标签页,页面说明写的是「常用于在页面中展示代码片段」,并注明转换全部在浏览器本地完成、不上传服务器。
为什么源码里是 <,页面上却是 <
HTML 里用字符引用(character reference)表示「这个字符要按文字处理」。MDN 的字符引用词条把它分成三类:命名引用(<、&)、十进制数字引用(<)、十六进制数字引用(<)。三种写法的目标都是同一个码位,浏览器解码后交出的字符相同。
反过来说,如果你想在页面上看到 < 这四个字符本身,源码里就得写 &lt;——先让 & 变成实体,lt; 才会作为普通文字显示出来。
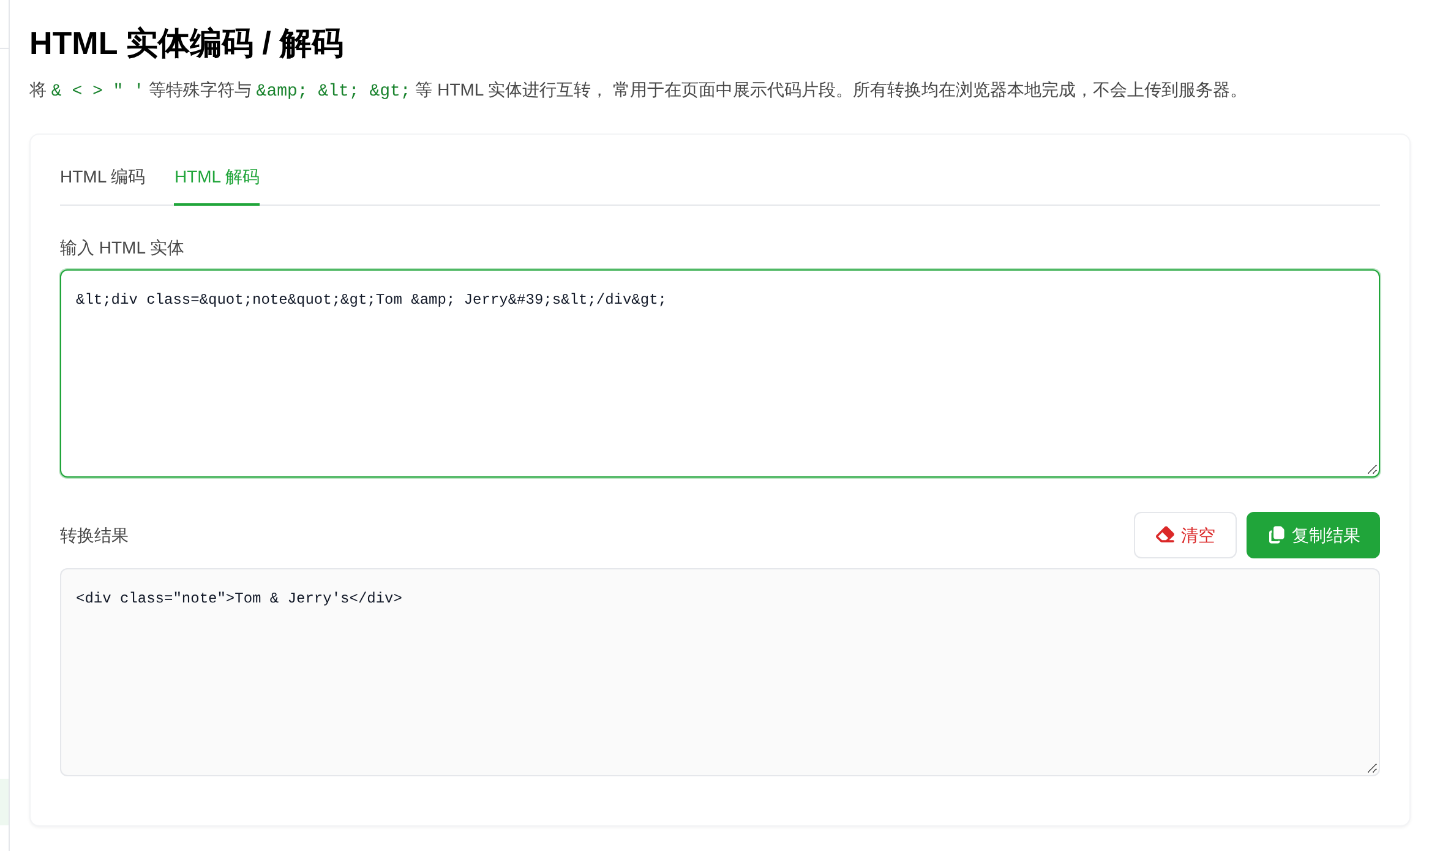
只有 5 个字符会被编码:& < > " '
这是最容易高估的一处。实测输入 <div class="note">Tom & Jerry's</div>,输出是:
<div class="note">Tom & Jerry's</div>
对应关系只有五条:
| 字符 | 输出 | 说明 |
|---|---|---|
& |
& |
先处理它,否则会把后面的实体再编一遍 |
< |
< |
标签开始符 |
> |
> |
标签结束符 |
" |
" |
双引号,属性值可能用得到 |
' |
' |
单引号,输出的是数字实体 |
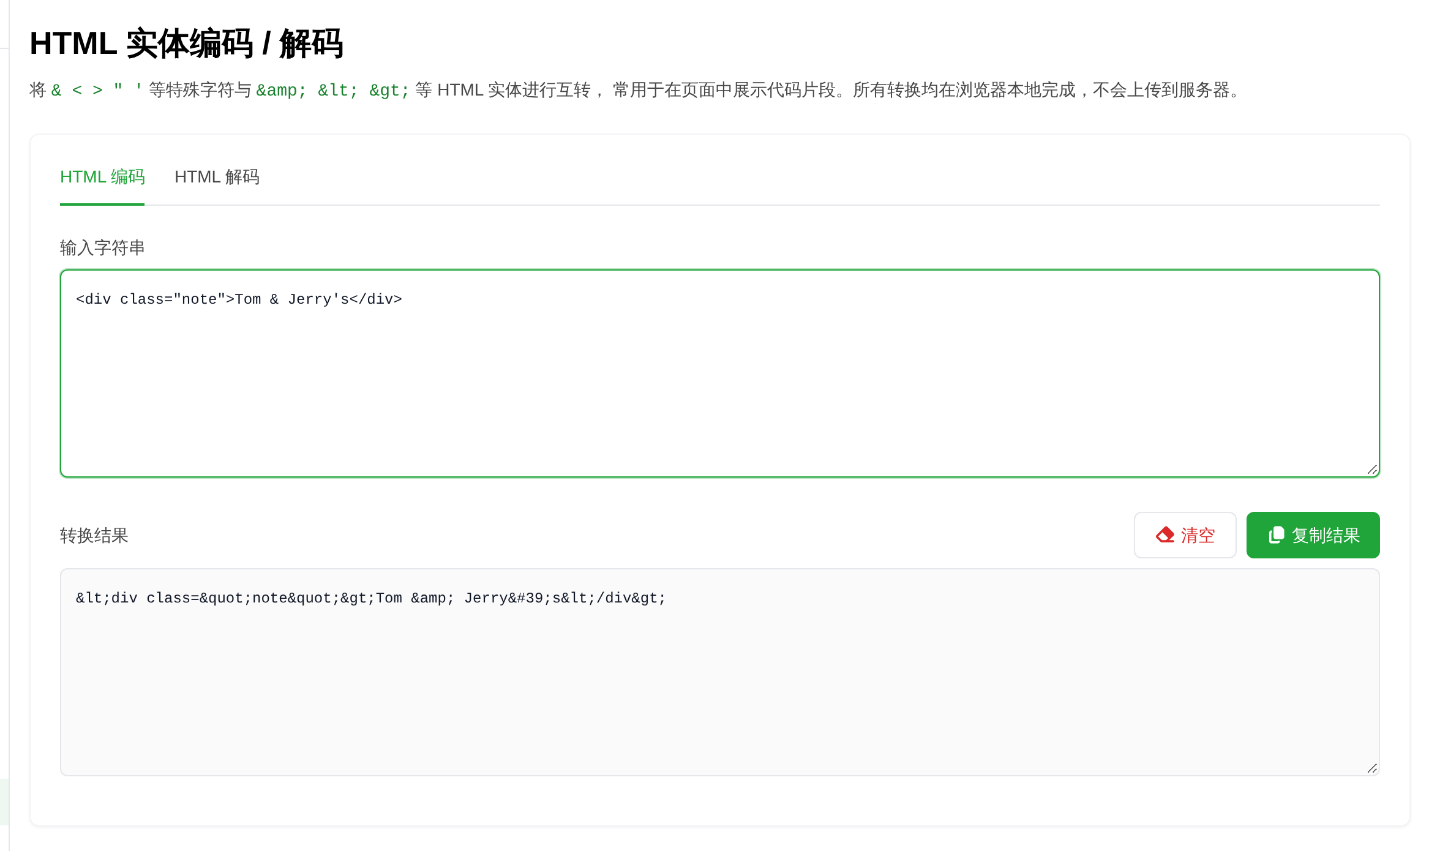
单引号为什么是 ' 而不是 ':39 是 U+0027 的十进制写法,'、'、' 表示同一个字符。实测把 ' " ' 一起解码,三个都还原成了引号——写法不同,字符相同。OWASP 的示例表里单引号写的是 ',和这里的 ' 是一回事。
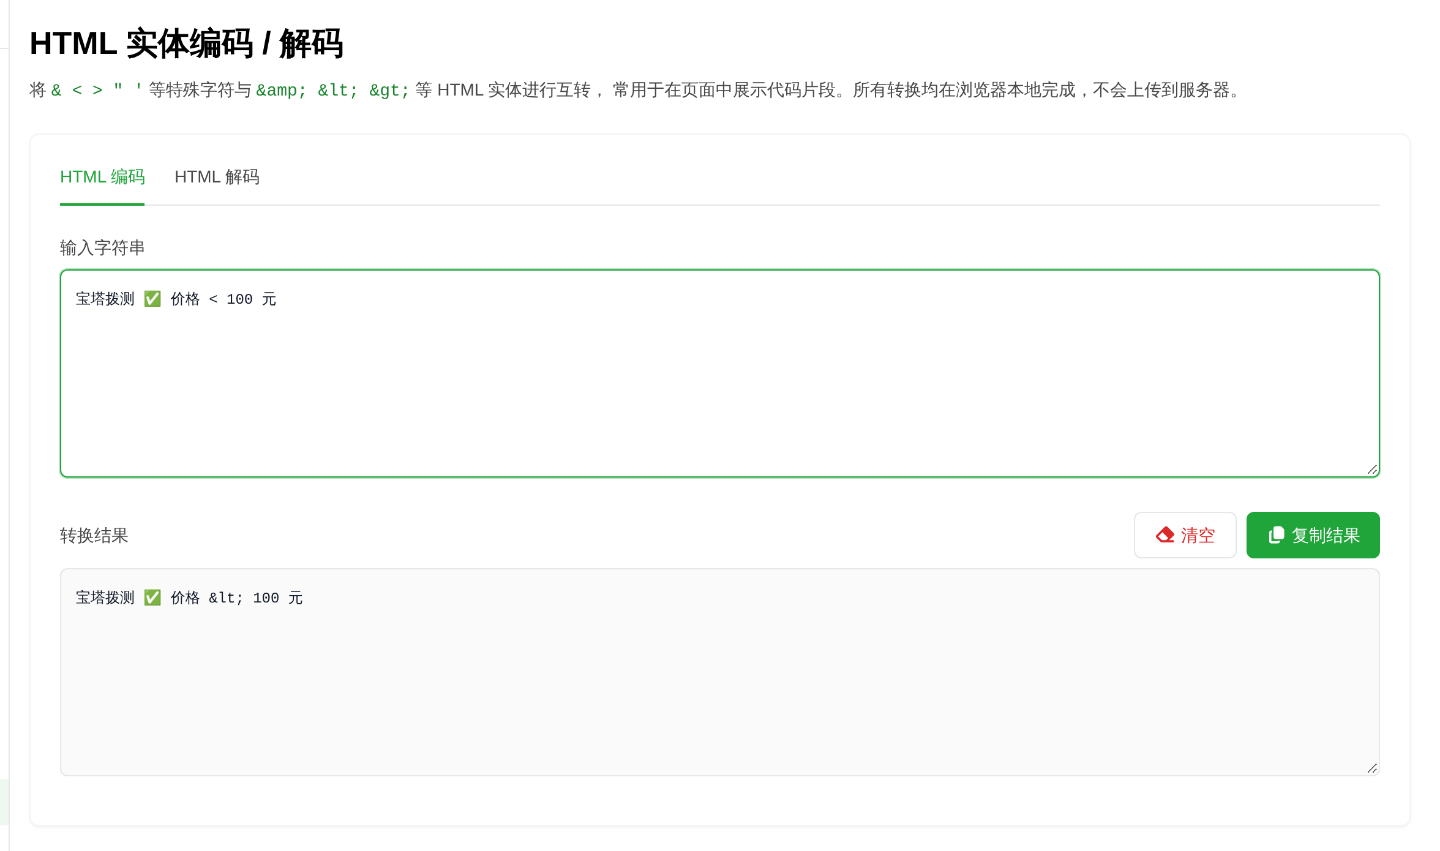
中文、emoji、换行不用转:实测原样通过
同一个编码框里输入「宝塔拨测 ✅ 价格 < 100 元」,输出是「宝塔拨测 ✅ 价格 < 100 元」——只有那个小于号被处理,4 个汉字、1 个 emoji、1 个空格一个字节都没变。
换行和缩进也保留。实测输入两行文本(第一行「第一行」,第二行是两个空格加「缩进 标签」),输出里换行还在、行首两个空格还在,只有标签的尖括号变成了实体。这一点决定了工具能不能直接用来整理代码片段:它只改危险符号,不重排、不压空白。
解码只认一张小表:© 这类解不开
解码方向不是「所有实体都能还原」。工具实际处理的范围是:命名实体 &、<、>、"、'、 ,加上 '、" 这类数字实体,以及任意十进制、十六进制数字引用。
超出这个范围的会原样返回。实测输入「版权所有 © 2026 — 价格 < 100」,输出里 < 还原成了小于号,而 ©、— 一字未动。
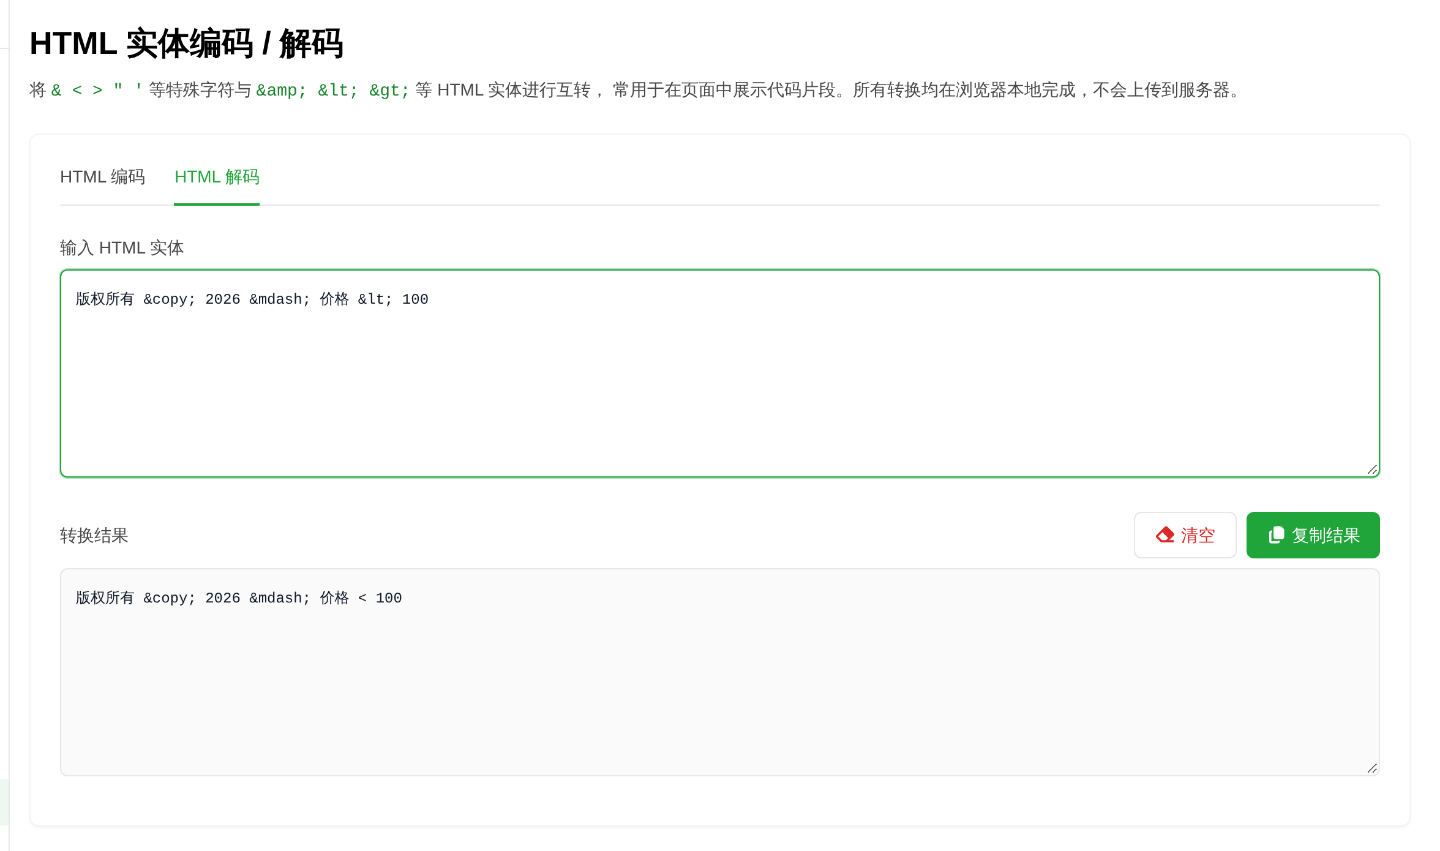
另外两个边界也值得记:
- 区分大小写。实测输入
& <,输出和输入完全一样,大写写法不在识别范围内。 - 格式不完整不处理。实测
&#;、&#xZZ;都原样返回,不会报错,也不会吞掉。
所以解码失败先别怀疑编码出了错,先确认这个实体名在不在支持列表里。
&lt; 只解一层:说明内容被编码了两次
实测输入 &lt;b&gt;,输出是 <b>,不是 <b>。原因很直接:一次解码只把 & 还原成 &,剩下的 lt; 就是普通文字,要再解一次才会变成 <。
反方向也一样。把已经转义好的 <b>已转义</b> 再丢进编码框,输出变成 &lt;b&gt;已转义&lt;/b&gt;——每多经过一次编码,开头就多一层 amp;。
这个现象在实际系统里很常见:模板自动转义一次,另一个环节又转义一次,页面上就显示成 <div> 而不是真正的标签。判断层数的方法很土但有效——数 & 的个数:一层编码是 <,两层是 &lt;,三层是 &amp;lt;。
解出来是普通空格,不是不换行空格
按 MDN 的字符引用表, 对应 U+00A0(NO-BREAK SPACE)。但工具实测把 A B 解成了三个字符:A、空格、B,中间那个的码位读出来是 32,也就是普通空格 U+0020。
两者渲染上都是空白,差别在换行行为:U+00A0 不会在中间断行,U+0020 会。所以拿它还原排版用的不换行空格会失效;真需要 U+00A0,就直接插入这个字符本身,别指望经过一次解码。
数字实体支持中文,但 emoji 这类字符可能解错
中文是可以写成数字实体的。实测 中文 和 中文 的解码结果都是「中文」,两种进制都行。
但超出 U+FFFF 的字符不在这个范围内。实测输入 😀(按 MDN 的定义,这是码位 U+1F600 的十进制写法),输出字符的码位是 62976,即 U+F600,而不是 U+1F600 的 😀。也就是说,这个码位在这个工具里还原成了另一个字符。U+FFFF 以上的数值实体建议逐一核对结果,而且要看码位、不能只看字形——截断后的字符可能长得像别的字。
实用结论:中文、emoji 直接粘原文最稳,数字实体只在「手上只有一串码位、拿不到原字符」时才用,而且用完要肉眼核对结果。
想防 XSS:实体编码只在 HTML 正文这一格管用
上面这些行为说明它是个转换器,不是安全过滤器。OWASP 的 XSS 防护速查表把「HTML 上下文」定义为变量插在两个基本标签之间,比如 <div> $var </div>,这个位置给出的做法就是 HTML 实体编码——正好是这五个字符。
问题在于,同一个变量换个位置,这套字符就不够了:
- 属性值:必须给属性值加引号。属性里的实体同样会被解析,所以引号本身要编码,这一步工具能做。
- 事件处理属性:
onclick=这类属性里的内容会被当成 JavaScript,而 HTML 解析器是先解实体、再交给 JS 引擎的。也就是说,实体编码挡不住事件属性里的代码——OWASP 明确说明,属性编码单独使用保护不了事件处理属性里的 JavaScript,建议改用addEventListener绑定受信任的函数,把用户值当数据传。 - 内联脚本:
<script>里的内容要按 JavaScript 字符串编码,手工把引号替换成实体不是正确做法。 - URL:要按
%HH做 URL 编码,放进href/src时再叠一层属性编码。这两步顺序反了就会出问题。 - CSS:不要直接把变量拼进样式,用
element.style.setProperty()这类接口,属性名固定。
还有两个与工具直接相关的坑:
- 用
setAttribute或textContent赋值时,值是按原样写入的,不会解析 HTML。这时不要先编码——先编码再赋值,页面上就真的显示成<了。 - 允许用户提交 HTML 时,实体编码不判断内容危不危险,要用维护中的 HTML 净化库按允许列表过滤。
一句话总结:实体编码解决的是「内容被当成 HTML 结构解析」,不解决「内容在别的上下文里被当成代码执行」。把它当唯一的防护手段,换个位置就会漏。
这个工具适合干什么
按实测行为,它最适合三类事:写教程时需要把标签当文字展示;怀疑一段内容被转义了两层,用它解一次看结果;从日志、接口返回里拿到一串实体,需要还原成人能读的文字。
转换在浏览器本地完成,页面说明写明不上传服务器,粘内部片段进去不涉及数据出站。
同类工具可以配合看:Markdown 转 HTML 工具讲的是另一头——转换器输出的是 HTML 片段,原始标签原样通过;URL 编码/解码工具处理的是 URL 上下文,规则是 %HH 而不是字符实体。三个放一起,基本覆盖「文本进 HTML」这条链上的编码问题。
常见问题
< 和 < 有什么区别?页面上看起来一样
页面渲染出来是同一个字符,区别在源码和解析阶段。< 是 HTML 的标签开始符,正文里直接写它,浏览器会当成新标签;写成 < 则是字符引用,解析时还原成 < 但按文字显示。所以讲标签本身、贴代码片段时必须写实体,写裸的 < 会把后面的内容吃掉。
HTML 实体编码能防 XSS 吗?
在 HTML 正文(两个标签之间)这个位置,实体编码就是标准做法,OWASP 的 XSS 防护速查表对 HTML 上下文给的就是这一组字符的实体写法。但换个位置就不成立:属性里的事件处理代码、内联脚本、URL、CSS 各有各的编码规则,实体编码不负责这些上下文,也不判断内容本身是否有害。
页面上直接显示了 < 而不是 <,是什么原因?
多半是被转义了两层。实测把 &lt;b&gt; 粘进解码框,一次只得到 <b>,再解一次才变成 <b>。看到页面出现 < 这种字样,先数一层:把这段值再解一次,或者找到重复转义的那一步去掉。
为什么 © 在这个工具里解不开?
工具解码只认一小张表:amp、lt、gt、quot、apos、nbsp 这几个命名实体,加上十进制和十六进制的数字实体。实测输入 © — … ™,输出与输入完全相同,一个都没还原。要解这类版权、破折号符号,得查完整的实体表手工替换。
' 和 ' 是同一个意思吗?
都是单引号 U+0027,只是写法不同。实测把 ' " ' 一起粘进解码框,输出是三个字符:单引号、双引号、单引号。39 是十六进制 0x27 的十进制写法,所以 ' 与 ' 等价;OWASP 的示例用 ',这个工具统一输出 ',字符完全一样。
中文需要写成 中 这种数字实体吗?
不需要。页面用 UTF-8 编码时中文直接写就行,实测把「宝塔拨测 ✅ 价格 < 100 元」粘进编码框,只有 < 变成 <,中文和 emoji 一个字节都没动。数字实体确实支持中文,实测 中文 与 中文 都还原成「中文」,但那是给拿不到原字符的场景用的。