正则只匹配到一处?用 g、i、m、s 核对范围和位置
同一个正则,在一段日志里只找到第一处,换到多行文本又找不到,问题可能在修饰符上。宝塔拨测的“正则测试”把表达式、修饰符、匹配高亮和位置详情放在同一页,可以用一小段测试文本逐项对照。
下面用短文本分别测试 g、i、m、s。每次只保留需要的选项,先确认简单例子的结果,再把表达式用到实际数据里,便于判断差别由哪里产生。
从只找第一处开始
进入“正则测试”,表达式框只填主体 error,不要把两侧的 / 一起输入;页面已经画出了分隔斜线。测试文本填写:
error ERROR error
先把 g、i、m、s 都点到未选中状态。本次页面显示“1 个匹配”,右侧只高亮第一处小写 error,详情是 @0–5。
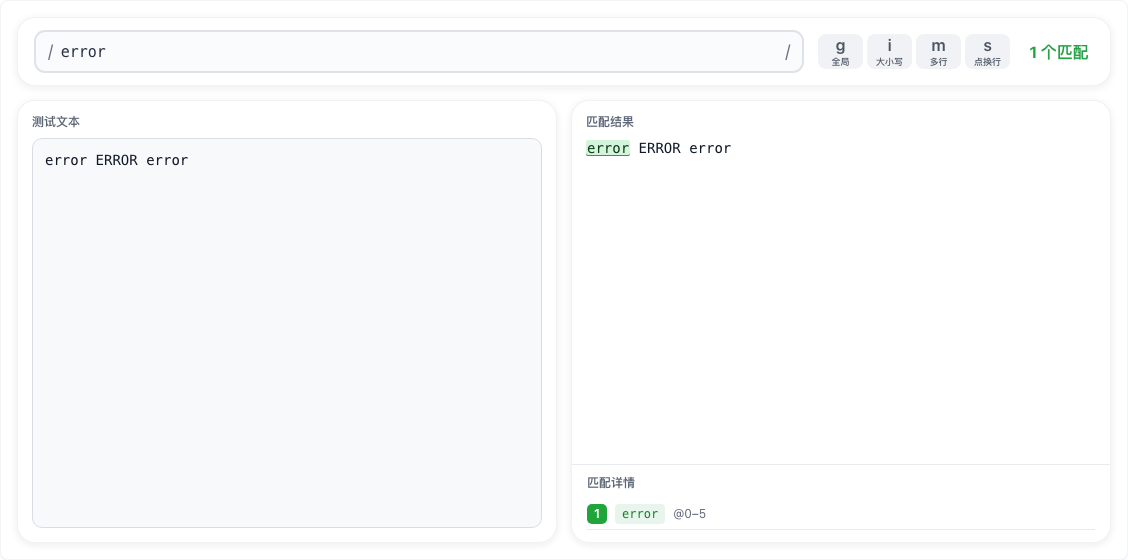
这段例子使用 ASCII 字符,0 是第一处匹配的起点,5 是紧接匹配末尾的位置。也就是从开头取五个字符,而不是“第零到第五个字符一共六个”。查看后续结果时,可以拿实际文字长度核对这种区间表示。
g 控制继续查找,i 控制大小写
保持表达式和测试文本不变,只打开 g,本次得到两处小写 error。继续打开 i,中间的大写 ERROR 也被匹配,结果增加到三处。
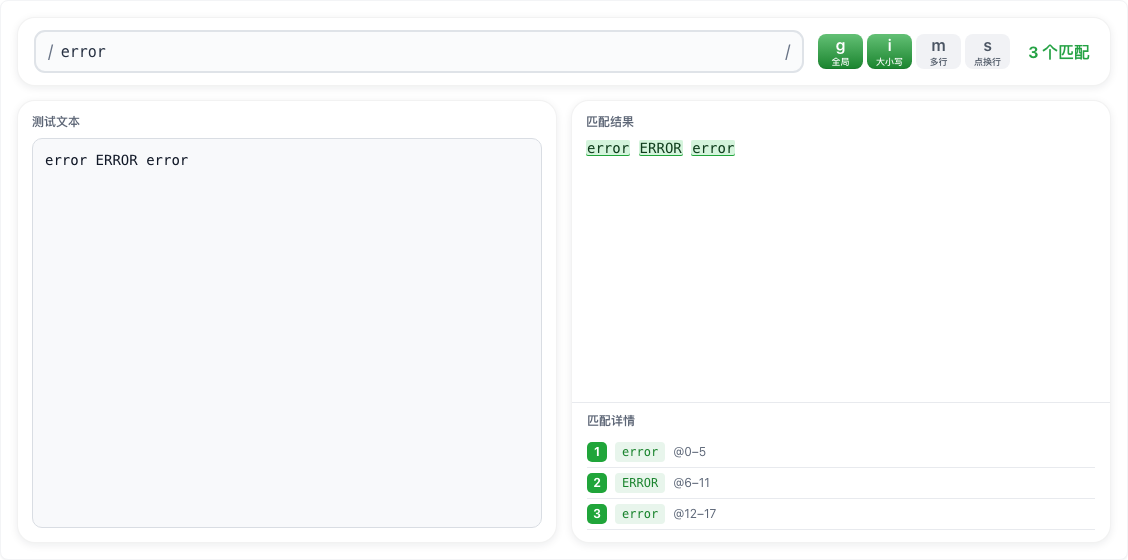
g 用于全局查找,i 用于忽略大小写。它们影响的条件不同:需要找齐全文里的小写词,可以只开 g;希望同一个词的大写、小写都算,再加 i。不要看到结果少就直接修改表达式,先看是不是停在第一处,或大小写没有覆盖。
匹配详情还能帮助发现“看起来匹配了整行,实际只取了一小段”的问题。把高亮文字、匹配数量和区间一起核对,比只看绿色高亮更容易确认范围。
m 影响行首行尾,不负责跨行的点号
将表达式改成 ^error$,测试文本改为三行:
error
ERROR
next
保留 g 和 i,先关闭 m 与 s。本次没有匹配;再打开 m,结果变为两处,分别是第一行和第二行。
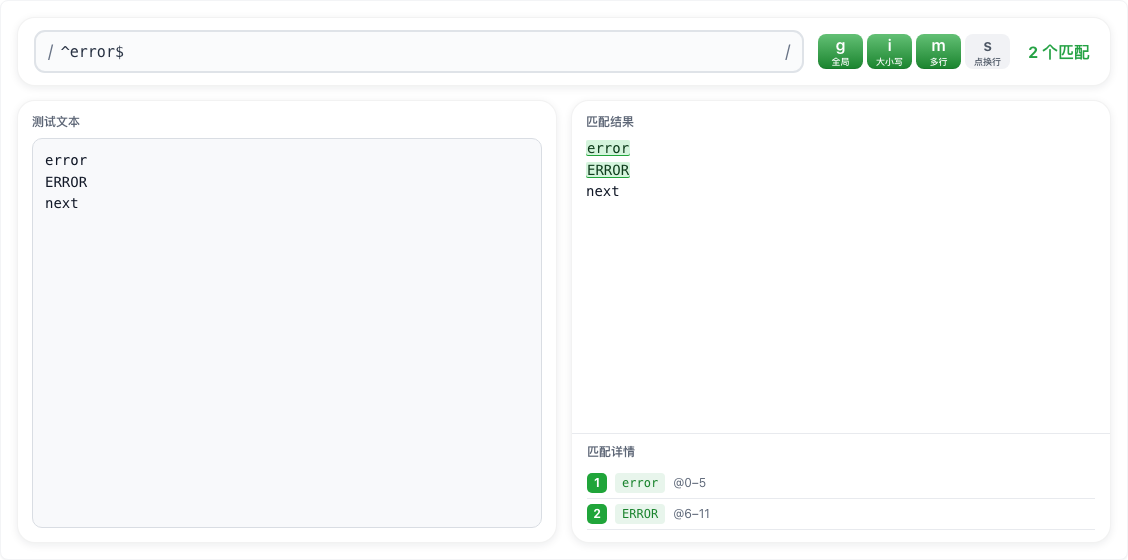
^ 与 $ 在这里限定开始和结束。没有 m 时,这份三行文本整体不符合“只有 error”这个条件;打开 m 后,行首行尾的判断可以落在每一行,因此前两行分别符合。
m 不会让普通的 . 自动跨过换行。想检查一对标记之间包含多行的内容,应另看 s 的作用,不要把“多行”按钮理解成对所有跨行需求都有效。
s 让点号覆盖换行
把表达式改成 BEGIN.*END,输入:
BEGIN
line
END
这次只开 g 时没有匹配;保持其他条件不变,打开 s,本次出现一处匹配,区间为 @0–14,覆盖整段文本。
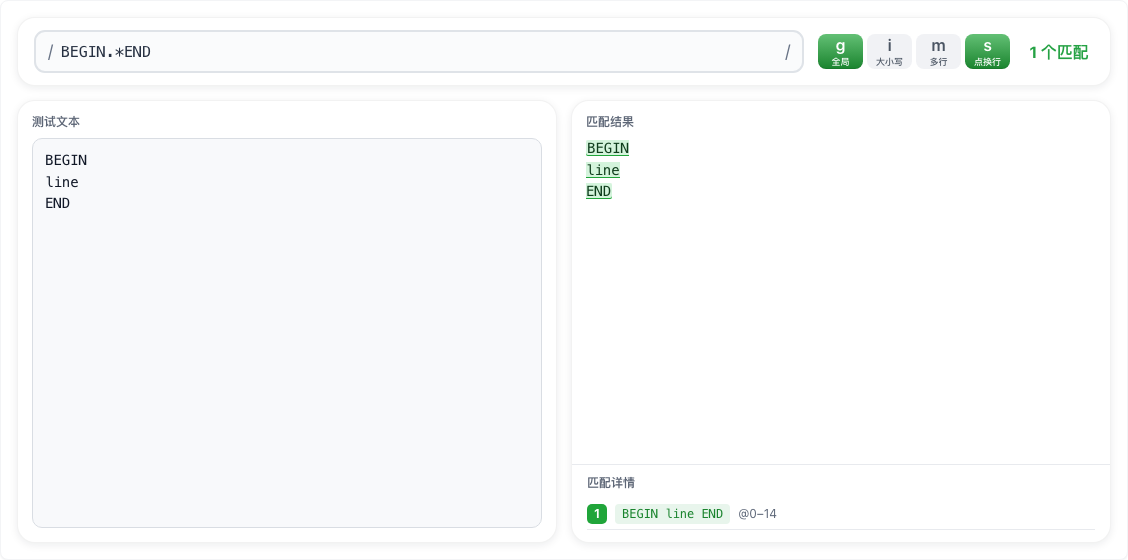
.* 表示让点号重复匹配,s 使点号也能匹配换行。这个例子只有一组开始、结束标记;真实文本如果有多组标记,还要核对是否从最前面的 BEGIN 一直取到了更后面的 END。匹配数量符合预期,也不等于每段范围都合适。
调试时可以按“主体表达式—大小写—是否找齐—行边界—点号跨行”的顺序逐步修改,同时保留一条应该匹配和一条不该匹配的短样本。迁移到其他编程语言或服务配置前,再按目标环境核对正则语法和选项,别仅凭浏览器中的一次结果认定所有环境都一致。
